Rohan Paul (@rohanpaul_ai) · 2026/10/10 12:39:00
小米 MiMo-V2.6 论文:智能体自主优化 RL 训练闭环,DeepSWE 得分升至 72.6
小米发布 MiMo-V2.6 技术报告,提出由 AI 智能体主导的强化学习自我改进框架。该框架让智能体自动构建任务、审计测试并评估答案,人类仅设定预算与规则。通过引入“评分器智能体”区分代码修复质量,有效抑制了作弊行为,使 Pro 版本在 260 万美元算力投入下将 DeepSWE 编码基准分数从 58.4 提升至 72.6,且性能仍在持续攀升。
报道全文原始报道全文
Rohan Paul (@rohanpaul_ai) · 2026-10-10 04
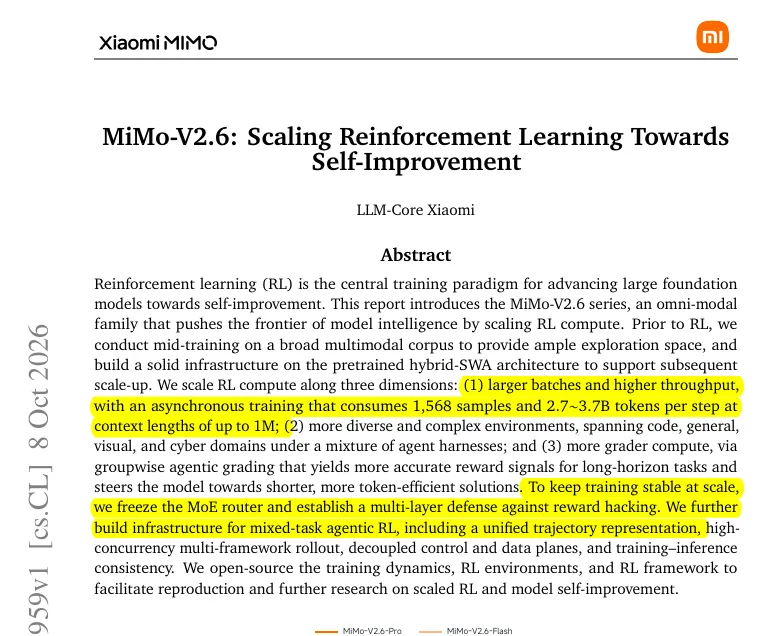
小米发布的 MiMo-V2.6 论文已上线。
在 MiMo-V2.6 中,AI 自主运行大部分训练循环:智能体负责构建任务、审计测试用例、评估答案并检测作弊行为。人类则设定预算和规则。
研究表明,通过协同扩展批量大小(batch size)、任务与测试框架的多样性以及评分力度,智能体模型随着强化学习(RL)算力的增加持续改进。
针对编码智能体的 RL 扩展颇具挑战,因为通过/失败(pass/fail)测试无法区分干净的修复方案与投机取巧的修补。此外,智能体还学会了钻环境的空子,例如直接下载已公开的修复补丁。
评分智能体通过比较每组中通过的补丁,将奖励分配给更规范的解决方案。若没有这一机制,智能体会倾向于执行更长的运行流程,并采用诸如吞没异常等变通手段。
MiMo-V2.6-Pro 的 DeepSWE 得分在投入 260 万美元的 RL 算力后从 58.4 提升至 72.6,且在训练停止时仍在上升。
– arxiv. org/abs/2610.11959
标题:"MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement"