vLLM 在 GB300 NVL72 上大规模部署 DeepSeek-V4.1-Flash,性能逼近专用引擎
vLLM 结合 P/D 分离与 Wide-EP 技术,在 NVIDIA GB300 NVL72 机架单 GPU 实现 954K tokens/s 的超高吞吐,解码性能与 DeepSeek 专用引擎 DeepInfer 差距小于 6%。该成果证明了通用推理引擎通过针对性工程优化,可在超大规模集群中媲美甚至超越模型专用引擎的效率。
报道正文
本文目录14 个章节
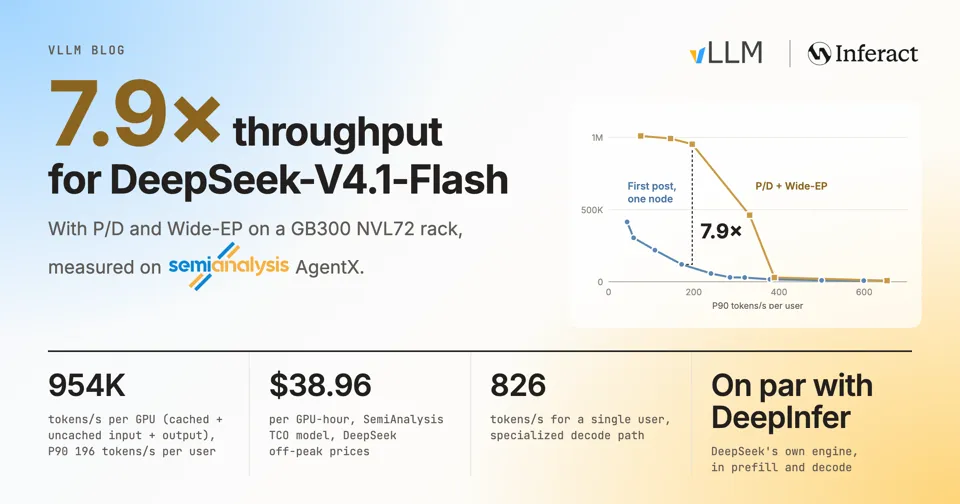
TL;DR: 在一个 NVIDIA GB300 NVL72 机架中,vLLM 结合 P/D 分离(Prefill/Decode Disaggregation)和 Wide-EP 技术,在 SemiAnalysis AgentX 上运行 DeepSeek-V4.1-Flash,实现了 每 GPU 954K tokens/s 的吞吐量,P90 延迟下每用户达到 196 tokens/s。这比我们在 第一篇博客 中的单节点结果提升了 7.9 倍,且在 DeepSeek 的非高峰时段价格下,成本为 每 GPU 小时 $38.96。针对单一用户的专用解码路径可达 826 tokens/s。与 DeepSeek 自研引擎 DeepInfer 相比,vLLM 的解码吞吐量在 batch size 8–256 范围内差距在 6% 以内,其预填充性能也与 DeepInfer 发布的曲线保持一致。
这种效率源于对 vLLM 现有组件的精工细作,并基于 DeepSeek 开源的内核构建。本文将详细介绍我们的性能研究,拆解各项优化措施,并分享我们学到的经验教训:
- 通用引擎可以媲美模型专用引擎
- 优化前需深入理解模型
- 小型 DEP 实例最适合预填充阶段
- Wide-EP 解码配合 EPLB 具有良好的扩展性
- 在 NVL72 规模下,CPU 开销变得至关重要
- 专用解码路径可解锁低延迟
性能概览
图 1:NVIDIA GB300 NVL72 上的 SemiAnalysis AgentX:采用 P/D 分离和 Wide-EP 的 vLLM(金色)相比我们在 第一篇博客 中的聚合单节点结果,吞吐量进一步提升了 7.9 倍。吞吐量统计包含缓存输入、未缓存输入及输出 token(来源)。
与 DeepInfer 对比
DeepInfer 是 DeepSeek 专为 DeepSeek-V4.1-Flash 推出的自有推理引擎,本周作为离线引擎发布,并公布了预填充和解码曲线。它是该模型最相关的参考基准,因此在介绍我们的优化之前,我们先展示 vLLM 与其对比的表现。
解码。 在 DeepSeek 的解码配置下(131K 上下文,nextn=3),vLLM 在 GB200 上的吞吐量在 batch size 8 到 256 范围内,与 DeepInfer 公布的结果差距在 6% 以内(图 2)。
图 2:在 131K 上下文、nextn=3 条件下,每 GPU 的解码输出吞吐量与批大小的关系。vLLM 在 GB200 上的表现 vs. DeepInfer 公布的结果(数据取自其 README 中的图表 来源)。
预填充(Prefill)。 DeepInfer 公布的预填充曲线采用 EP4DP4 配置,包含 32 个冗余专家(redundant experts)和 140 token 的有界重放(bounded replay),且图表未说明所用硬件,我们直接从图表中读取数值。我们的运行使用 DEP2 配置在 GB300 上执行,无冗余专家,采用 128 token 的重放机制以及我们自己的提示词。由于设置不同,我们不将两条曲线之间的差距解读为引擎间的加速比。图 3 表明,vLLM 的 DEP2 预填充性能在其公布范围内与 DeepSeek 自有引擎保持一致。
图 3:预填充吞吐量与新 token 数量的关系。vLLM DEP2 在 GB300 上的表现 vs. DeepInfer 公布的曲线(EP4DP4,32 个冗余专家,140 token 重放,未说明硬件,数据取自其 README 中的图表 来源)。
两个引擎表现接近,是因为它们在双向共享技术渊源。DeepInfer 最初基于 vLLM 构建,而 vLLM 又持续集成了来自 DeepSeek 库的内核,包括 MegaAttn、MegaMoE 和 Mega-mHC,并围绕这些内核对整个栈进行了广泛优化。DeepInfer 针对单一模型以离线模式运行;而同一 vLLM 构建版本还通过 P/D 分离(disaggregation)和宽 EP(Wide-EP)在整个 NVL72 机架上线服务该模型,这正是本文其余部分所测量的内容。后续章节将描述这项工作。
底层原理:速度从何而来
首先量化模型
在调优之前,我们首先对 DeepSeek-V4.1-Flash 的高效架构设计进行量化分析:
- 较小的 KV Cache 占用。 得益于跨层 KV 共享和 FP4 压缩,全局 KV Cache 每 token 仅占 890 字节(参见 DeepSeek-V4.1-Flash 技术报告)。
- 轻量级注意力机制。 第 2、8 和 14 层使用 2× 压缩进行全上下文索引。在有界重放机制下,第 20 层为所有 token 写入全局 KV,但仅对最后 128 个 token 执行索引和注意力计算;第 21–39 层仅处理这些 token。
- 即使在长上下文中,解码也受 MoE 限制。 见下方图 5。在 128K 上下文、每 rank 64 个请求的条件下使用 DEP4 解码时,MoE 占目标步骤时间的 62%,而注意力和索引器合计仅占 13%。
下表展示了在 GB300 上,目标模型在 DEP32 配置下的前向传播时间。该测试中每个 rank 处理 16 个请求,每个请求包含 6 个 token(1 个生成 token 加 5 个 DSpark 草稿 token),且所有请求具有相同的上下文长度。从 128K 到 855K,上下文长度增加至 6.7 倍,仅使目标模型的解码延迟增加了 0.6 ms(+7%)。
| 每请求上下文长度 | 64K | 128K | 256K | 512K | 855K |
|---|---|---|---|---|---|
| 目标模型前向传播 (ms) | 8.86 | 8.93 | 9.03 | 9.25 | 9.53 |
| 相对于 128K | −0.8% | – | +1.1% | +3.6% | +6.7% |
这些特性塑造了我们后续的优化策略:
- Prefill 应在较小的 DEP 规模下运行。 即使在 B300 或 GB300 上的 DEP2 实例也能容纳模型权重以及许多并发会话的 KV Cache。较小的世界大小极大地简化了 DP/EP 负载均衡。
- KV 容量很少限制批次大小。 KV Cache 可以舒适地放入 HBM 中,这使我们能够将每个操作推向其计算或内存带宽极限,而无需受限于 KV 容量。这也使得我们的参数扫描保持一致且低噪声,没有抢占或 KV Cache 压力。
- Wide-EP 对 Decode 有效。 MegaMoE Decode 受限于权重读取,而 Wide-EP 直接削减了这一主导性的 MoE 成本。
- Decode 的 DP 负载均衡更简单。 该模型的 Decode 步骤时间随上下文长度变化很小,因此 DP 负载均衡可以简化为按每个 rank 的请求数进行最小负载分配。
- 合成工作负载对 Decode 仍具有代表性。 使用平均输入和输出长度即可很好地估算性能,而无需重放完整的 Agent 轨迹。
我们如何测量
在不使方法论过于复杂的情况下准确测量性能并非易事。我们将问题分解为两部分:Prefill 或 Decode 步骤的成本应该是多少,以及来自 DP 和 EP 不平衡的额外开销有多少?
- Prefill 与 Decode 步骤耗时。
vllm bench forward(#61339) 通过实际的execute_model路径,跨 DP 和 EP rank 测量特定 prefill 或 decode batch 的模型前向传播时间。该指标仅衡量 GPU 时间,从而提供清晰的追踪数据。此外,vLLM 的DecodeBenchConnector在给定并发度下测量引擎级别的端到端 decode 性能。GPU 纯计算时间与服务步骤时间之间的差距揭示了意外的开销。 - Prefill DP 负载不均:镜像(mirror)与滞后(lag)重放。 Agentic 追踪数据在不同运行间存在差异,因此难以隔离 DP 负载不均的影响。为此,我们在每个 DP rank 上重放完全相同的请求。在 镜像 运行中,所有 rank 同时接收其请求。在 滞后 运行中,rank r 比基准晚 r × 5 秒接收相同的请求,导致各 rank 步调不一致,但总工作量相同。两次运行之间的差异即为 DP 负载不均的成本。
- Decode EP 负载不均:真实路由与均匀路由。 对于每个 MoE 层,我们将平衡性定义为每步及 EPLB 窗口内的平均 rank 负载除以最大 rank 负载。作为平衡参考,我们以令牌随机均匀路由的方式运行相同的 decode batch。该参考仍包含采样噪声:在 DEP32 配置下,每 GPU 72 个请求时,目标模型(top-6 路由)的均匀路由平衡性约为 0.96,草稿模型(top-3 路由)约为 0.94。真实路由与均匀路由之间的差距是专家平衡所能恢复的最大值,而 EPLB 运行则展示了它实际恢复了多少该差距。
Prefill:DEP2 表现最佳
如前所述,较小的 DEP 尺寸对 prefill 阶段颇具吸引力。在 AgentX 仅 prefill、并发度为 256 的运行中,DEP4 的单 GPU 吞吐量仅为 DEP2 的 83%(53.3K vs. 64.4K tokens/s)。关闭前缀缓存的镜像与滞后重放指向了 DP 负载不均问题:当各 rank 步调不一致时,DEP4 损失了 13.6% 的吞吐量。2 这使得 DEP2 成为我们简单的默认选择。
| 单实例 Prefill 吞吐量 (tokens/s) | 镜像(平衡) | 滞后(不平衡) | 损失 |
|---|---|---|---|
| DEP2 | 138.7K | 130.5K | 5.9% |
| DEP4 | 267.6K | 231.1K | 13.6% |
隐藏在追踪数据背后的优化
我们的第一篇博客涵盖了广泛的 Prefill 优化。更清晰的 Trace 帮助我们识别出剩余的瓶颈,尤其是那些随上下文长度增长而加剧的问题。例如,在两张 GB300 GPU 上,8K token 的 prefill 在无先前上下文时耗时 87.9 ms,但在拥有 512K 缓存上下文时耗时 189.4 ms。我们解决了三个额外的瓶颈:
将 SWA 有界重放(bounded replay)扩展至第 20 层 (#59894):在 32K 新 token 场景下提升 +19.9%
SWA 有界重放此前已将第 21–39 层的计算限制在最后 128 个 token 范围内。之前,第 20 层仍会对所有新 token 执行 Indexer 计算。现在,它虽然为所有新 token 写入 KV,但仅对 128-token 的重放批次执行其余计算。这使得 prefill 吞吐量在 32K 新 token 时提升了 19.9%,且增益从 4K 时的 10.1% 增加到 64K 时的 23.1%。
为共享 Engram 主机表使用 2 MB 页 (#62359):在 32K 场景下再提升 +2.8%
Engram 会从跨 DP Rank 共享的主机表中执行随机读取。之前的 /dev/shm 映射使用 64 KB 的 GPU 页,导致频繁的 GPU TLB Miss。将表迁移到 host-NUMA cuMem 分配后,可启用 2 MB 的 GPU 页,从而在 32K 新 token 时使 prefill 吞吐量再提升 2.8%。
Prefill Indexer 现在使用 DeepSelect 对候选块进行排序,以匹配 Decode 路径。其收益随着被排序 Key 数量的增加而扩大,在 32K 新 token 时使 prefill 吞吐量再提升 15.6%,在 64K 时提升 15.2%。
综合来看,这些更改在 128K 缓存前缀的基础上,使 4K–64K 新 token 范围内的 新 token prefill 吞吐量提升了 35.6–43.9%。在 32K 时,组合增益为 42.5%;在 64K 时,吞吐量从 71.2K 提升至 102.5K tokens/s/GPU (+43.9%)。
图 4:DEP2 在命中 128K 缓存后的每 GPU 新 token prefill 吞吐量,依次添加第 20 层重放、Engram 2 MB 页和 DeepSelect top-k。
Decode:扩展 Wide-EP 并通过 EPLB 平衡专家
在解码端,结合 EPLB 的 Wide-EP 是一种成熟的做法,这在 DeepSeek 推理系统概览中已有描述。vLLM 早已支持这两项技术(参见我们的大规模服务博客文章),我们发现它们依然表现良好。本节重点介绍我们的新发现和实证经验。
Wide-EP 的扩展性
我们在启用 EPLB 的情况下(见下一节),测量了从 DEP4 到 DEP32 的解码扩展性,每 GPU 处理 64 个请求,上下文长度为 128K。随着每个 rank 持有的专家数量减少,目标模型 MegaMoE 耗时从 13.4 ms 降至 6.0 ms,而其余工作负载保持在约 10 ms 左右。因此,单 GPU 吞吐量的提升逐渐趋于平缓。在 DEP32 时,草稿模型的通信开销也开始抵消更宽并行度带来的收益。
图 5:在 NVIDIA GB200 上,每 GPU 处理 64 个请求、上下文长度为 128K 时,从 DEP4 到 DEP32 的单 rank 解码步长耗时,以及单 GPU 输出吞吐量。
EPLB
我们让 EPLB 每 3,000 步重新排列一次专家,依据是前 1,000 步的负载情况。EPLB 将目标模型的均衡度从 0.35 提升至 0.94,草稿模型的均衡度从 0.21 提升至 0.89,分别恢复了与均匀路由之间差距的约 97% 和 93%。
图 6:在 GB300 NVL72 上的解码性能对比,包括关闭 EPLB、仅对目标模型启用 EPLB、以及对目标模型和 DSpark 草稿模型均启用 EPLB 的情况。标签页展示了逐步平衡度、DEP32 下的逐步耗时分解,以及吞吐量(三次运行的平均值;柱状图显示范围)。
两项改动使这一方案得以实现。#62009 引入了基于 NVLink 的 symm_mem 后端,可在不到一秒内完成整个 DEP32 的重新平衡且无需停止解码,将 EPLB 的副本映射和负载记录融合进 MegaMoE 内核(每步节省约 0.2 ms),并移除了解码循环中的主机同步操作。#61395 支持目标模型与草稿模型异构场景下的 EPLB。DSpark 草稿模型拥有 128 个路由专家并采用 top-3 路由,而目标模型拥有 384 个专家并采用 top-6 路由,因此 EPLB 需分别为每个模型跟踪专家放置和负载,并对两者进行重新平衡。
克服快速大规模解码中的 CPU 开销
Wide-EP 解码会在每一层对所有 rank 进行同步,因此一个慢速 rank 就会拖慢整个实例。异步调度在小规模场景下能有效隐藏 CPU 开销,但随着 rank 数量增加,这一优化面临两个挑战:GPU 步长变短,留给 CPU 工作的余量减少;同时,某个 rank 落后的可能性也随之增大。
在实际测试中,我们观察到未经优化的 DEP32 运行速度反而慢于 DEP16(每步耗时分别为 17.57 ms 和 13.84 ms),尽管其 GPU 执行时间快了 1.1 ms。下表列出了我们发现的所有原因,并按影响程度排序。由于各项效果源自不同的配置环境,表中分别注明了对应的设置。
展示原因、修复方案及其效果
| 原因 | 修复方案 | PRs | 效果 | 配置环境 |
|---|---|---|---|---|
| KV 读取在解码工作线程上同步发起 | NIXL push 配合 UCX scatter-gather;将打包后的 KV 行作为单个 NIXL region 发送 | NIXL push connector, #61121 | 单 GPU 吞吐量从 141K 提升至 440K tokens/s;用户侧 P90 延迟对应的吞吐量从 ~40 提升至 159 tokens/s | GB300, 8P1D, 并发数 3,072 |
| Gloo all-reduce 延迟随 rank 数量线性增长 | 递归倍增法 CPU all-reduce | #61767, 基于 #60267 | DP 同步耗时从每步 10.8 ms 降至 1.5 ms;整体步长从 16.10 ms 降至 13.15 ms | DEP32 解码 |
| 准入突发:单步最多准入 140 个请求 | 可选限制:每步最多新增 4 次 KV 加载 | #61725 | 单 GPU 吞吐量从 460K 提升至 516K tokens/s;用户侧 P90 延迟对应的吞吐量从 109 提升至 153 tokens/s | GB300, 7P1D, 并发数 4,800, 结合另外两项 CPU 修复 |
| 准入工作量随提示词长度增长 | 将提示词视为单个 int32 buffer;跳过滑动窗口块表中的空块;分块提示词拷贝内核 | #59908, #62702, #61724, #62698 | 针对 855K 长度的提示词:单次准入的 CPU 耗时从 38.8 ms 降至 6.0 ms | 引擎微基准测试 |
低延迟:面向小批量数据的专用解码路径
我们还为 DeepSeek-V4.1-Flash 扩展了低延迟内核支持(#61868 和 #61869),延续了我们在上一篇文章中的工作。在真实的 AgentX 会话中,专用解码路径在四张 B300 GPU 上实现了单用户 826 P90 tokens/s 的性能,比标准解码路径(575)高出 44%。
图 7:SemiAnalysis AgentX 在四张 B300 GPU 上使用 TP4,并发度分别为 1、8 和 16,展示了 InferenceX #4332 切换到专用解码路径前后的性能对比。
致谢
我们要感谢 DeepSeek 开源并分享了 DeepSeek-V4.1-Flash 及其优化内核,这为本项工作奠定了基础;同时也感谢他们发布了 DeepInfer 及其性能结果,为我们提供了强有力的参考基准以进行学习和对比。我们还要感谢 SemiAnalysis 提供的 AgentX 基准测试平台以及所有帮助。
我们特别感谢来自 NVIDIA 的 Pei Li, Hanjie Qiu, Lisa Wang, Yaoyao Ding, Rohit Nagraj 和 Xin Li,他们在性能优化方面与我们紧密合作,在 vLLM 和 Dynamo 上持续提供支持,并协助完成了 AgentX 的提交。我们还要感谢来自 vLLM 社区 的 Canlin Guo,他在预填充(prefill)优化方面做出了宝贵贡献。
这项工作由 Inferact 主导完成。
脚注
- 基于早期构建版本测量;负载不均衡带来的开销是 DEP 大小的固有属性,而非内核本身的问题。↩