Buoyant 开源 Kinference:vLLM 与 K8s 推理控制平面
Buoyant 推出开源项目 Kinference,旨在为基于 vLLM 和 Kubernetes 的推理平台提供控制平面层。该工具支持 OpenAI/Anthropic 兼容接口,集成令牌限流、租户成本追踪及智能负载均衡等功能,并在多轮对话负载中实现了约 3.5 倍的有效吞吐量提升。
报道正文
本文目录2 个章节
推出 Kinference:面向 vLLM 和 Kubernetes 的开源推理控制平面
我们很高兴地宣布 Kinference [kay-inference],这是一个用于构建基于 vLLM 的可扩展推理平台的新开源项目。
Buoyant 出品的 Kinference
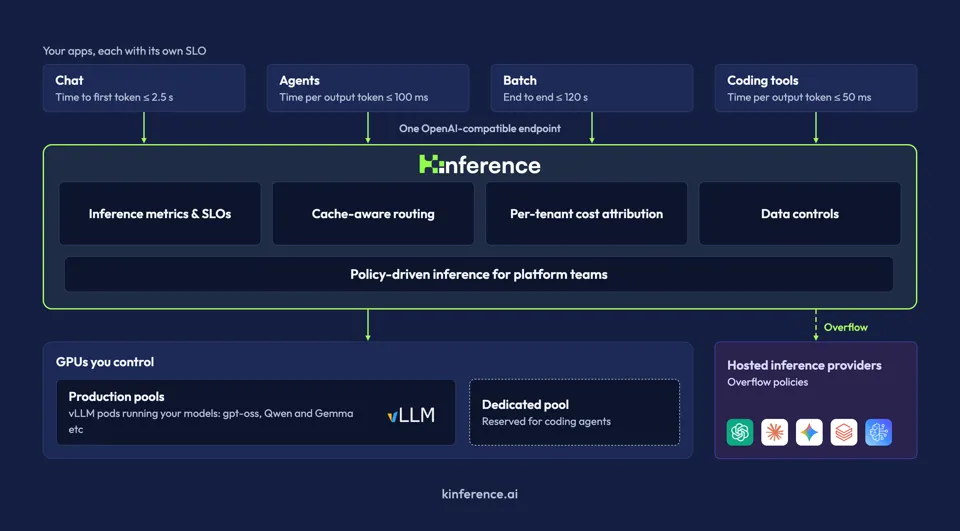
我们在 Buoyant 创建了 Kinference,此前我们观察到客户在各自环境中运行开放权重模型时面临诸多困难。我们将 Kinference 设计为您所需平台的控制平面层。它利用 vLLM 执行底层推理,并提供了在实际构建推理平台时所需的一系列功能,包括令牌速率限制、租户用量与成本追踪、智能负载均衡以及推理策略。
Kinference 架构
Kinference 可以与您现有的技术栈配合使用。使用 Kinference 只需将推理客户端指向其 HTTP 端点,并向该端点发送兼容 OpenAI 或 Anthropic 格式的推理流量即可。
Kinference 服务于一个异构且不断演进的模型集合,这些模型运行在一个异构且不断演进的 GPU 资源池上,并为一个异构且不断演进的客户端集合提供服务。
推理负载均衡与性能
除了策略和路由层之外,Kinference 还提供了针对推理场景优化的负载均衡机制,该机制会综合考虑 GPU 队列大小、历史性能表现以及 GPU 上 KV Cache(键值缓存)的内容等信号。特别是这种对 KV Cache 的感知能力,使得 Kinference 能够将请求发送给处理该特定请求工作量最小的 vLLM worker。
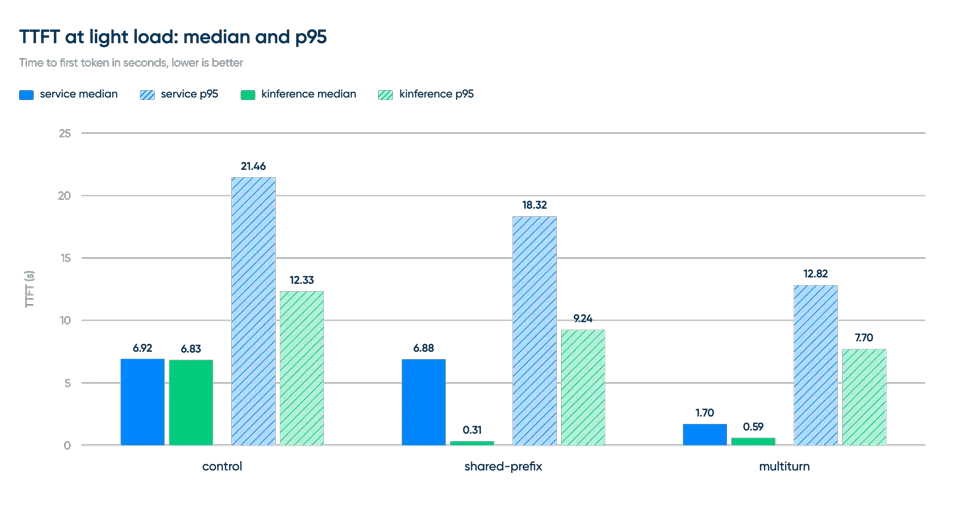
对 GPU 中 KV Cache 内容进行建模可以为分布式推理带来显著的性能提升。例如,在我们的 公开 Kinference 基准测试 中,我们展示道,与标准 Kubernetes 负载均衡(下文标记为 “service”)相比,Kinference(下文标记为 “kinference”)在一种工作负载类型上将首令牌生成时间(TTFT)的中位数降低了 95%,并将端到端延迟的中位数降低了 45%。
轻负载下的首令牌生成时间
通过将缓存感知机制纳入策略,平台所有者可以制定这样的策略:将简单请求路由到成本更低的模型——但前提是这样做比一开始就将这些请求发送到昂贵模型所消耗的工作量更少。
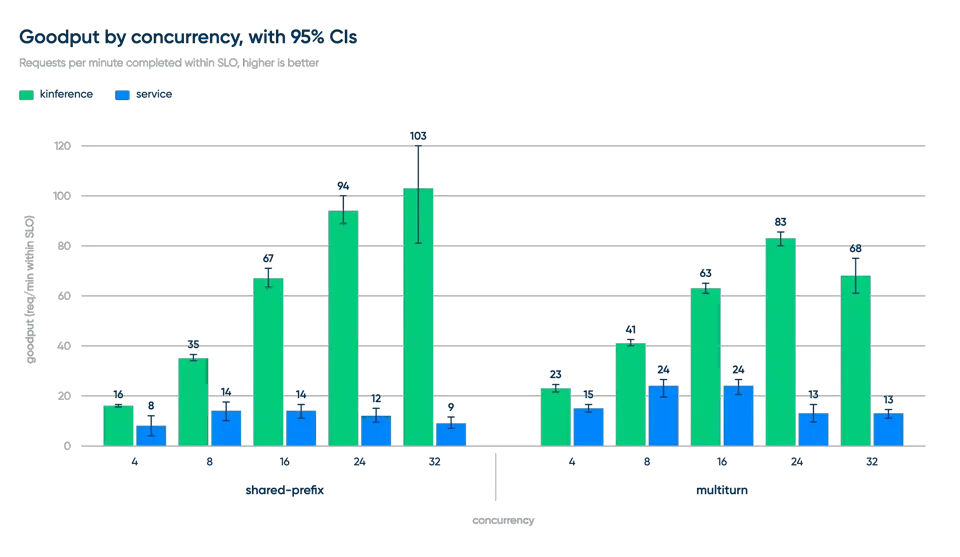
在上述 无负载延迟 基准测试中,我们旨在单独衡量 Kinference 的 KV 缓存感知负载均衡的效果。在下方的 容量 基准测试中,我们测量了每个端点在满足延迟 SLO(服务等级目标)的前提下每分钟可处理的请求数。
按并发度划分的 Goodput(有效吞吐量)
在容量基准测试中,Kinference 在共享前缀场景下实现了 7.4 倍 的有效吞吐量,在多轮对话场景下实现了约 3.5 倍 的有效吞吐量。在共享前缀工作负载下,它能够在并发度为 32(测试中的最高值)时达到我们设定的 SLO;而在多轮对话工作负载下,它在并发度为 8 时即可达到该 SLO。相比之下,kube-proxy 方案在任何并发级别下均无法达到该 SLO。