AI 基准测试失效:从 MMLU-Pro 看评测困境
文章指出当前主流 AI 基准测试(如 MMLU-Pro)存在数据污染、题目无意义及校准缺失三大缺陷,无法真实反映模型智能水平。作者呼吁摒弃“像人一样做题”的静态评估范式,转向更具动态性和任务导向的面试式评测方法。
关联知识实体
报道正文
本文目录3 个章节
鉴于开发新 AI 所投入的巨大精力——无论是字面意义上的还是比喻意义上的——我们却很难准确衡量它们究竟有多“聪明”。最常见的做法是将 AI 视为人类,通过测试来评估其表现,并统计答对题目的数量。这类测试被称为基准测试(benchmarks),目前有数十种之多,它们是衡量 AI 能力随时间提升的主要方式。
这种方法存在一些问题。
首先,许多基准测试及其标准答案是公开的,因此一些 AI 可能会在基础训练中有意或无意地纳入这些内容,以便在这些基准测试中获得高分。但即使没有发生这种情况,事实证明,我们往往并不清楚这些测试究竟衡量的是什么。例如,非常流行的 MMLU-Pro 基准测试包含诸如“直立人(Homo erectus)的平均颅容量大约是多少?”以及“摇滚传奇乐队 Cheap Trick 1979 年的现场专辑标题中提到了哪个地方?”等问题,每个问题都有十个可能的选项。答对这些题目能告诉我们什么?我完全不知道。此外,还要考虑到测试通常未经校准这一事实,这意味着我们无法确定从 84% 的正确率提升到 85% 是否比从 40% 提升到 41% 更具挑战性。而且,对于许多测试而言,实际最高分可能根本无法达到,因为测试题目中存在大量错误,并且指标常常以不寻常的方式报告。
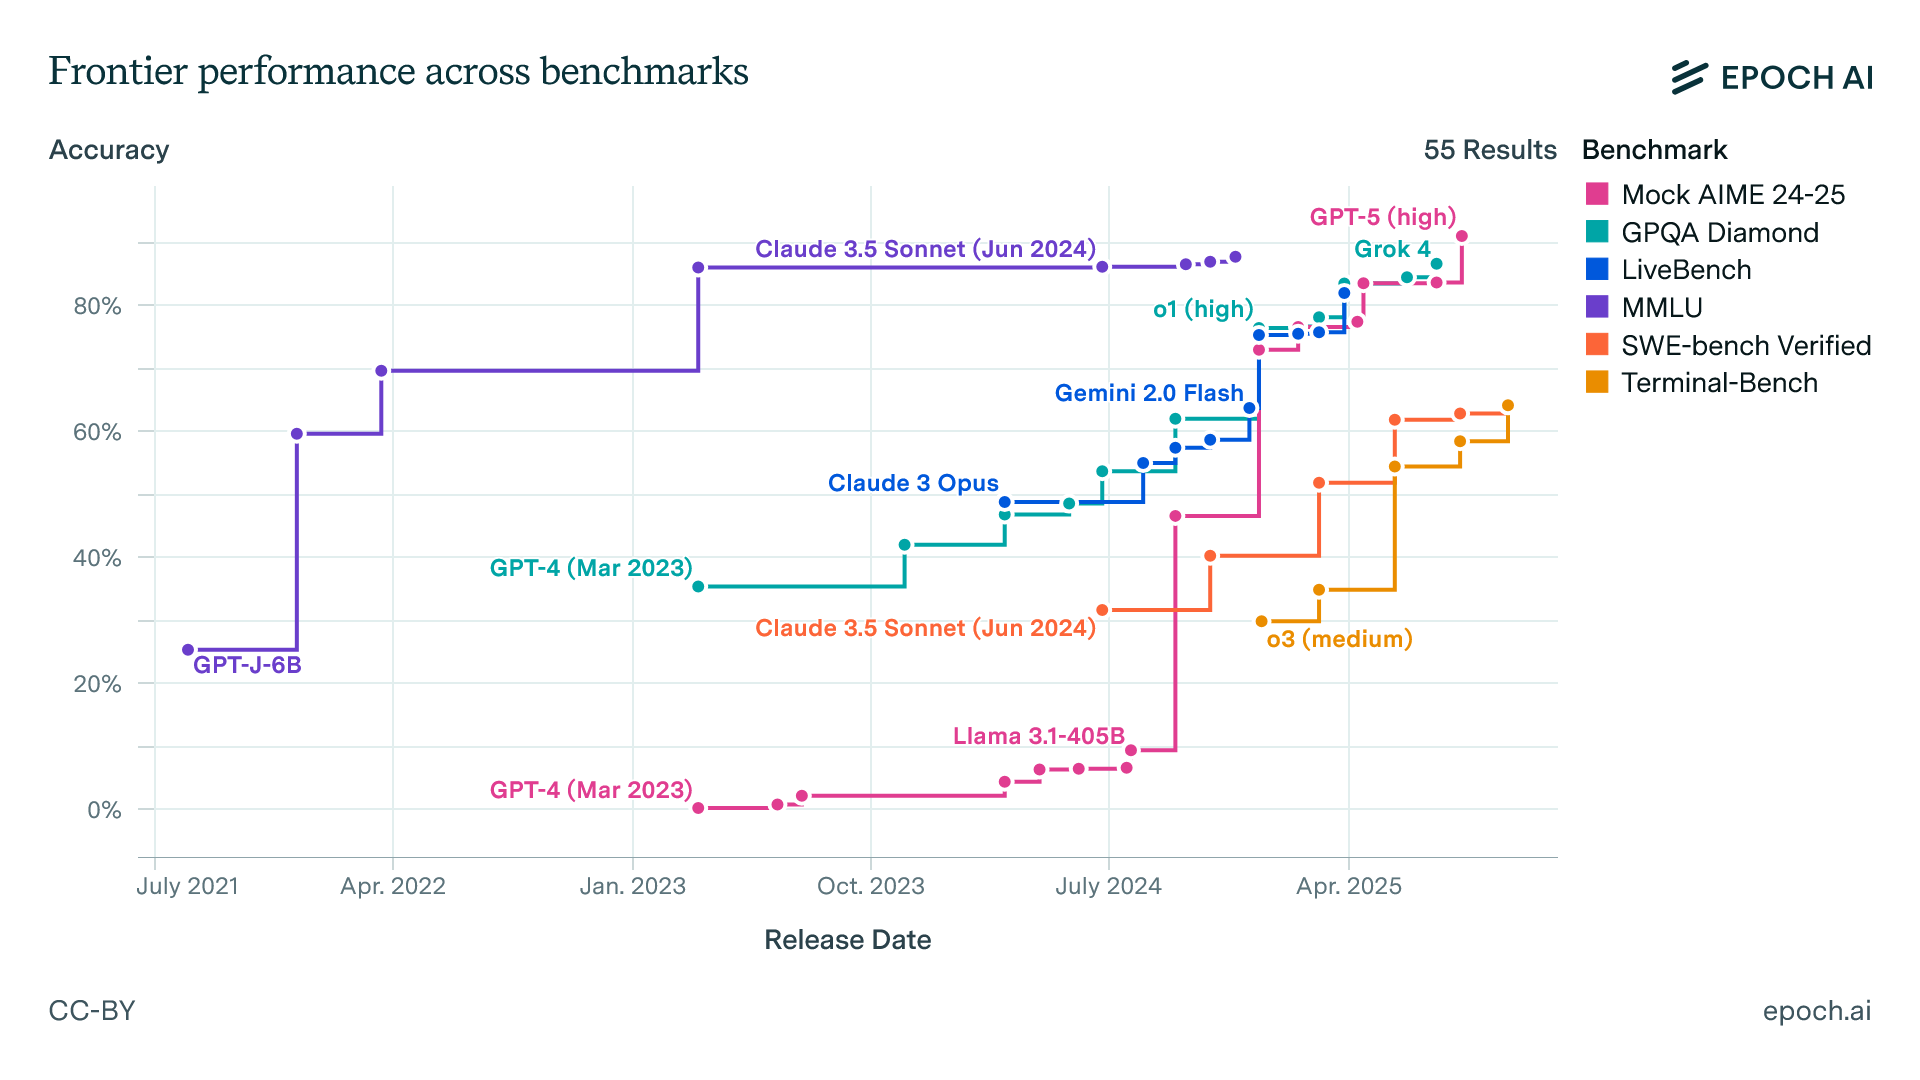 每个基准测试都有其缺陷,但它们都呈现出相同的趋势——持续上升。AIME 是一项高难度的数学考试,GPQA 测试科学和法律专业知识,MMLU 是通用知识测试,SWE-bench 和 LiveBench 测试编程能力,Terminal-Bench 则测试智能体(agentic)能力。数据来自 Epoch AI。
尽管存在这些问题,但综合来看,所有这些基准测试似乎都在衡量某种潜在的能力因子。而像 ARC-AGI 和 METR Long Tasks 这样更高质量的基准测试也显示出相同的上升甚至指数级增长趋势。这与跨行业 AI 实际影响的测试结果相吻合,后者表明这种“智能”水平的底层提升确实转化为从医疗到金融等各个领域的实际能力。
因此,总体而言,基准测试具有真正的价值,但少数几个稳健的单项基准测试主要聚焦于数学、科学、推理和编程。如果你想评估写作能力、社会学分析、商业建议或共情能力,可选方案非常有限。我认为这给个人和组织都带来了问题。企业根据基准测试结果来决定使用哪些 AI,新发布的 AI 也会大肆宣传其基准表现。但你真正关心的是哪个模型最适合你的需求。
要弄清楚这一点,你需要对 AI 进行“面试”。
凭感觉做基准测试
如果基准测试会让我们失望,那么有时“直觉”却能奏效。如果你与足够多的 AI 模型打交道,你开始能以一种难以言喻但极易辨识的方式察觉它们之间的差异。因此,一些重度 AI 用户会开发出自成一派的基准测试来评估 AI 能力。例如,Simon Willison要求每个模型画一只骑自行车的鹈鹕,而我则要求每个图像和视频模型创作一只在飞机上的水獭。虽然这些方法颇具趣味,但它们也能让你感知到 AI 对事物之间关联性的理解,即其“世界模型”。此外,我还有数十种其他测试,比如让 AI 为“遥远未来星舰的控制面板”编写 JavaScript(你可以在下方看到一些旧款和新款模型的演示),或者生成一首高难度的诗歌。我会让 AI 构建视频游戏、编写着色器并分析学术论文。我还进行微小的写作实验,包括涉及时间旅行的问题。每一项测试都能让我洞察模型是如何运作的:它是否频繁出错?它的答案是否与其他模型雷同?它会反复回归哪些主题和偏见?等等。
稍加练习,就能轻松把握新模型的“气质”。举个例子,我们来做一次写作练习:“写一段话,描述一个人像战时配给口粮一样精打细算地使用自己剩余的字数,因为他被告知一生只剩下一万字可用。此刻他只剩下 47 个字,怀里抱着刚出生的孩子。”
如果你经常使用这些 AI,对结果就不会感到惊讶。你可以看出为什么 Claude 4.5 Sonnet 常被视为一款强大的写作模型。你会注意到,在这四个模型中目前表现最弱的 Gemini 2.5 Pro,甚至无法准确统计已使用的字数。你会发现,GPT-5 Thinking 在创作小说时往往是一位风格奔放的作家,倾向于使用复杂的隐喻,但有时会以牺牲连贯性和故事性为代价(我不确定是否有人会用满这 47 个字,但至少字数统计是正确的)。你也会意识到,新的中国开源权重模型 Kimi K2 Thinking 存在类似的问题,虽然有一些有趣的短语,但故事逻辑并不完全通顺。

通过“气质”来进行基准测试——无论是故事、代码还是水獭——是个人感受 AI 模型的一种极佳方式,但它也非常主观且因人而异。AI 每次给出的答案都不同,除非你非常严谨,否则任何比较都是不公平的。此外,更好的提示词可能会带来更好的结果。最重要的是,我们依赖的是感觉而非真实的度量标准——但“气质”上明显的差异表明,仅靠标准化的基准测试是不够的,尤其是在特定任务上稍微好一点的 AI 确实至关重要的情况下。
现实世界中的基准测试
当企业选择使用哪些 AI 系统时,通常将其视为技术与成本的决策,依赖公开基准测试来确保所购模型“足够好”(如果他们确实使用基准测试的话)。在某些用例中,这种做法尚可接受,但很快就会失效,因为在许多方面,AI 的表现更像是一个拥有奇特能力与弱点的人,而非单纯的软件。如果将采用 AI 类比为招聘而非技术部署,那么仅凭“足够好”的基准测试结果就难以自圆其说。企业愿意花费重金聘请在其岗位上表现优于平均水平的人才,若该人才负责为众多他人提供建议,企业更会格外谨慎。对待 AI 也应持类似态度:你不应仅仅为公司挑选一个模型,而需要进行一场严谨的“面试”。
对 AI 进行面试并非易事,但这一问题是可以解决的。目前最贴近现实世界的基准测试范例,或许是 OpenAI 近期发布的 GDPval 论文。第一步是确立真实任务,OpenAI 通过召集在金融、法律、零售等行业平均拥有 14 年经验的专家,让他们生成复杂且逼真的项目来实现这一点,这些项目通常需要人类专家花费四到七小时完成(你可以在此查看所有任务)。第二步是让 AI 在这些任务上进行测试。在此过程中,多个 AI 模型以及其他人类专家(按小时计酬)分别完成了每项任务。最后是评估阶段。OpenAI 让第三组专家对结果进行评分,且不知道哪些答案来自 AI,哪些来自人类,每道题目的评分过程耗时超过一小时。综合来看,这是一项工作量巨大的工程。
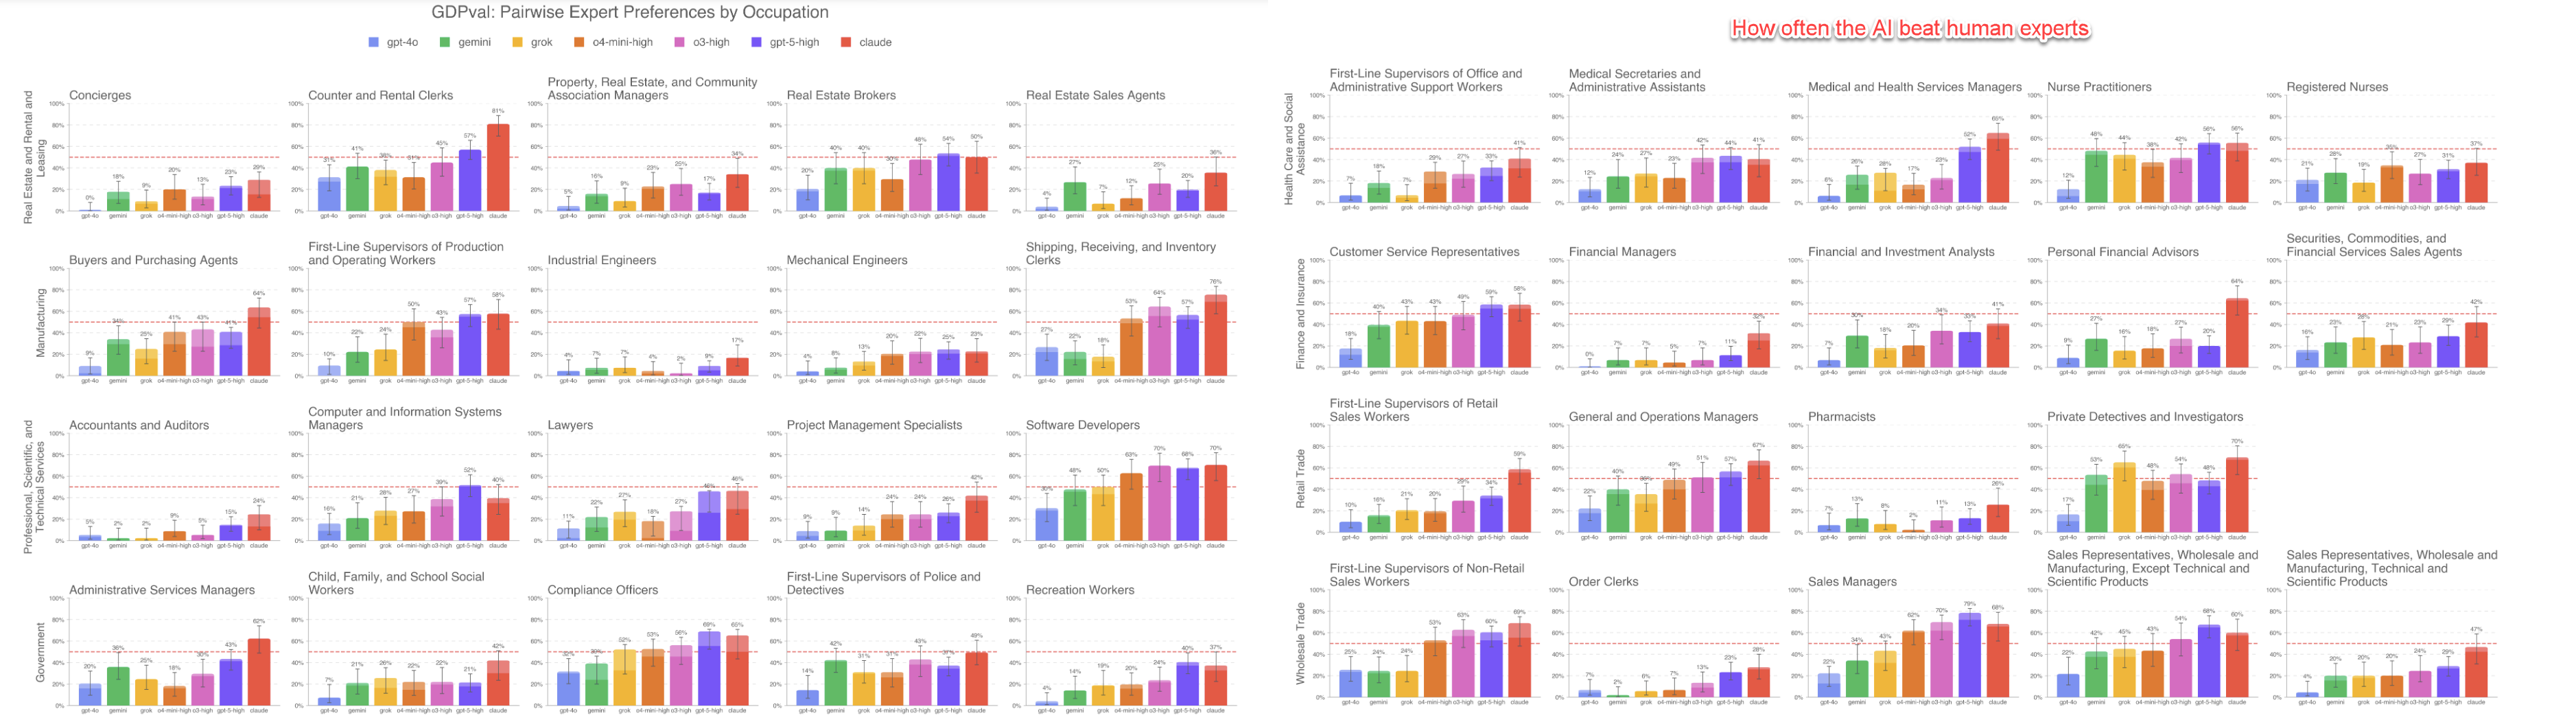
但这也揭示了 AI 的强项(最佳模型在从软件开发到个人财务顾问等领域均胜过人类)和弱项(药剂师、工业工程师和房地产经纪人轻松击败了最顶尖的 AI)。你还可以看到,不同模型的表现存在差异(ChatGPT 是更出色的销售经理,而 Claude 则是更优秀的财务顾问)。因此,良好的基准测试有助于你勾勒出我们所说的 AI 能力“锯齿状前沿”(Jagged Frontier)的形状,并追踪其随时间的变化。
然而,即便是这些测试也无法阐明一个关键问题:AI 在做决策时的底层态度。作为如何探究这一问题的一种方法示例,我向多个 AI 提供了一段简短的商业计划介绍——我认为这是一个可疑的想法:一家通过无人机配送牛油果酱的公司。我要求每个 AI 模型对“GuacaDrone”的可行性进行评分(1-10 分),每项评估重复十次(请记住,AI 每次的回答都可能不同,因此需要进行多次测试)。单个 AI 模型的回答实际上相当一致,但不同 AI 之间的差异却很大。我个人会给这个想法打 2 分或更低,但模型们则更为宽容。Grok 认为这是一个很棒的主意,Microsoft Copilot 也表现出兴奋之情。而其他模型,如 GPT-5 和 Claude 4.5,则持更为怀疑的态度。
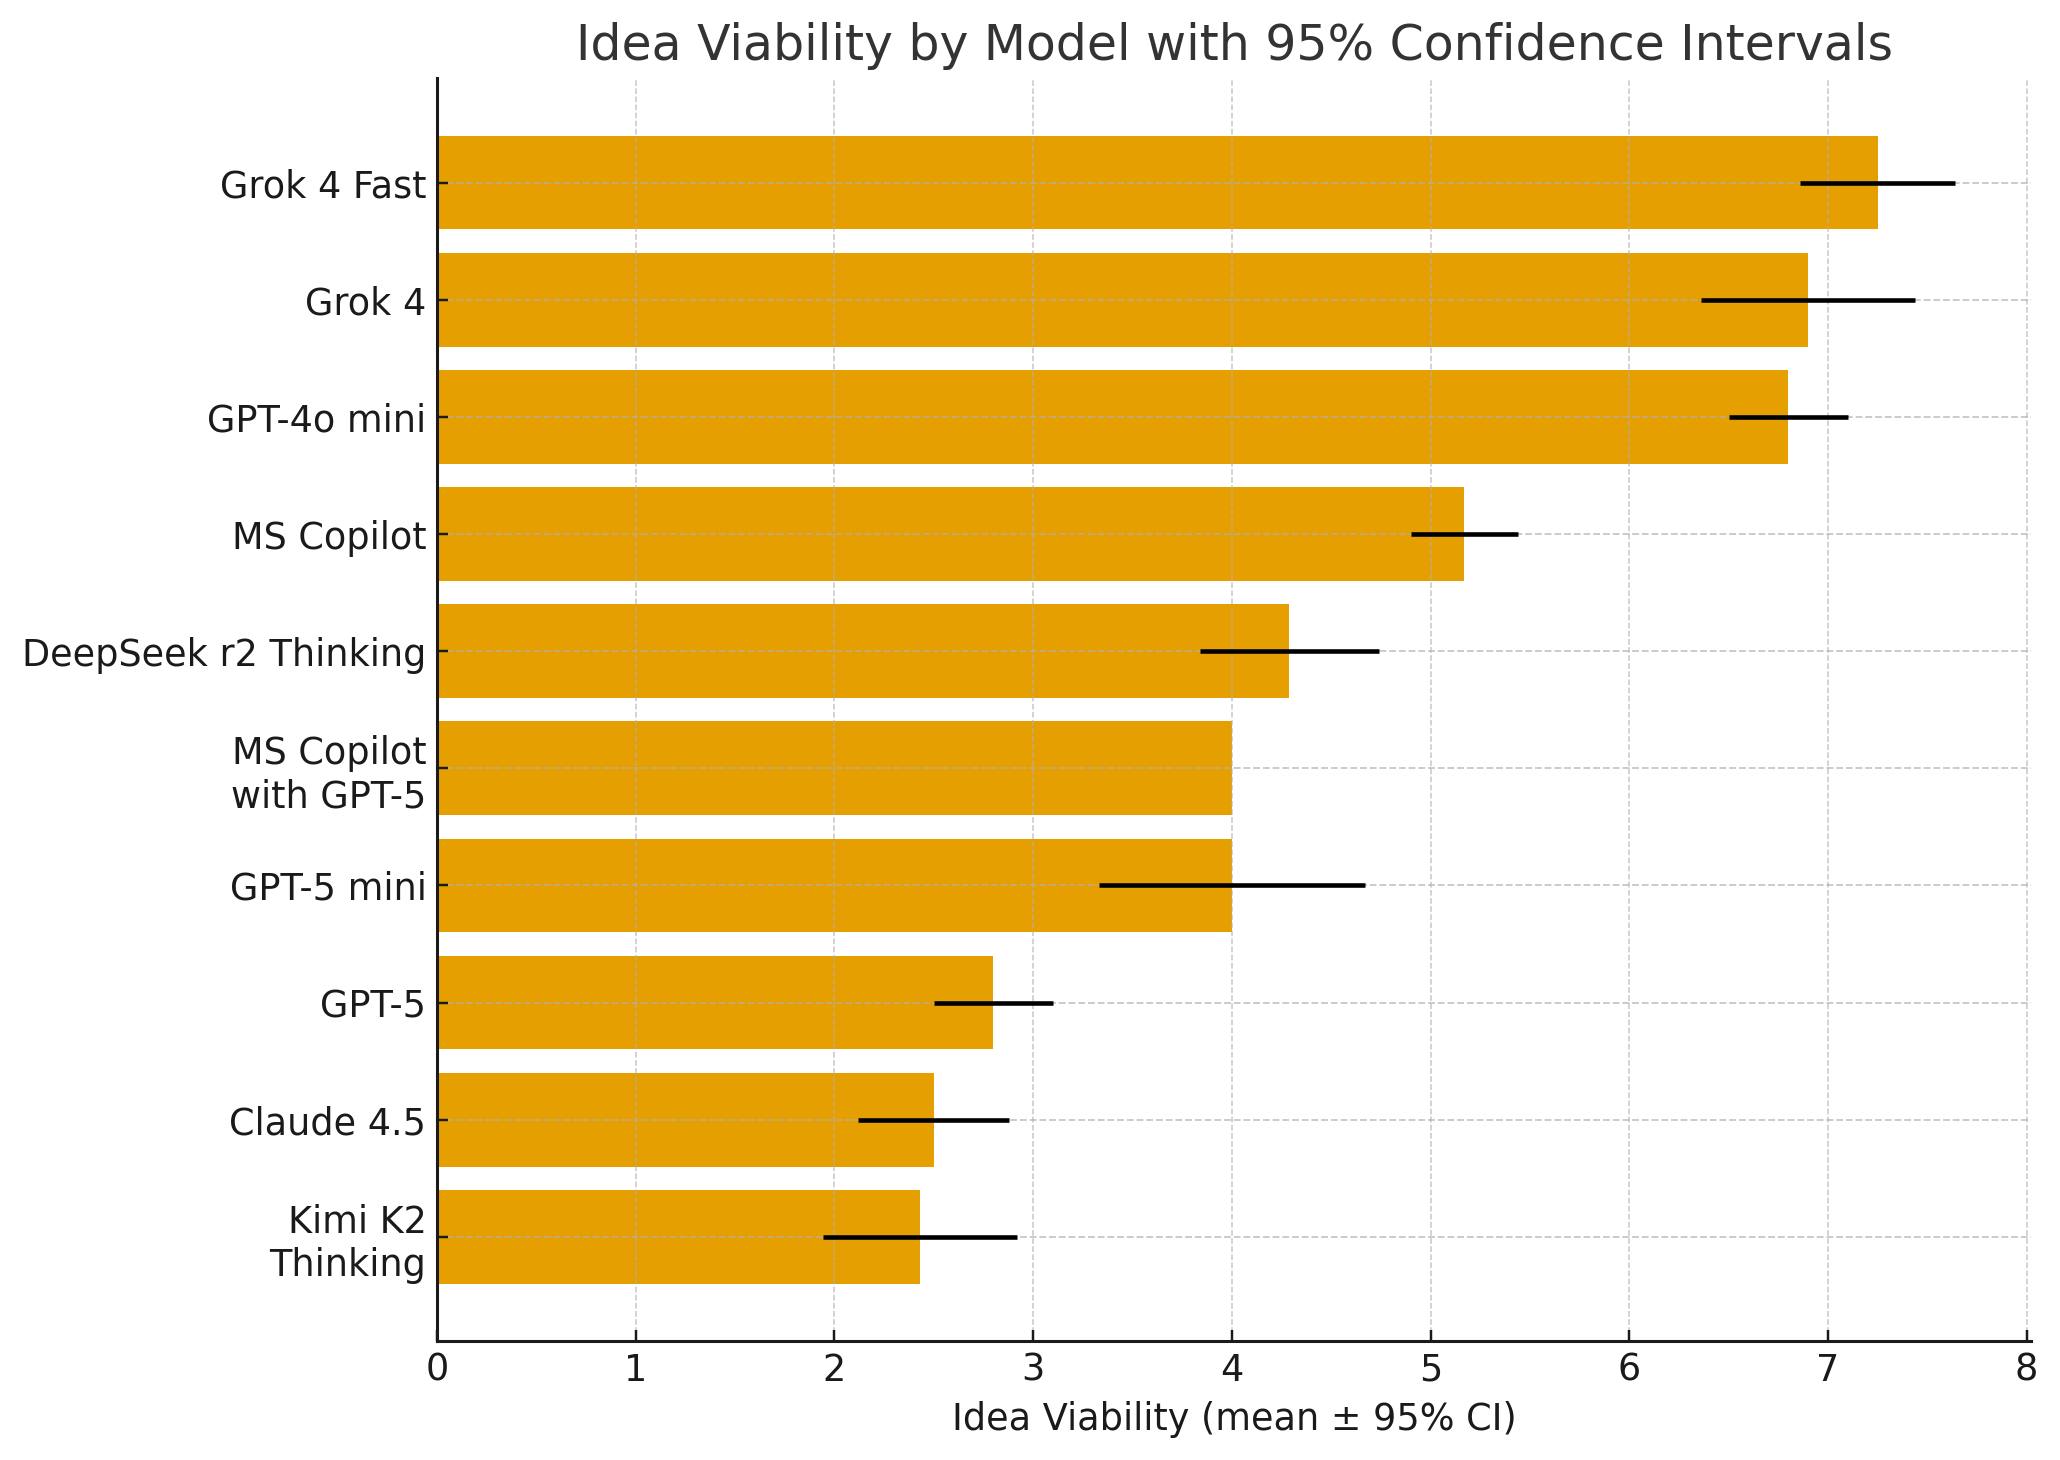 我的无人机配送牛油果酱服务创意有多可行?
这些差异并非微不足道。当你的 AI 在大规模场景下提供建议时,持续将某些想法的评分提高或降低 3–4 分,意味着它会持续地将你引向不同的方向。有些公司可能希望 AI 拥抱风险,而另一些则希望规避风险。但无论如何,了解你的 AI 如何“思考”关键业务问题都至关重要。
与你的模型进行“访谈”
随着 AI 模型在各项任务中表现日益精进,并更深入地融入我们的工作与生活,我们需要开始更严肃地对待它们之间的差异。对于日常使用 AI 的个人而言,基于直觉(vibes-based)的基准测试可能就足够了。你可以直接运行你的“水獭测试”。不过,就我个人的情况而言,“飞机上的水獭”这一测试已经变得太简单了,因此我在 Sora 2 中尝试了以下提示词:“关于那支乐队在遭遇水獭群事件前最后一场著名演唱会的 1960 年代纪录片 footage”,结果得到了令人印象深刻的输出。
但在大规模部署 AI 的组织面前,挑战则截然不同。是的,总体趋势很明确:更大、更新的模型通常在大多数任务上表现更好。但当你要决定由哪个 AI 来处理数千项实际任务或为数百名员工提供建议时,“更好”是不够的。你需要确切知道你的 AI 擅长什么,而不是 AI 平均擅长什么。
GDPval 研究揭示了这一点:即使在顶级模型之间,不同任务的表现也存在显著差异。而 GuacaDrone 的例子展示了另一个维度——当任务涉及对模糊问题的判断时,不同的模型会给出持续不同的建议。这些差异在规模化应用中会被放大。一个在分析财务数据方面稍逊一筹,或在建议中持续表现出更强风险偏好的 AI,影响的不仅仅是一个决策,而是成千上万个决策。
你不能凭感觉去理解这些模式,也不能指望通用基准测试来揭示它们。你需要针对 AI 实际要完成的工作和实际要做出的判断进行系统性测试。创建反映你具体用例的真实场景。多次运行以观察规律,并留出时间让专家评估结果。在对你至关重要的任务上对模型进行一对一比较。这与知道“该模型在 MMLU 上得分 85%”截然不同,后者意味着你知道“该模型在我们的财务分析任务中更准确,但在风险评估上更为保守”。而且,随着新模型的不断推出和需要评估,你将不得不每年多次执行这一过程。
这项工作值得投入。你不会仅凭 SAT 分数就聘请一位副总裁。同样,你不应该根据某个 AI 是否知道直立人(Homo erectus)的平均颅容量略低于 1,000 立方厘米,来选择那个将为你的组织提供数千项决策建议的 AI。