亚马逊 SageMaker HyperPod 支持托管 NVIDIA Dynamo 推理
亚马逊 SageMaker HyperPod Inference 现已支持托管 NVIDIA Dynamo,将 Dynamo 的分布式推理能力与 HyperPod 的基础设施管理相结合,解决超大模型单机显存不足与长提示词拖慢生成的问题。该方案支持多节点部署、预填充与解码分离以及 KV 感知路由,并兼容 vLLM、SGLang、TensorRT-LLM 等引擎,底层依托 EFA 高性能网络与 GPU 调度、节点健康监控。
报道正文
本文目录13 个章节
高效地服务大型语言模型(LLM)需要足够的 GPU 内存,并需要谨慎协调提示词处理与 token 生成。例如,GLM-5.3 的 FP8 权重在尚未计入 KV cache 和运行时开销之前,就已超过单台 ml.p5.48xlarge 实例的 640 GB GPU 内存。当长提示词与 token 生成共享同一批 GPU 时,长提示词还可能拖慢 token 生成。
Amazon SageMaker HyperPod Inference 现已支持 NVIDIA Dynamo,将 Dynamo 的分布式推理能力与 HyperPod 的基础设施管理相结合,以应对这些挑战。Dynamo 是一个开源分布式推理框架,支持多节点部署、分离式 prefill 与 decode,以及基于 KV 感知的路由,并可搭配 vLLM、SGLang 和 TensorRT-LLM 等引擎。HyperPod 通过高性能 Elastic Fabric Adapter (EFA) 网络、协调的 GPU 调度以及节点健康监控与恢复来支持这些部署。本文通过一个部署示例说明多节点与分离式服务,分享基准测试结果,并概述在 HyperPod 上优化推理的最佳实践。
集成的工作原理
HyperPod Inference 附加组件会安装 Dynamo 自定义资源定义以及以下服务和调度组件:
- HyperPod Inference Operator 通过 InferenceEndpointConfig (IEC) 自定义资源管理端点部署。其
dynamoSpec部分提供 Dynamo 配置。 - Dynamo operator 管理 DynamoGraphDeployment (DGD) 中定义的资源,包括前端、模型 worker、副本数量和资源需求。
- Grove 协调相关的 pod 组,包括多节点 worker,以及它们的扩缩容关系。
- Kubernetes AI (KAI) Scheduler 将 pod 放置到 GPU 资源上,并使用 gang scheduling 将多节点 worker 所需的 pod 一起调度。
AWS Deep Learning Containers (DLC) 提供 Dynamo 运行时,而附加组件负责管理集成组件的版本。要采用受支持的 Dynamo 版本,请更新附加组件。
部署架构
下图展示了 SageMaker HyperPod 上分离式推理的部署路径、服务组件和基础设施管理。Dynamo 前端将请求路由到 prefill worker(处理提示词)和 decode worker(生成 token)。这两个独立的池允许独立扩展和调优。两个池都会加载完整的模型权重,KV cache 通过 EFA 在两者之间传输。
Dynamo 还支持聚合式服务,即 prefill 和 decode 在同一个 worker 中运行。在任一拓扑中,worker 都可以运行在单个实例上,也可以通过张量并行和流水线并行跨多个实例运行。Dynamo 的 KV-aware router 在两种拓扑中都会考虑可复用的前缀 KV cache 和活跃 worker 负载。前缀复用可以减少提示词重计算并改善首 token 时间,而负载感知有助于避免 worker 过载。有关 Dynamo 架构的更多细节,请参阅 Dynamo Knowledge Base 概览。
HyperPod 提供节点、GPU 和 EFA 健康监控,并管理节点替换,而编排组件会重建受影响的 worker。通过 InferenceEndpointConfig 配合 dynamoSpec 配置的部署支持通过 SageMaker 端点进行调用。
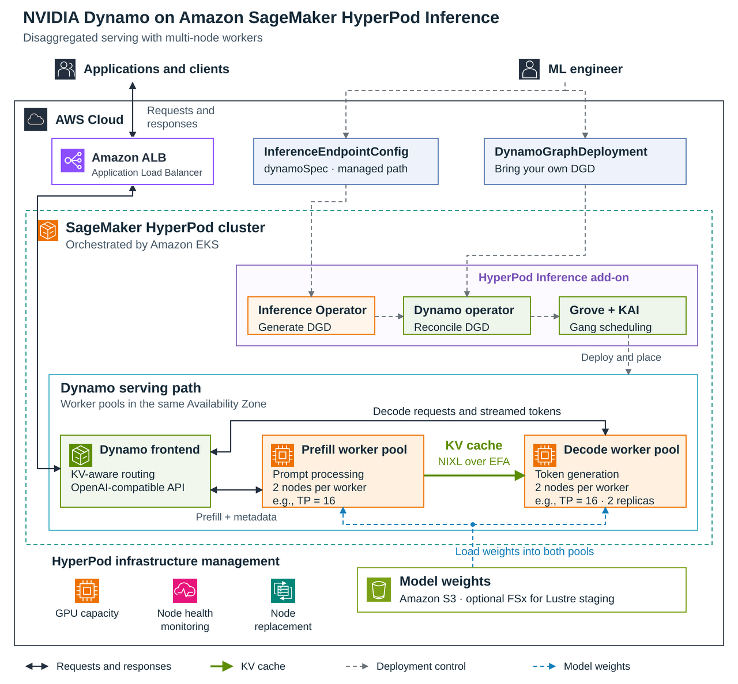
图 1:NVIDIA Dynamo 在 Amazon SageMaker HyperPod Inference 上的部署路径、服务组件和基础设施管理
配置部署的两种方式
无论您是刚接触 HyperPod、刚接触 Dynamo,还是两者都是新手,该附加组件都提供两种部署路径以适配您的工作流:
自带 DynamoGraphDeployment (DGD) 让现有 Dynamo 用户能够继续使用上游文档、配方和清单,由 Dynamo operator 管理部署。要将现有 DGD 引入 HyperPod,请使用受支持的容器镜像,并为您的集群配置存储、网络和 pod 放置。
使用 dynamoSpec 的 InferenceEndpointConfig 让现有的 HyperPod Inference 用户能够使用他们熟悉的相同配置格式和 OpenAI 兼容接口来部署新的 Dynamo 端点。对于推理引擎,你可以选择 vLLM、SGLang 或 TensorRT-LLM,默认使用 vLLM。该 operator 还为 KV 感知路由和副本数提供默认值。
两种路径均支持单实例和多节点部署。无论采用哪种方式,HyperPod 都会管理节点健康状况和替换。下表总结了每种路径的职责。
| 自带 DGD | 带 dynamoSpec 的 InferenceEndpointConfig | |
|---|---|---|
| 你需要编写 | 完整的 DGD 清单 | 包含 dynamoSpec 的 IEC |
| 最适合 | 希望直接控制服务图或复用现有 DGD 的团队 | 希望通过 IEC 获得托管端点设置的团队 |
| 模型权重 | 你配置权重的下载或挂载 | Operator 从 Amazon Simple Storage Service (Amazon S3) 或 Amazon FSx 暂存权重 |
| 端点、TLS、注册 | 你配置和管理这些资源 | 通过 HyperPod Inference Operator 管理 |
| 自动扩缩容 | 你配置和管理扩缩容 | 通过 autoScalingSpec 使用 Kubernetes Event-driven Autoscaling (KEDA),适用于聚合式和分离式部署 |
部署示例:GLM-5.3
以下摘录使用 InferenceEndpointConfig(IEC)部署路径,在 ml.p5.48xlarge 实例上运行 vLLM。Dynamo 专属设置位于 spec.dynamoSpec 下。模型来源和端点设置包含在完整清单中。
多节点聚合服务
此配置在两个实例(16 个 GPU)上运行一个 model-worker 副本,并使用两个前端副本处理请求。将 dynamoSpec.frontend.routingMode 设置为 kv-aware 可启用 KV 感知路由。
spec:
  replicas: 1
  dynamoSpec:
    modelServer: vllm
    frontend:
      replicas: 2
      routingMode: kv-aware
    aggregation:
      nodesPerReplica: 2
tensorParallelism: 16此处,spec.replicas 控制 model-worker 副本的数量,而 frontend.replicas 控制前端副本的数量。
多节点分离式服务
将 spec.dynamoSpec 下的 aggregation 替换为以下 disaggregation 块,并保留前面的前端配置。prefill 和 decode 的副本数分别设置。此示例运行一个 prefill 副本和两个 decode 副本,每个副本跨两个实例,总共六个实例。
disaggregation:
  prefill:
    nodesPerReplica: 2
    tensorParallelism: 16
    replicas: 1
  decode:
    nodesPerReplica: 2
    tensorParallelism: 16
    replicas: 2
应用部署
使用 kubectl apply 应用完整清单。HyperPod Inference Operator 会将配置的模型权重提供给 worker,并生成 DGD。Grove 和 KAI Scheduler 协调放置,使每个多节点 worker 所需的 pod 一起调度。
在 SageMaker 端点就绪并配置为聊天补全后,客户端可以通过 SageMaker Runtime API 发送 OpenAI 兼容的请求负载:
aws sagemaker-runtime invoke-endpoint \
--endpoint-name glm53 \
--content-type application/json \
--body '{"model":"zai-org/GLM-5.3","messages":[{"role":"user","content":"Hello"}],"max_tokens":128}' \
--cli-binary-format raw-in-base64-out \
out.json
基准测试
我们在 SageMaker HyperPod 上对 Dynamo 进行了基准测试,涵盖两个模型,以比较服务配置。
Qwen3-235B 的分离式 prefill 和 decode
我们使用 AIPerf 在搭载 Dynamo 与 TensorRT-LLM 的两台 p5en.48xlarge 实例(16 块 H200 GPU)上,对比了 Qwen3-235B-A22B-FP8 的聚合式与分离式服务。请求包含 4,000 个输入 token 和 200 个输出 token。我们保留了满足两项指标的测量点:P90 首 token 时间低于一秒,以及每用户生成速度中位数至少为每秒 50 个 token。在这些点中,分离式服务达到了聚合式最高吞吐量的 2.05 倍:每 GPU 每秒 207 个输出 token,对比 101 个,对应并发度分别为 80 和 32。
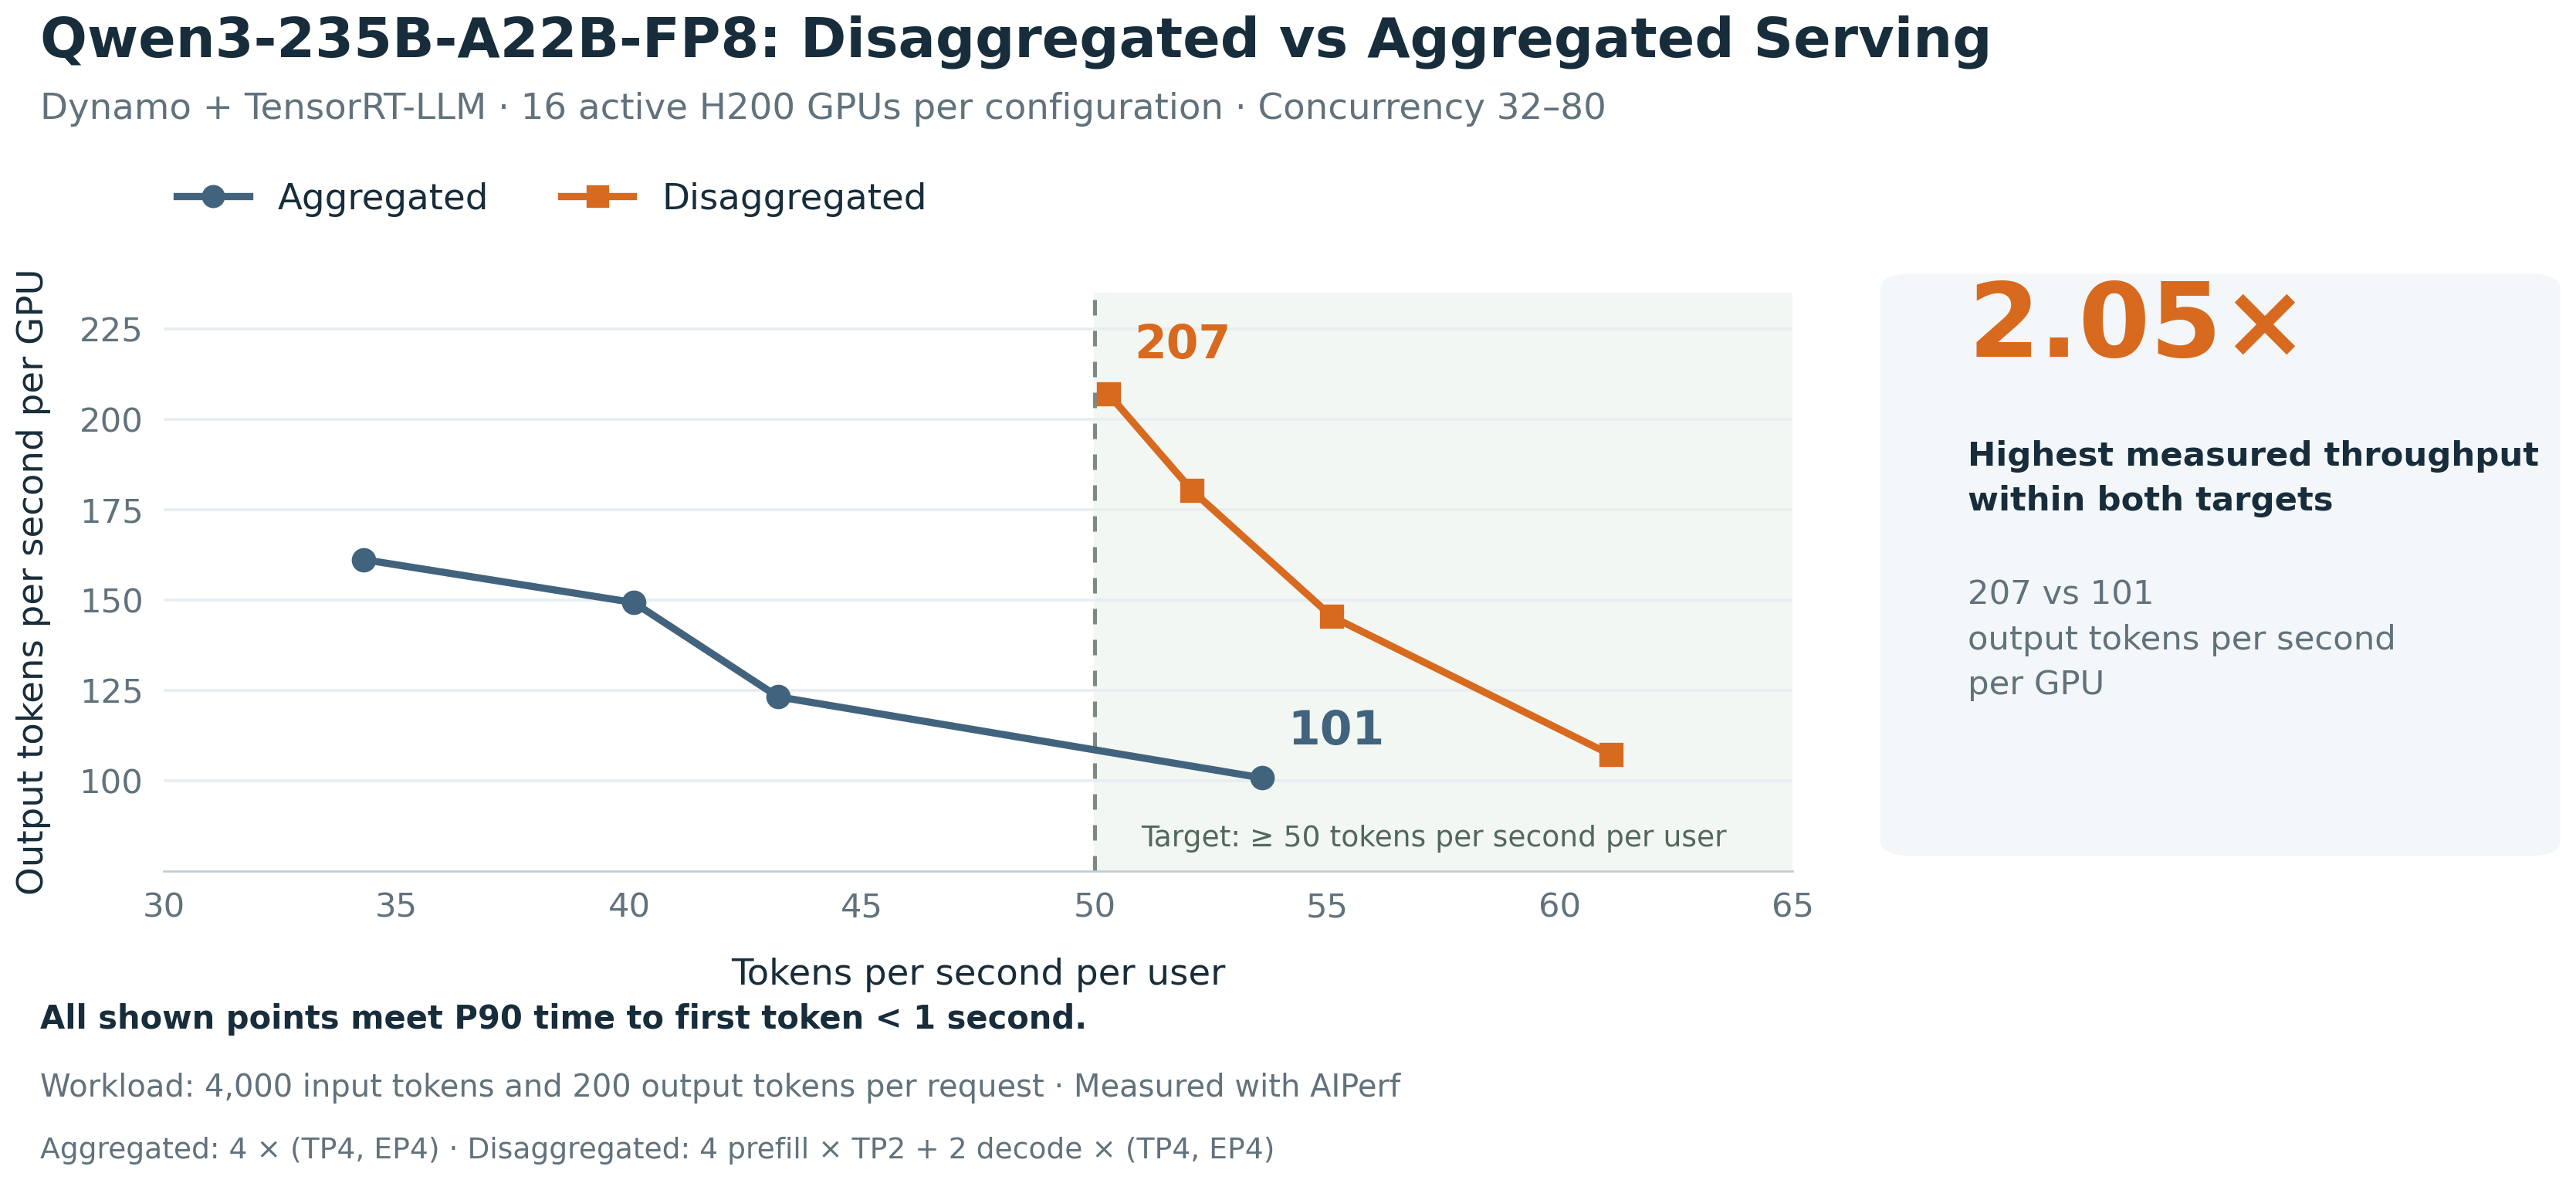
图 2:Qwen3-235B-A22B-FP8 的聚合式与分离式服务吞吐量对比
Qwen3.5-397B 的多节点聚合式服务
对于超出单台实例 GPU 内存的模型,Dynamo 在聚合式和分离式两种模式下均支持多节点服务。为评估跨节点 worker,我们使用 AIPerf 对 Qwen3.5-397B-A17B-FP8 的多节点聚合式服务进行了基准测试,采用 Dynamo 与 vLLM,配置为 TP4 × PP2,使用八块活跃的 H200 GPU。该模型可容纳于单台实例,因此实际中不会对其进行拆分。此处它作为受控基线。我们对比了单台 p5en.48xlarge 上的八块 GPU 与两台实例上各四块 GPU 的情况,使用相同的模型、并行度和工作负载配置。在并发度为 32、具有高前缀复用特征的 agentic 工作负载下,双节点配置达到每 GPU 每秒 126.4 个输出 token,保留了单节点吞吐量的 99.1%。这表明 SageMaker HyperPod 上的 Dynamo 可以服务需要跨节点使用多台实例的模型。节点边界本身并不会成为显著的吞吐量损失。
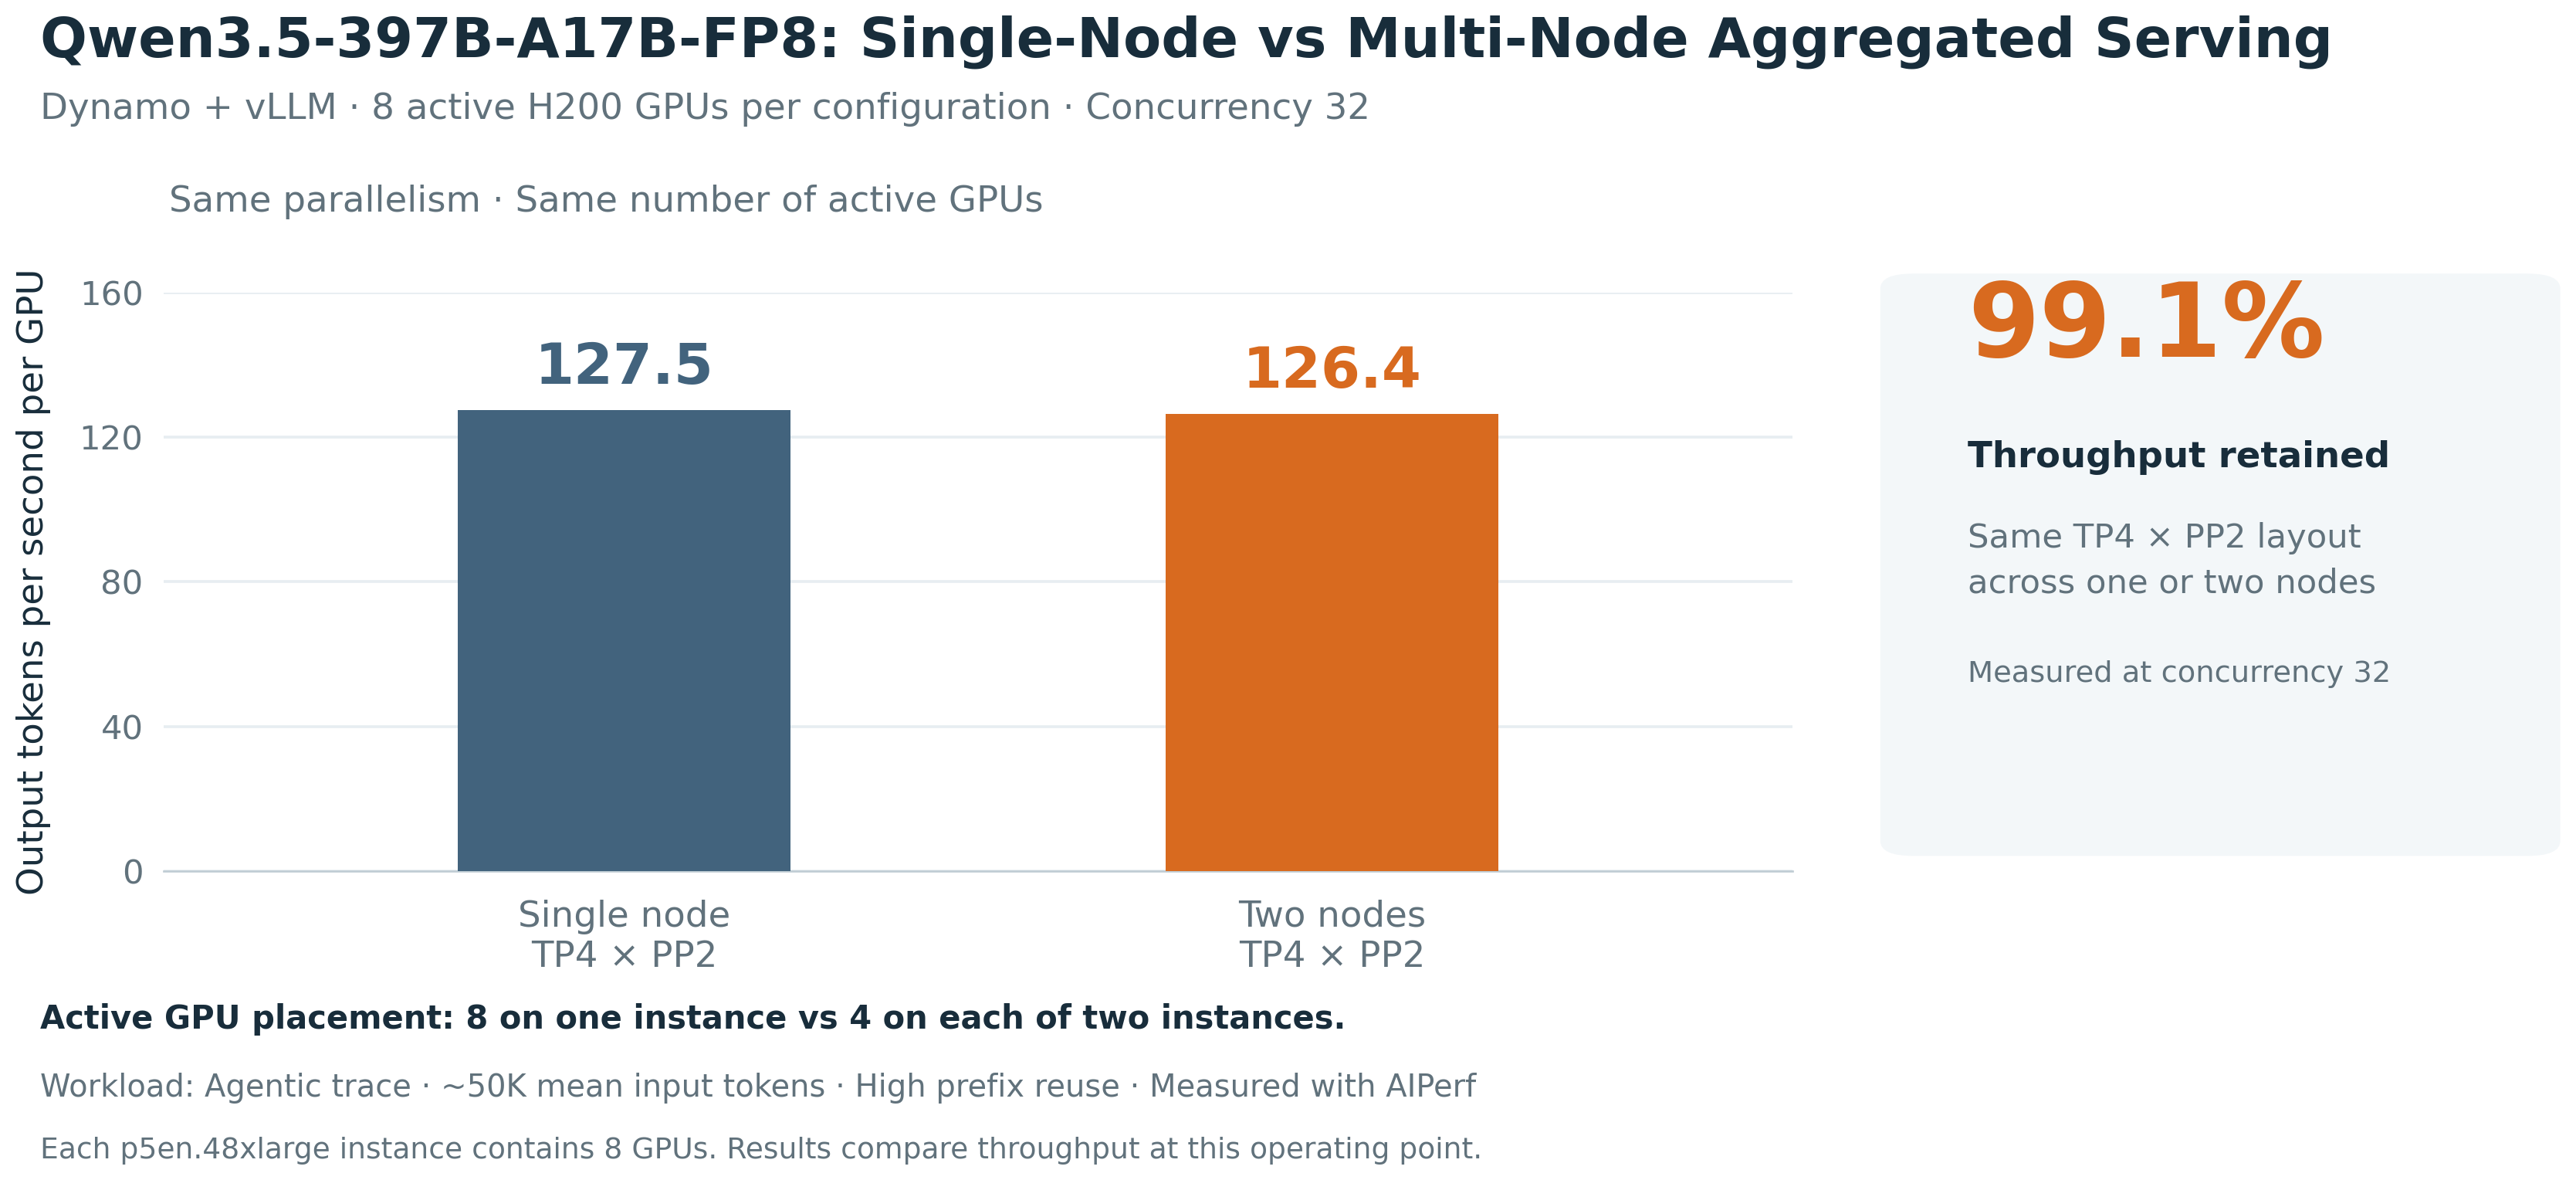
图 3:Qwen3.5-397B-A17B-FP8 多节点聚合式服务的单节点与双节点吞吐量对比
优化推理的最佳实践
NVIDIA Dynamo 提供配方和工具,帮助您在 SageMaker HyperPod 上选择服务配置、进行性能基准测试并调优部署。
- 从匹配的配方开始 – 为您的模型、推理引擎和 GPU 类型选择对应的 Dynamo 配方。在确定 worker 规模时,需考虑模型权重、KV cache 和运行时内存。对于受支持的配置,AISimulate 可帮助比较聚合式与分离式服务、选择并行策略,并在 GPU 上测试之前确定 prefill 和 decode worker 池的规模。
- 在基准测试前验证通信 – 对于跨实例的部署,确认通信使用预期的 EFA 传输,包括 prefill 和 decode worker 之间的 KV-cache 传输。请参阅 Dynamo EFA 指南。
- 对代表性流量进行基准测试 – 使用 AIPerf 回放您的流量,或使用生成的 agentic trace,其中包含具有代表性的 prompt 长度、输出长度和前缀复用。针对每种配置扫描并发度,保留满足您 SLA 的数据点,并根据成本和延迟优先级进行选择。
- 基于实测瓶颈进行调优 – 先调整拓扑和 worker 分配,再调整引擎设置,每次只改变一个变量。遵循性能调优指南,或使用 Dynamo 优化 agent skills 协助进行基准测试和调优。在您的目标 HyperPod 部署上验证每个候选方案。
结论
NVIDIA Dynamo on SageMaker HyperPod Inference 通过多节点服务、分离式预填充与解码以及 KV 感知路由,简化了大型模型的部署与运维。托管附加组件负责安装服务组件,配置默认值则简化了端点设置。HyperPod 负责管理模型权重、基于 GPU 和推理指标自动扩缩集群、监控节点健康状态并替换故障节点。这些能力共同减少了非差异化的基础设施工作,使团队能够专注于其模型和应用。请参阅链接仓库中的设置说明和完整部署示例以开始使用。
致谢
作者感谢来自 NVIDIA 的 Eliuth Triana、Felipe Garcia、Sanjana Checker、Junyuan Yang、Jiahong Liu、Anish Maddipoti、Jacob Kern 和 Abdullahi Olaoye 对本博文的贡献。我们也感谢来自 AWS 的 Can Sun、Ophelia Yang、Aryaman Kothari、David Oh 和 Ayush Kumar 的贡献。