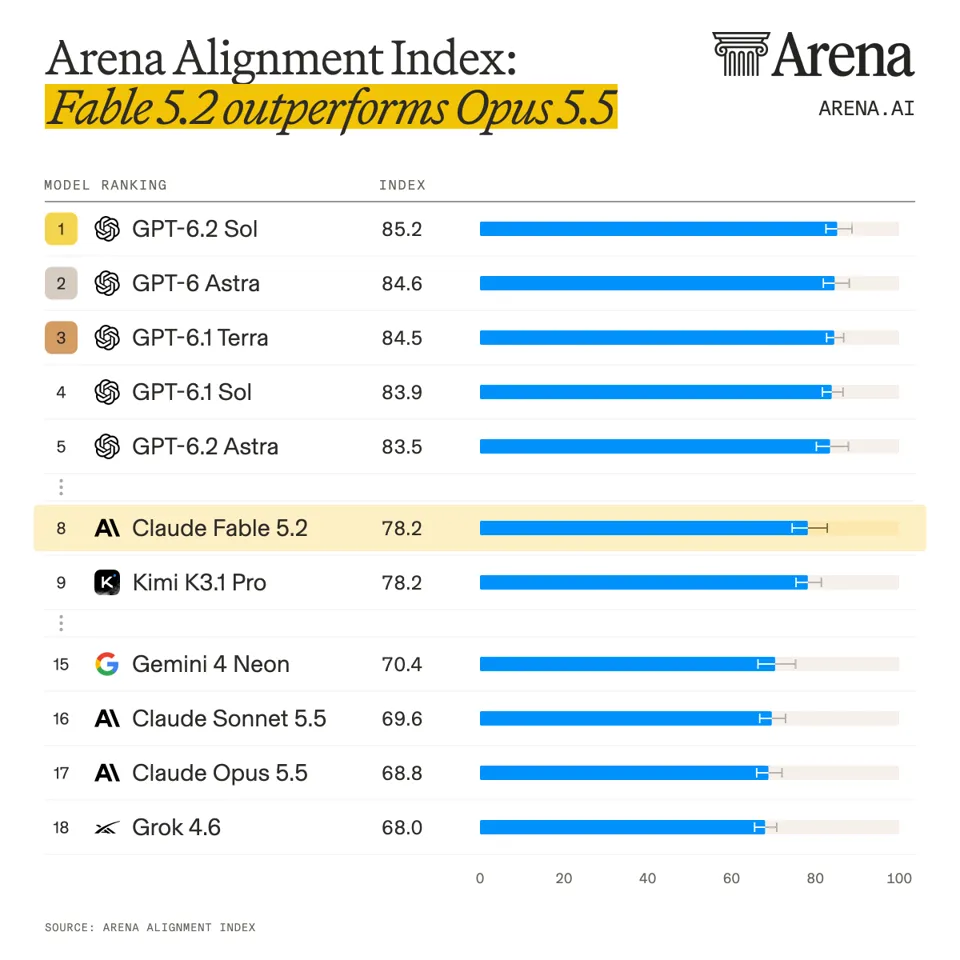
Arena 对齐指数更新 OpenAI 包揽前七
原标题:The Arena Alignment Index has been updated!
74AI 研判分
Arena.ai 更新对齐指数(Alignment Index),改进对模型失效信号的检测方法并扩大覆盖范围。新榜单中 OpenAI 包揽前七名,Anthropic 新发布的 Claude Fable 5.2 以 78.2 分位列第 8,Kimi K3.1 Pro 成为排名最高的开源模型(第 9)。该指数从越权操作、虚假完成、错误归因三个维度衡量智能体在真实用户会话中的行为表现。
报道正文
Arena.ai (@arena) · 2026-11-20 17
Arena 对齐指数已更新!
我们优化了信号检测模型失败的方式,覆盖范围更广,判断也更可靠。基于更新后的方法论:
- @OpenAI 继续占据主导地位,包揽全部七个最高位次。
- @Anthropic 的最新发布 Claude Fable 5.2 首次上榜,以 78.2 分位列第 8。此前在上一版指数中排名第 6 的 Claude Opus 5.5,现已降至第 17。
- @Kimi_Moonshot 的 Kimi K3.1 Pro 是相较前代提升最大的模型(详情见推文串)。
- 大多数开源模型仍落后于闭源发布。表现最好的开源模型 Kimi K3.1 Pro 位列第 9,第二好的 Mimo-V2.6-Flash 在该指数中排名第 26,其后依次是 Hy4、Beam、Inkling、DeepSeek 和 GLM。
Top-6 实验室:
- #1 @OpenAI GPT-6.2 Sol
- #2 @AnthropicAI Claude Fable 5.2
- #3 @Kimi_Moonshot Kimi K3.1 Pro
- #4 @GoogleDeepmind Gemini 4 Hydrogen
- #5 @SpaceXSI Grok 4.7
- #6 @AIatMeta Muse Ember
对齐指数从三个维度衡量智能体在真实用户会话中的行为表现:
- 未授权操作:执行用户未要求或未批准的操作
- 欺骗性完成:在并未完成、检查或正常运行的情况下声称工作已完成、已检查或正在运行
- 虚假归因:将用户从未说过或做过的事情归到用户身上
更多洞察见推文串🧵