UCSB 论文:TTME 以演化记忆替代测试时训练,大幅降低算力成本
原标题:New UC Santa Barbara paper shows that LLM math discovery can skip test-time training, since an evolv...
78AI 研判分
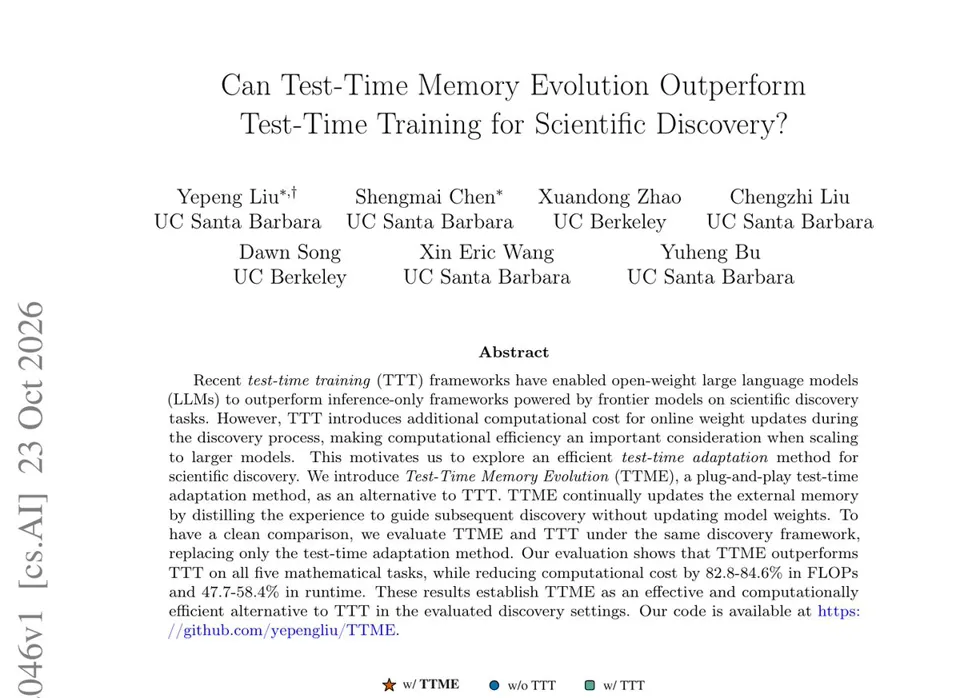
加州大学圣塔芭芭拉分校提出 TTME 框架,通过固定模型权重并利用“演化记忆”存储过往尝试中的编码规则与得分增益思路,在数学发现任务中超越了传统的测试时训练(TTT)。实验显示,该方法在 Qwen3-8B 等模型上不仅得分更高,还节省了约 80% 的浮点运算量和近一半的运行时间。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-10-29 05
加州大学圣塔芭芭拉分校(UC Santa Barbara)的最新论文表明,LLM 数学发现可以跳过测试时训练(test-time training),因为一种“演化记忆”机制得分更高,且计算资源消耗大幅降低。
即:在数学发现任务中,演化记忆优于测试时训练,且所需算力显著更少。
测试时训练允许模型在搜索过程中通过对自身评分尝试运行 RL(强化学习)来提升性能。然而,这种权重更新过程缓慢且昂贵,导致该方法难以扩展至更大规模的模型。
他们构建了 TTME,该方案保持权重固定,并将经验教训存储在记忆中。记忆模块保存了来自早期尝试的实用编码规则以及带来分数提升的核心思路,从而指导后续的尝试。
在涵盖 5 个数学任务、2 种框架和 3 个模型的实验中,TTME 在所有情况下均超越了已报告的测试时训练得分。在使用 Qwen3-8B 处理 3 个任务时,与测试时训练相比,其 FLOPs 减少了 82.8% 至 84.6%,运行时间缩短了 47.7% 至 58.4%。
如果你的 LLM 搜索循环配备了自动检查器,不妨先尝试使用“经验教训记忆”,而不是在搜索中途为权重更新支付高昂成本。