xAI Grok 4.7 基准测试:智能指数达 46,编码代理性能超越 GPT-5.6 Sol
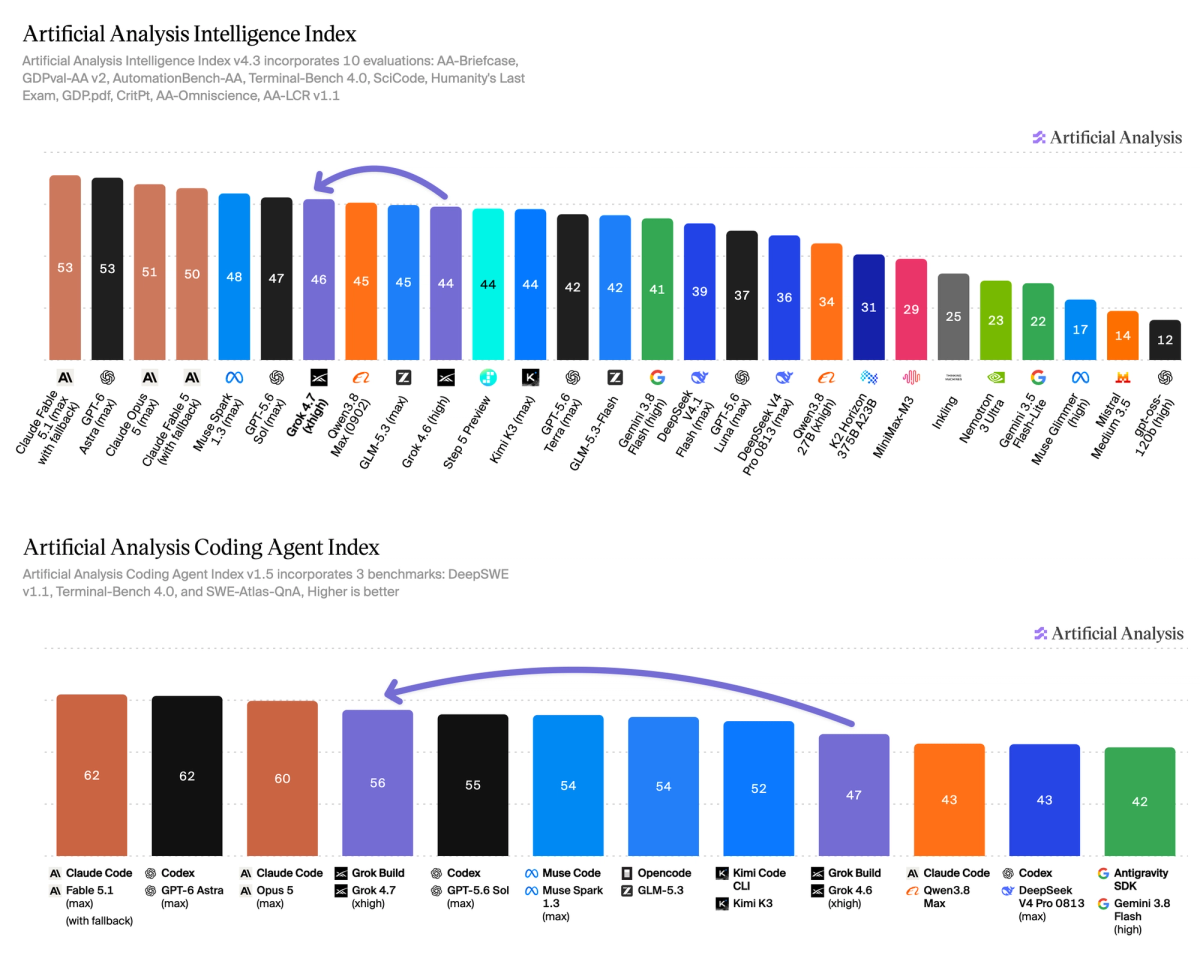
xAI 发布 Grok 4.7 模型,在 Artificial Analysis 智能指数中得分 46,跻身全球前四 AI 实验室行列。该版本在长周期知识工作(AA-Briefcase)和编码代理任务上表现显著提升,其中编码代理指数得分 56,超越了 GPT-5.6 Sol。尽管在非代理任务上的改进较为渐进,但其在特定垂直领域的突破确立了新的竞争格局。
报道正文
本文目录3 个章节
Grok 4.7 在 Artificial Analysis 智能指数中得分 46,助力 SpaceXAI 跻身 AI 实验室前四。编码代理指数表现亦有提升,超越 GPT-5.6 Sol
Grok 4.7 在智能指数上较 Grok 4.6 提升 +2 分,并在代理式知识工作(agentic knowledge work)任务中表现出强劲性能。我们在 xhigh 推理努力度下对新模型进行了评估。
关键要点:
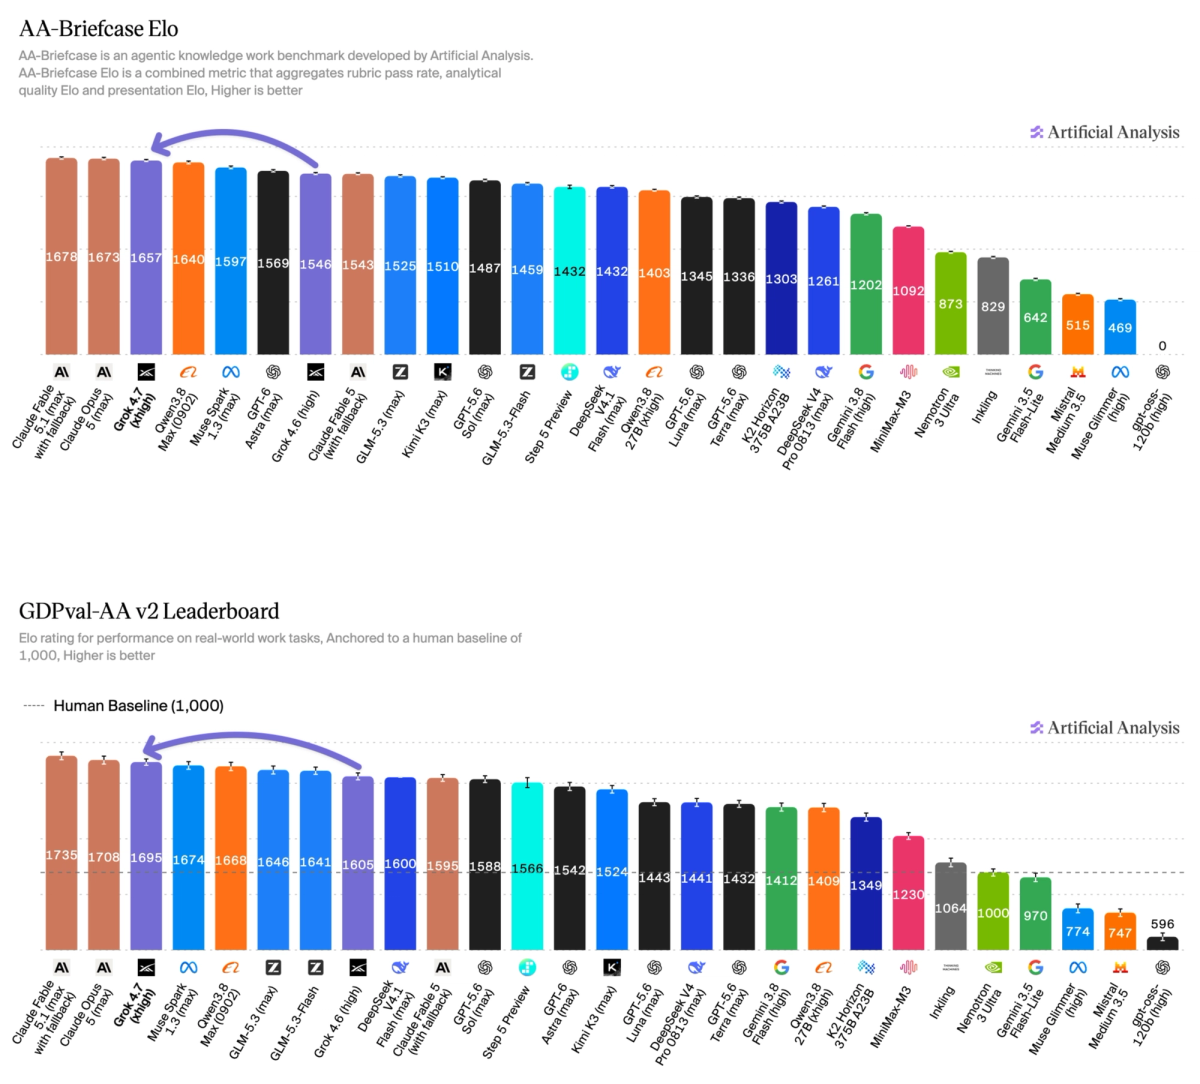
➤ Grok 4.7 跻身代理式知识工作前沿: 在我们的私有基准 AA-Briefcase(用于评估长周期代理式知识工作)上,Grok 4.7 相比 Grok 4.6 (high) 提升了 +111 Elo,得分达到 1657 Elo,紧随 Claude Opus 5 和 Claude Fable 5.1 之后,处于前沿水平。在 GDPval-AA 上,其得分为 1695 Elo,比 Grok 4.6 (high) 高出 +90。
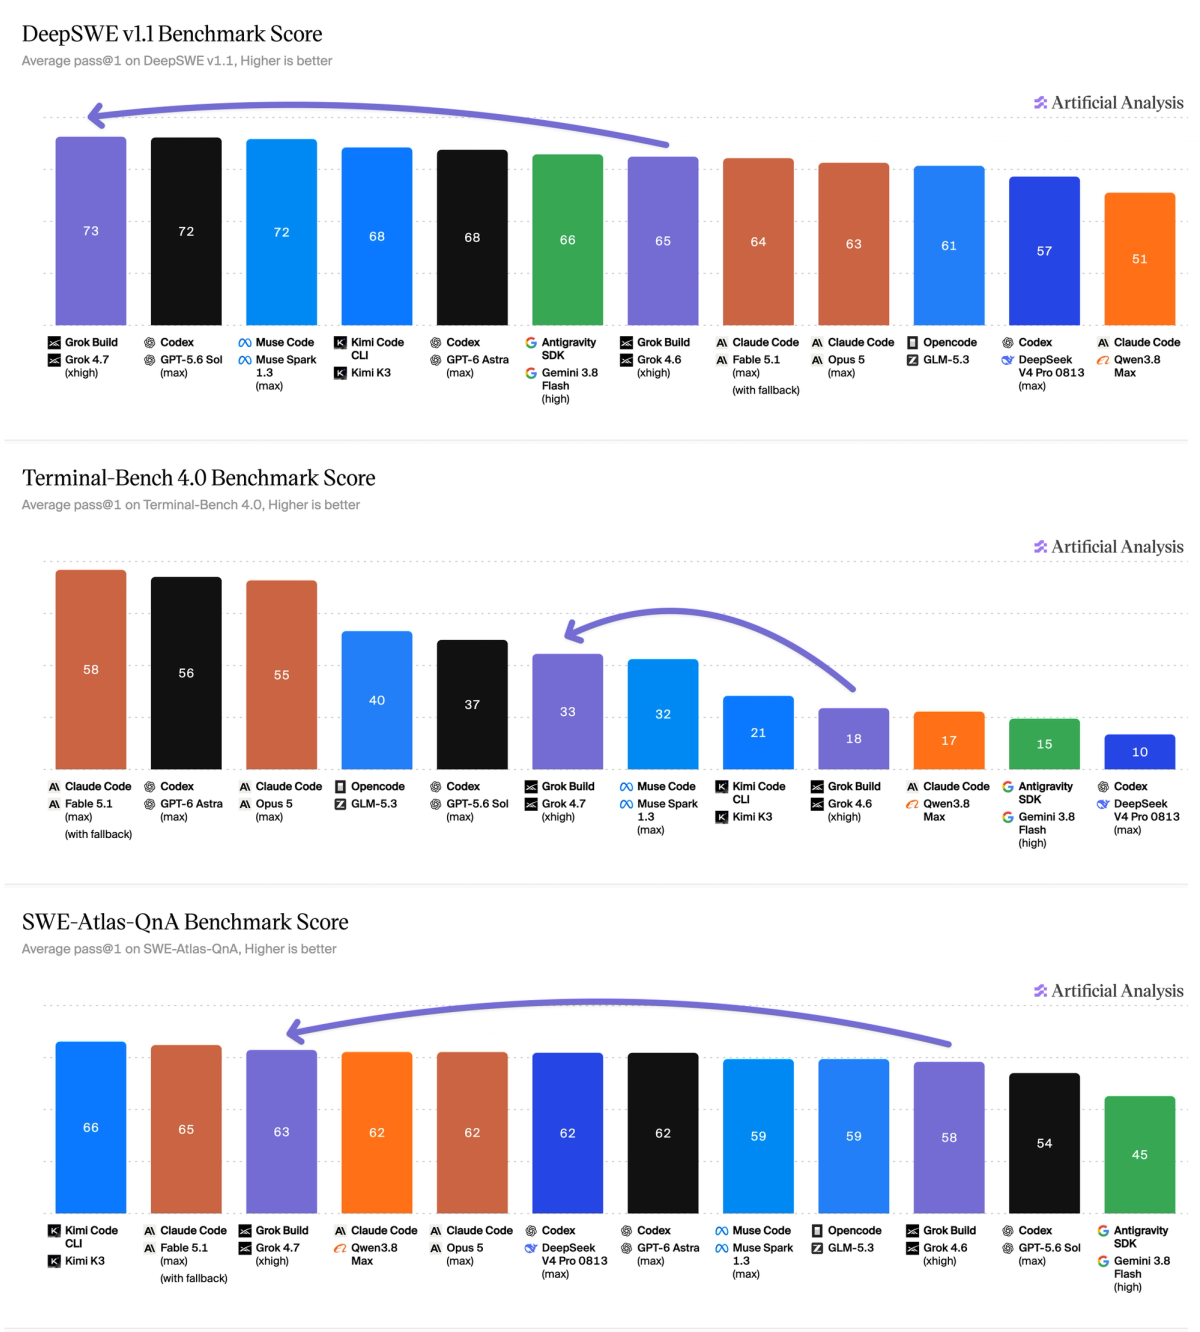
➤ 编码代理性能飞跃: Grok 4.7 (xhigh) 搭配 Grok Build 在 Artificial Analysis 编码代理指数中得分为 56,较 Grok 4.6 (xhigh) 提升 +9 分。在各模型使用其原生框架的情况下,Grok 4.7 + Grok Build 目前排名第 4,仅次于 Claude Fable 5.1、GPT-6 Astra 和 Claude Opus 5。
➤ 其他方面表现为渐进式变化: 除代理式知识工作外,Grok 4.7 在其他智能指数任务上与 Grok 4.6 (high) 大致持平。它在 Terminal-Bench 4.0 (+4.5 个百分点) 和 GDP.pdf (+3.0 p.p.) 上有所改进,但在 AA-LCR (-3.7 p.p.) 和 AutomationBench-AA (-1.1 p.p.) 上出现退步。
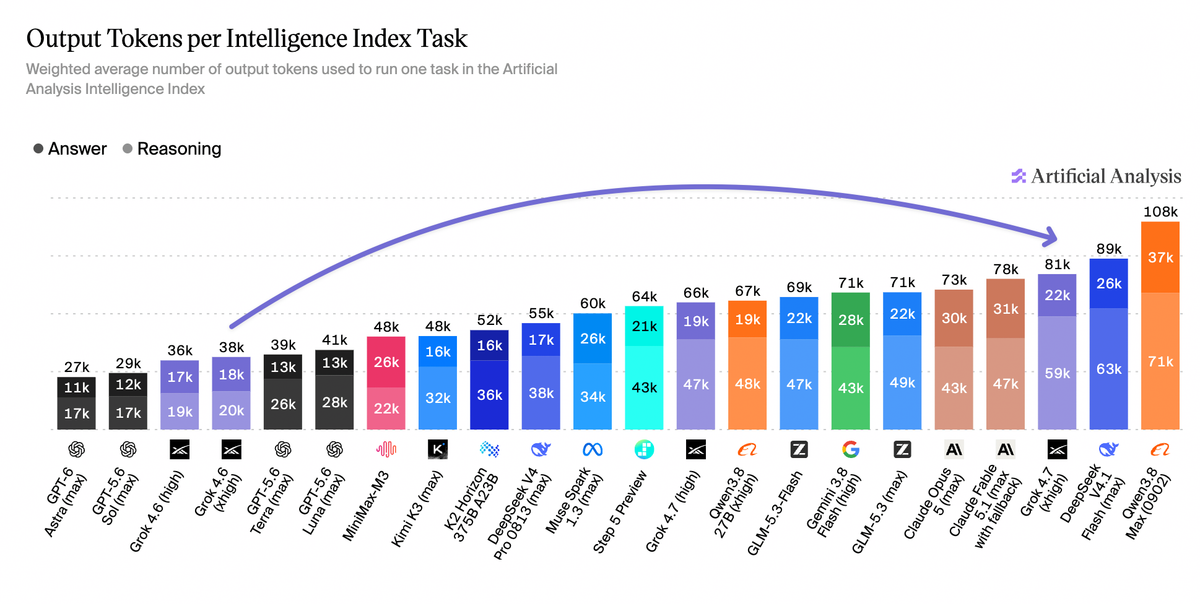
➤ 各任务 Token 消耗较高: Grok 4.7 的性能提升伴随着更高的 Token 使用量。Grok 4.7 (xhigh) 在每个智能指数任务中大约使用 8.1 万输出 Token,而 Grok 4.6 (high) 为 3.6 万,GPT-6 Astra (max) 为 2.7 万——分别多出 125% 和 196%。
其他模型细节:
➤ 上下文窗口为 50 万 Token,与 Grok 4.6 保持不变
➤ 定价为每百万输入/输出 Token 6,缓存命中折扣至每百万 Token $0.50,与 Grok 4.6 一致
➤ 可配置的推理努力度范围从 low 到 xhigh。我们的评估采用 xhigh。
Grok 4.7 在代理式知识工作任务上跻身前沿。 在评估模型处理现实专业工作任务能力的 AA-Briefcase 基准测试中,Grok 4.7 得分为 1657 Elo,较 Grok 4.6 (high) 提升 111 分,排名紧随 Claude Opus 5 和 Claude Fable 5.1 之后。
Grok 4.7 的改进主要体现在分析质量上:其分析质量 Elo 分为 1994,呈现质量 Elo 分为 1499;相比之下,Grok 4.6(high)在这两项上的得分分别为 1690 和 1519。AA-Briefcase 还会检查提交内容是否满足每项任务的要求,从完成分析到产出指定的交付物。
在 GDPval-AA 基准测试中,Grok 4.7 的 Elo 分为 1695,而 Grok 4.6(high)为 1605。这些任务要求模型生成文档、电子表格和幻灯片等实际工作成果。
搭配 Grok Build 使用的 Grok 4.7 (xhigh) 在 Artificial Analysis Coding Agent Index 上得分为 56,高于 Grok 4.6 (xhigh) 的 47。
其在所有三个组成部分上均有提升:DeepSWE v1.1 从 65% 升至 73%,Terminal-Bench 4.0 从 18% 升至 33%,SWE-Atlas-QnA 从 58% 升至 63%。
这些结果评估的是 Grok 与其第一方编码代理 Grok Build 的组合表现。它们与 Intelligence Index 的结果是分开的,后者标准化了跨模型评估所使用的评测框架。
Grok 4.7 的性能提升伴随着更高的 token 使用量。 Grok 4.7 (xhigh) 在 Intelligence Index 上得分为 46,每任务消耗 81k 输出 token,是 Grok 4.6 (xhigh) 所用 38k 的两倍多。作为对比,Muse Spark 1.3 (max) 为 60k,GPT-6 Astra (max) 为 27k。
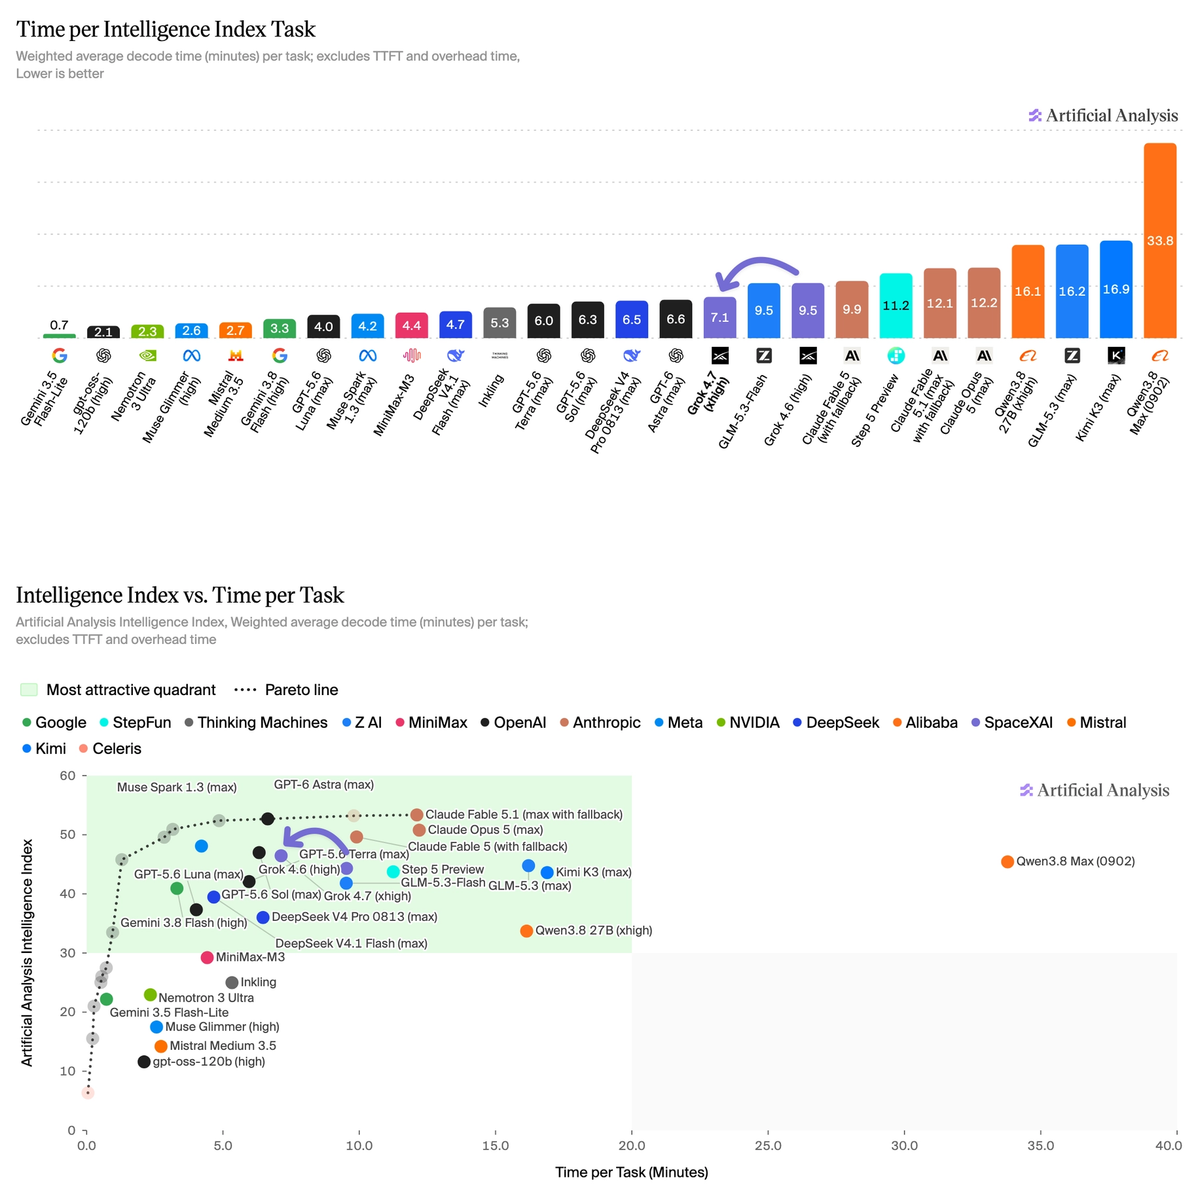
我们的性能测量显示,对于长提示词,Grok 4.7 的答案输出速度约为 188 tokens/秒。 Grok 4.7 在每个 Intelligence Index 任务上平均耗时约 7.1 分钟。
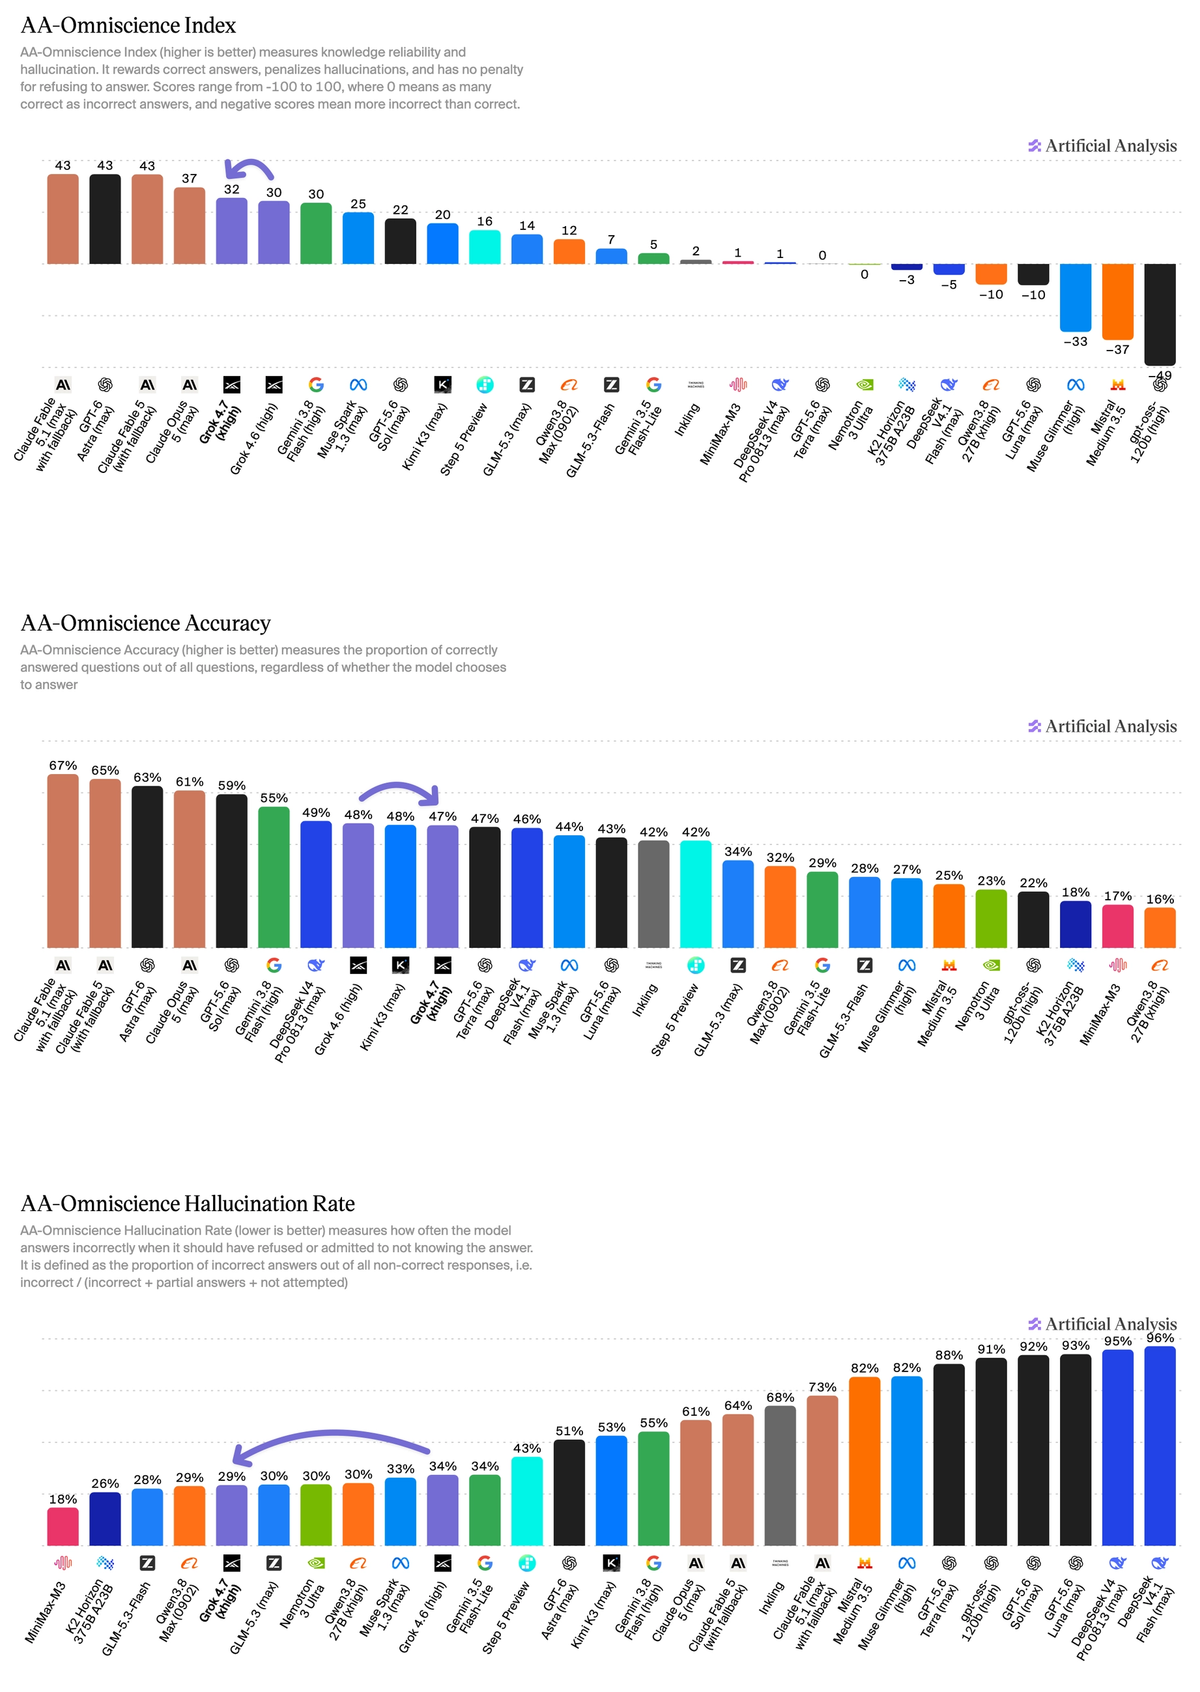
Grok 4.7 (xhigh) 的 AA-Omniscience 幻觉率低于 Grok 4.6 (high):分别为 29% 和 34%。 准确率基本保持不变,分别为 47% 和 48%,整体 AA-Omniscience Index 从 30 提升至 32。
Grok 4.7 (xhigh) 的完整 Intelligence Index 评估细分,以及 Grok 4.6 (high) 和其他领先模型的对比。