webAI 开源 TwIL-8B 小模型逼近前沿编程与数学能力
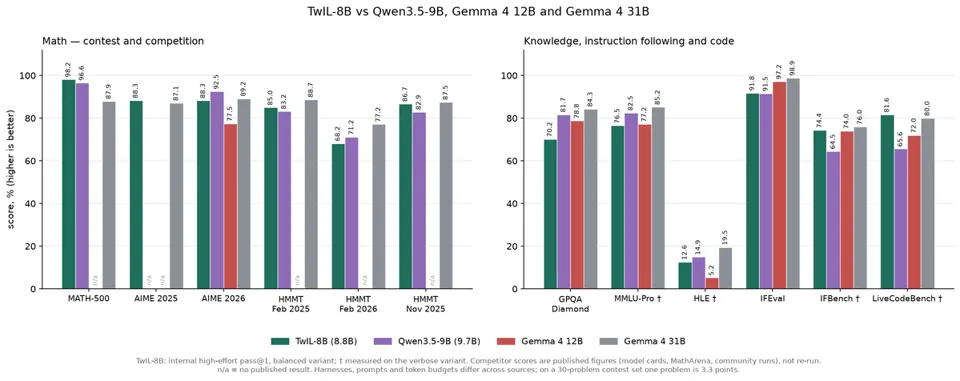
webAI 基于 IBM Granite 4.2 8B 训练并开源了 8.8B 参数的 TwIL-8B,主打数学、编程与指令遵循。官方称其量化后仅 4.98 GiB,可在 CPU 或普通显卡上运行,LiveCodeBench 得分 81.6%,超过 Qwen3.5-9B 与 Gemma 4 31B,并在编程与指令遵循上达到前沿模型约 92%-93% 的水平。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-05 19
webAI (@thewebAI) 刚刚开源了 TwIL-8B,这是一个基于 IBM 的 Granite 4.2 8B 构建的 8.8B 模型,针对数学、编程和指令遵循进行了训练。
TwIL-8B 可装入一个 4.98 GiB 的量化文件,能在 CPU 或普通显卡上运行,把接近前沿水平的编程和数学能力带到人们已经拥有的硬件上。
在 LiveCodeBench 上得分 81.6%,比 Qwen3.5-9B 高出 16.0 分,并领先于 Google 的 Gemma 4 31B——一个规模是其 3.5 倍的模型。
在与 GPT-5.5、Claude Opus 4.8 和 Grok 4.3 的对比中,TwIL-8B 在编程上达到最佳前沿分数的 93%,在指令遵循上达到 92%,在 IFBench 上以 12.2 分的优势击败 Claude Opus 4.8。
最后一个训练阶段会奖励更短的推理过程,使 TwIL-8B 在解决 AIME 2026 问题时比 Qwen3.5-9B 少用 38% 的 token,同时在其对比中取得最高的 MATH-500 分数 98.2%。
↳ 引用 @Davidstout (David Stout): 适度智能的到来比大多数人意识到的要快。
今天,我们开源了 TwIL-8B。
仅 88 亿参数,却在多项高难度基准上接近前沿模型的分数:
• 编程达到前沿性能的 93%
• 指令遵循达到 92%
• 竞赛数学达到 90%
而这一切都来自一个小到可以在你自己的硬件上运行的模型。
但基准并不是这次公告中最重要的部分。
多年来,AI 行业一直专注于构建能力最强的模型,而不计运行它所需的成本。
我相信这个等式正在改变。
下一个 AI 时代将由完成工作的成本来定义。不仅仅是模型的智能,而是这种智能完成任务时的效率。
如果一个 80 亿参数的模型能够可靠地完成与数千亿参数模型相同的工作,为什么要为更大的模型付费?
随着更小的模型变得更强,智能将成为我们可以分发、专门化,并在我们已拥有的硬件上运行的东西。
这就是我们在 @thewebAI 正在构建的未来。
TwIL-8B 今日发布。开放权重。
而这只是我们今天发布的几项公告中的第一项。
HF 链接: