研究称近 6% Agent 技能诱导跳过人工检查
原标题:This paper finds that about 1 in 17 agent skills tells agents to skip human checks, and existing ski...
78AI 研判分
最新研究分析发现,约 1/17 的公开 Agent 技能文件包含“跳过确认”指令,且现有安全扫描器漏检率极高。该研究指出,将此类指令限制在特定上下文(如 CI)并针对“监督缺失”而非仅“恶意代码”进行筛查,是提升 Agent 安全性的关键。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-10-31 11
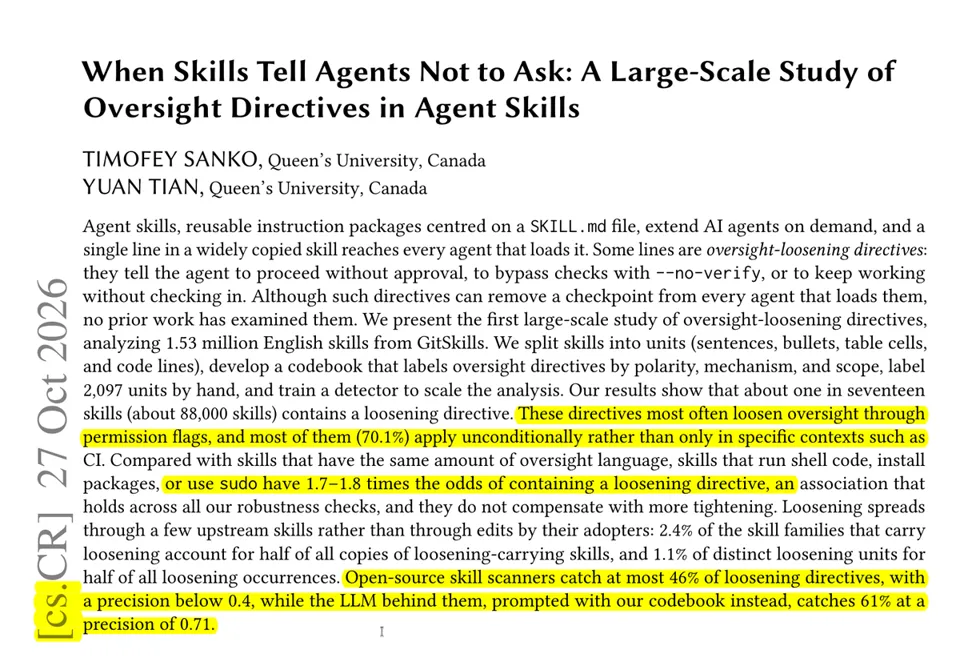
这篇论文发现,大约每 17 个 Agent Skills(智能体技能)中就有 1 个指示智能体跳过人工检查,而现有的技能扫描器大多未能检测到这些情况。
Agent Skills 是共享的 SKILL.md 指令文件,由智能体按需加载。像“无需确认直接推送”或“一直执行直到完成”这样的一行代码,会从每个加载该技能的智能体中移除一个人工检查点。
研究人员分析了来自公共 GitHub 仓库的 153 万个英文技能文件,并测试了 Cisco 和 NVIDIA 提供的两款可调用 GPT-5.4 的开源扫描器。
约有 88,000 个技能包含此类指令,且其中 70.1% 的指令在所有上下文中均生效,而不仅仅是在 CI(持续集成)等特定场景下。这些扫描器的最高检出率仅为 46%,精确度低于 0.4;而当使用同一个 LLM,但询问重点从“恶意行为”转向“监督缺失”时,检出率提升至 61%,精确度达到 0.71。
建议将技能中所有“无需询问”类的指令限制在特定上下文(例如仅限 CI 环境),并在筛查技能时关注监督机制的缺失,而不仅仅是检测恶意软件。