Meta 提出 WM-Basin 检测蒸馏模型水印残留
原标题:New Meta paper finds that a model distilled from watermarked API outputs keeps a hidden, key-specifi...
85AI 研判分
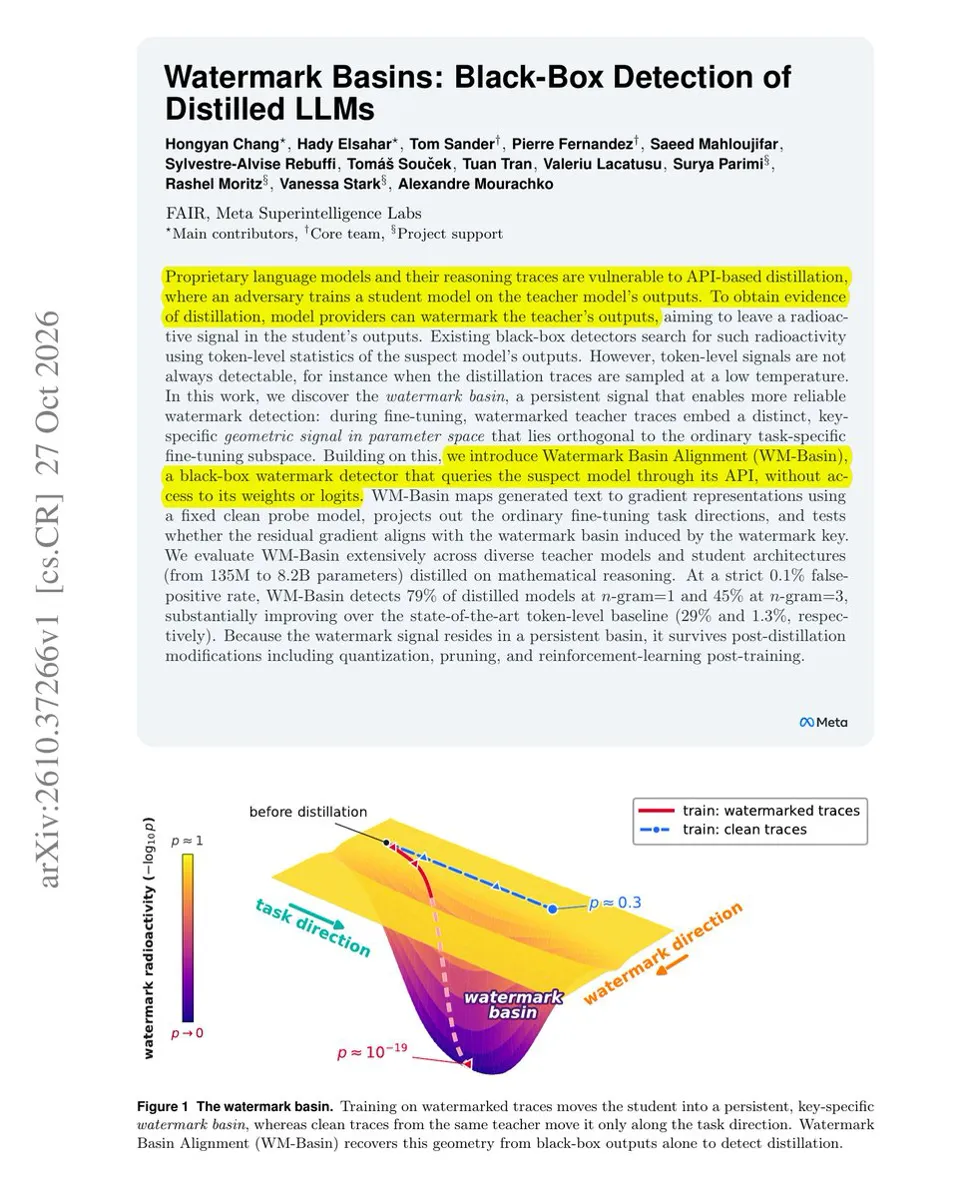
Meta 最新研究指出,从带水印 API 输出中蒸馏的模型会在权重中保留隐藏的密钥特定痕迹。新方法 WM-Basin 通过分析文本梯度与固定探针模型的匹配度,在低误报率下将检测准确率提升至 79%,显著优于传统基于 Token 计数的方法,且对量化和剪枝具有鲁棒性。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-10-30 08
Meta 最新论文发现,从带水印的 API 输出中蒸馏出的模型会在其权重中保留一种隐藏的、与密钥相关的痕迹,且仅通过该副本生成的文本即可读取这一痕迹。
目前的检测器主要统计可疑文本中的水印 token,但在低温采样(low-temperature sampling)生成的多数副本上往往失效。
研究发现,水印痕迹会将学生模型的权重推向一个微弱但特定于密钥的方向。WM-Basin 方法将可疑对象的 API 输出转化为固定探针模型(probe model)的梯度,并测试这些梯度是否与真实密钥匹配,以此区别于诱饵密钥。
在 1,200 个蒸馏模型上,以 0.1% 的假阳性率为基准,该方法对 n-gram=1 的水印检测率达到 79%,而传统的 token 计数法仅为 29%。量化、轻度剪枝和 RL 后训练并未消除这种痕迹,尽管在干净数据上进行更多微调会削弱它。
– arxiv. org/abs/2610.37266
标题:"Watermark Basins: Black-Box Detection of Distilled LLMs"(水印盆地:蒸馏大语言模型的黑盒检测)