viiwork 实现跨主机 KV Cache 共享
viiwork 推出 KV-cache sharing 功能,允许在两台 RTX 5090 主机间通过以太网同步大模型推理的键值缓存。该机制解决了长上下文会话在负载均衡切换时因缓存丢失导致的重复预填充(prefill)延迟问题,显著提升了多节点部署下的响应效率。
关联知识实体
报道正文
本文目录5 个章节
大型语言模型(LLM)不会在每一轮对话中从头重新阅读整个上下文。当它处理提示词时,每一层都会为每个 token 生成键和值张量——这就是 KV 缓存(也称为提示缓存)。保留该缓存,模型就可以直接跳到生成下一个 token;如果丢失了缓存,它必须先将整个提示词重新推入模型运行一遍,这一步骤称为 预填充(prefill)。在一个漫长的编码代理(coding-agent)会话中,这可能意味着在第一个新 token 出现之前需要读取数万个 token——导致几秒到几分钟的等待时间。
问题在于,这个缓存存在于服务该轮次的 GPU 进程中,且仅位于单台机器上。viiwork mesh 通常会将同一会话的下一轮请求发送回同一主机,原因正是如此:其缓存仍然是“热”的。但是,当该主机繁忙时,请求必须在其他地方运行,而新主机则是“冷”启动的——在能够回答之前需要进行完整的预填充。
KV 缓存共享是 viiwork 解决这一问题的方法。 在一轮对话结束后,kv_share 会通过网络将会话缓存的一份副本复制到该会话接下来可能溢出到的主机上。当切换发生时,接收主机将 导入 该副本而不是重新计算提示词,从而使会话以“热”状态恢复。只有当副本在下一轮请求到达之前传输到另一台主机时,这种复制才有帮助——因此两台主机之间的链路质量至关重要。
本文旨在探讨这种链路的重要性究竟有多大。我在两台 RTX 5090 机器上运行了相同的编码代理工作负载,同时改变它们之间的连接方式:通过 LAN 交换机的 1 GbE、承载 Tailscale 流量的直连 10 GbE 线缆,以及直接发送 kv_share 数据的同一根线缆。每台主机有四个模型槽位。代理根据规格说明构建一个待办事项应用,我测量了 90 分钟内 12 个会话和 16 个会话的运行情况。
为什么会话会迁移? 因为当下一轮请求到达时,主机可能正忙。优先将对话保留在其拥有热缓存的主机上的策略被称为 会话亲和性(session affinity);当该主机满载时,请求就会迁移,而
kv_share使得这种迁移的成本变得低廉。配套的 会话亲和性研究 展示了为什么保持会话靠近其缓存从一开始就很重要。
如果没有共享,切换将以冷启动开始
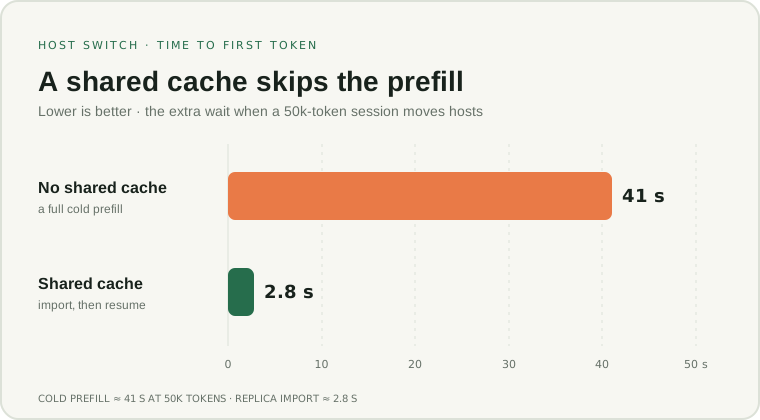
要理解复制带来的收益,不妨设想一下没有它的情形。当某一轮对话被调度到一台从未见过该会话的主机上时,这台主机没有任何可复用的缓存:在生成第一个新 token 之前,它必须将整个 prompt 重新跑一遍模型。成本随 prompt 长度线性增长,而编码 Agent 的 prompt 会全天不断膨胀。显卡越慢、对话越长,情况就越糟——在一块较旧的 RTX A4000 上,50,000 tokens 的冷启动 prefill 大约需要 41 秒;而在 gfx906 集群上处理 200,000 tokens 则需要数分钟。虽然在快速的 RTX 5090 上速度更快,但这仍然是纯粹的重复劳动:接收端主机不得不重新推导一份 KV Cache,而这份缓存其实刚刚还存在于会话离开的那台主机上。会话亲和性(Session affinity)通常能通过让会话固定在某台主机上来避免这种情况,但当主机负载过高时,迁移不可避免;若没有共享缓存,每一次强制迁移都要付出这种冷启动 prefill 的代价。
Strata 上的复制机制是如何工作的
这里运行模型的引擎是 Strata,它为 Qwen3.8-Flash-Next 混合专家(MoE)模型提供服务,并为每个对话维护独立的缓存。kv_share 是由 viiwork 驱动的一项 Strata 功能,它通过三个步骤来移动缓存:
- 保存(Save)。 当一轮对话的长度足以值得进行缓存同步时(默认为 8,192 tokens,因为短对话的 prefill 成本很低),执行该轮对话的主机会请求 Strata 将会话保存到文件中。
- 发送(Send)。 它将这个文件发送给会话接下来最可能溢出到的那一个成员节点,而不是广播给所有节点。而且只有*增量数据(delta)*会被传输:对于每 50k tokens 的一轮对话,大约只需传输 1 GB 缓存中的 240 MB,因为大部分对话内容在前一轮已经发送过了。
- 导入(Import)。 在会话下一轮于接收端主机运行之前,viiwork 会将副本导入 Strata 的缓存中。Strata 仅在 prompt 仍然匹配时才从该副本恢复,因此如果副本过期或缺失,只会导致导入失败,不会造成更严重的后果——失败的导入仅会使该轮对话以冷启动方式服务,就像完全没有共享一样。
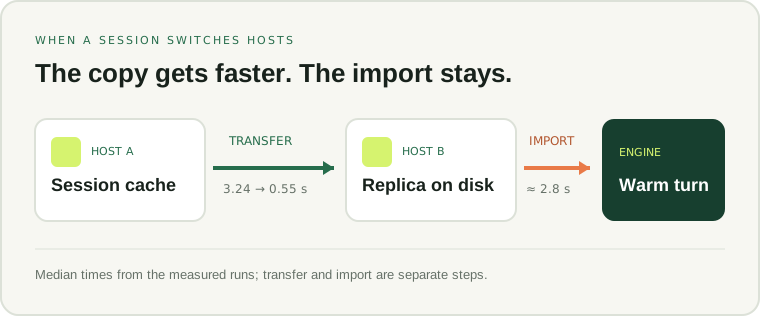
完整的机制、其配置(group、min_tokens、max_gib)以及相关要求详见 kv_share 文档。保存和导入操作在每台主机上分别执行;唯一由网络决定成本的步骤是中间的发送环节——而这正是本实验所优化的部分。
缩短线缆加速了复制过程
图表采用 16 会话运行数据,此时负载保持繁忙,各阶段最具可比性。典型的副本差异约为 247 MiB。在 1 GbE 下,发送耗时 3.24 秒。通过 Tailscale 使用 10 GbE 线缆时,耗时降至 0.81 秒。绕过 Tailscale 后,发送时间进一步缩短至 0.55 秒。
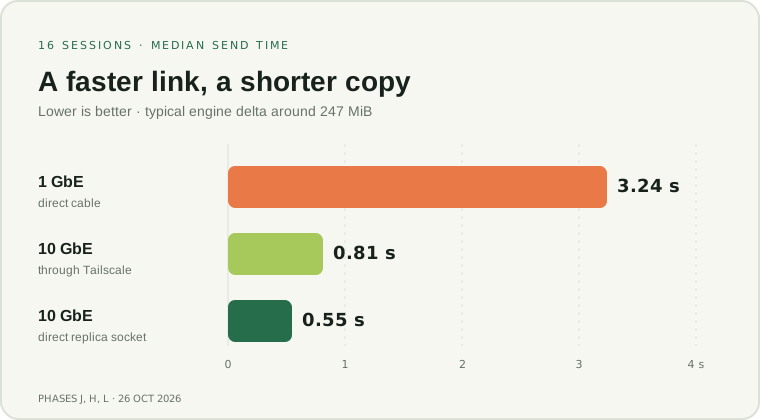
原始线缆在单流测试中承载了 9.41 Gb/s 的带宽;而 Tailscale 仅能承载约 3.0–3.4 Gb/s。这解释了为何第一次提速约为四倍而非十倍。直接套接字连接再次更快,但此时接收端的读取、哈希计算和写入副本操作似乎成为了瓶颈。
轮次命中率是否提高了?
是的,略有提升。在 16 会话对比中,主机切换时的缓存命中率从直接 1 GbE 下的 93.8% 提升至 通过 Tailscale 的 10 GbE 下的 96.8%。那些复用部分但未完全复用提示词的切换比例从 5.4% 降至 2.2%。更快的复制更有可能在下一轮请求到达之前传输到另一台主机。
直接 10 GbE 运行发送副本的速度更快,但其热缓存命中率为 96.2%。这一数值与 96.8% 的差异在这些运行的波动范围内。在此负载下,移除 Tailscale 改善了传输时间,但未带来明显的端到端缓存收益。将直连电缆强制降速至 1 GbE 也复现了交换式 1 GbE 的发送时间,因此局域网交换机本身并非瓶颈。
仍然缓慢的部分
向接收端引擎导入数据在任何链路速率下仍需约 2.8 秒。在负载较重的运行中,冷切换(cold switches)比例仍维持在 1–2% 左右。追踪日志显示了一个反复出现的软件问题:viiwork 记住了它已导入某个副本,但引擎随后可能将该对话从缓存中驱逐。当再次访问时,尽管引擎不再持有该缓存,viiwork 却跳过了导入操作。这个 import-once(仅导入一次)bug 已在 viiwork v2.11.1 中修复,修复方法是在跳过导入前询问引擎当前仍持有哪些内容。
对于这两台主机和此工作负载而言,1 GbE 是可用的:平均 kv_share 流量在每个方向约为 320–450 Mb/s,且大多数切换都是热切换(warm)。10 GbE 链路使传输更及时,并减少了部分热切换(partly warm turns)的情况。更大的剩余收益在于引擎导入和缓存正确性,而非更多的网络带宽。
方法说明:这些是每个配置的单次 90 分钟运行,并非重复的统计试验。12 会话运行的负载不够均匀,因此上述比较使用了 16 会话的 J、H 和 L 阶段。“热”切换复用了至少 90% 的提示词;“部分热”切换复用了 30–90%。测量于 2026 年 10 月 26 日进行,使用 viiwork v2.11.0-beta1 和 Strata 0.2.6,在 import-once 修复之前。