Microsoft Research · 2026/10/13 00:00:00
微软开源 StudentSim:基于真实数据训练个性化 AI 学生模拟器以加速智能辅导迭代
微软研究院发布并开源了 StudentSim,这是一个用于评估和改进 AI 导师系统的研究框架。该系统利用公开的去标识化学员记录训练个性化的“AI 学生”模拟器,作为人类学生的快速代理,从而解决传统人工反馈收集成本高、速度慢且难以规模化的痛点。通过模拟特定学生的反应模式及学习更新能力,StudentSim 允许开发者在接触真实学习者之前高效迭代辅导策略。
报道全文原始报道全文
本文目录5 个章节
概览
- StudentSim 是一个用于在真实学习者测试前评估和改进 AI 导师的研究系统;它不是产品,未部署在课堂中,也不旨在取代教师
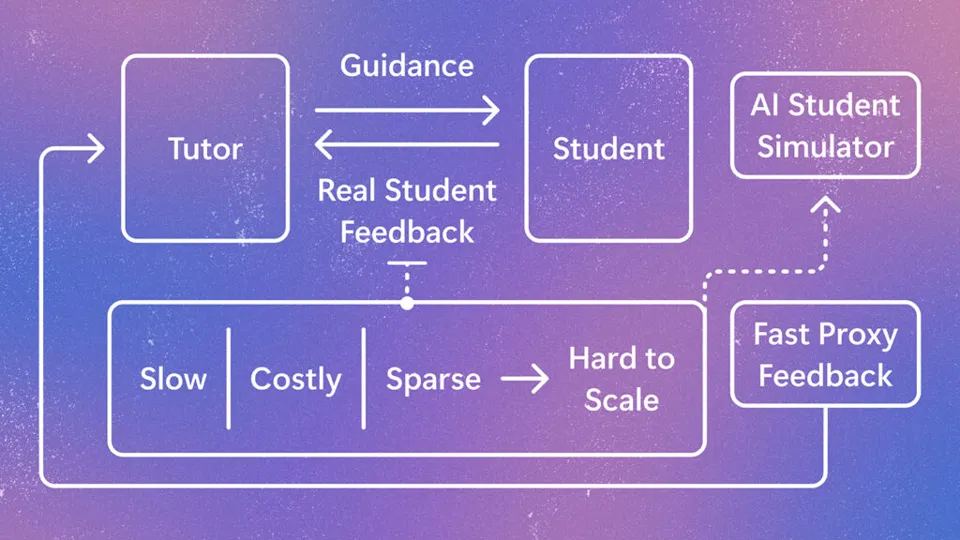
- AI 辅导工具需要来自学生的反馈才能改进,但通过人类研究收集这些反馈速度慢、成本高且难以扩展
- StudentSim 利用公开可用、去标识化的学习者记录训练个性化 AI 学生模拟器,为每个学生适配一个模拟器
- 该工作从两个教育导向的维度评估模拟器:它们是否像特定学生那样做出反应,以及它们在导师指导后是否会更新
- 在国际象棋、第二语言英语写作和数学领域,StudentSim 优于领先的基线模型,并为训练 AI 导师提供了有用的反馈信号
在研究环境中,团队正在探索 AI 驱动的辅导系统如何帮助解释数学问题、建议修改写作作业或引导学习者分析棋局位置。然而,教学质量不能仅从导师的回答来衡量。导师需要了解指导传达给学生后发生了什么。学生是否纠正了最初的错误?提示是帮助他们推理得出答案,还是泄露了太多信息?不同的学生是否需要不同类型的支持?在当今的 AI 导师研究中,回答这些问题通常需要进行真实的学习者研究。这些研究很有价值,但运行起来缓慢且昂贵,这使得在快速的模型迭代过程中利用学生反馈变得困难。
StudentSim 是一个 AI 系统,旨在创建个性化的学生模拟器,模拟个体学生如何回答问题以及在接受导师指导后其回答如何变化。其目标是让 AI 导师开发过程中更容易获取学生反馈。这项研究还引入了 StudentSimEval,这是一个涵盖国际象棋、第二语言英语写作和数学的基准测试与评估协议。
重要的是,该目标并非取代教师或课堂学习。相反,StudentSim 帮助研究人员在与真实学习者进行测试之前,在研发阶段评估和改进 AI 辅导系统。该研究仅使用为研究目的发布的公开可用学习者数据集,且记录已去标识化;在任何阶段均不使用个人身份信息。
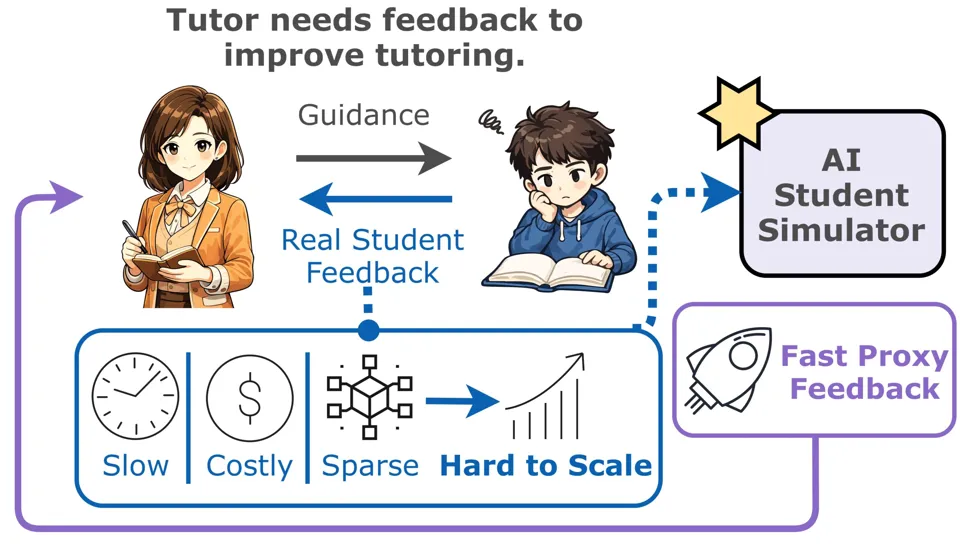
图 1: AI 导师需要来自学生的反馈才能改进。学生模拟器可以在研究阶段的训练和评估中近似提供部分此类反馈。它们提供的是早期研究信号,而非替代对真实学习者的测试。
衡量学生模拟器所需具备的能力
构建学生模拟器的一种简单方法是让大型语言模型(LLM)扮演学习者角色。例如,提示词可以设定为:“你是一名在数学方面遇到困难的小学生。”模型可以调整语气并表达不确定性。更难的部分在于保留学习者实际的能力边界。模型可能以年轻学生的口吻说话,却仍然依赖远超该学生水平的知识和推理能力。对于训练 AI 导师而言,这可能会产生误导性的反馈:由于模拟的学生过于能干,导师可能显得非常有效。
传统的学生建模方法面临着另一种局限。知识追踪和行为预测模型基于真实的学习记录,能够评估学生当前的知识、技能和学习习惯。然而,许多此类模型并非设计用于接收自然语言形式的导师指导作为输入。它们有助于描述学生做了什么,但并不总能告诉我们学生对特定解释、提示或苏格拉底式提问会如何反应。
StudentSim 通过受教育学研究启发的两个维度来定义目标。教育者通常区分学习者独立能做什么与在支持下能做什么。维果茨基的“最近发展区”(Zone of Proximal Development)捕捉了当前独立表现与有指导表现之间的差距。StudentSim 将这一理念转化为两个评估目标。行为保真度(Behavioral fidelity)衡量模拟器是否在保留测试题上匹配特定学生的记录响应。指导响应性(Guidance responsiveness)衡量模拟器在阅读导师指导后是否更新其响应。
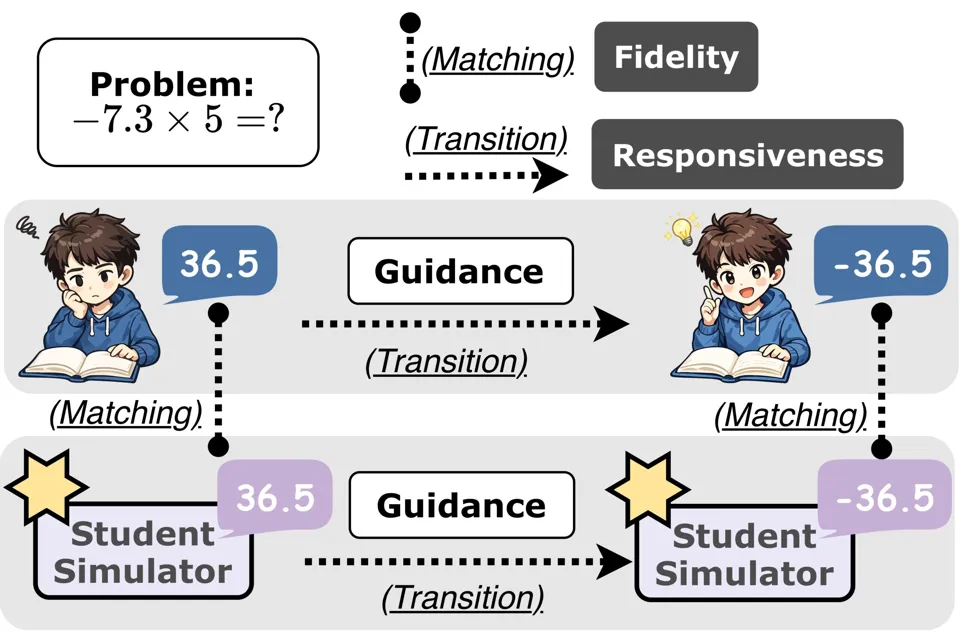
图 2:StudentSimEval 评估模拟器是否匹配学生的独立行为以及是否对指导作出响应。
这两个目标是互补的。一个仅匹配过去学生行为的模拟器可能对预测有用,但它无法显示教学干预是否有效。一个总是遵循导师指令的模拟器可能响应流畅,但可能无法代表特定学生的优势、弱点和可能犯的错误。AI 导师训练需要这两种信号:学习者的起点以及指导如何影响学习者的表现。
从稀疏的学生记录中训练个性化模拟器
StudentSimEval 完全基于公开可用的学习者数据集构建,这些数据集以去标识化记录的形式发布,供研究使用。记录中不包含任何个人身份信息,且每个个性化模拟器仅使用其所代表学生的去标识化记录进行训练。
在个体层面,真实学生数据往往较为稀疏。一名学习者可能仅提供少量作文、答案或交互记录。如果为每个学生从零开始单独训练一个模拟器,不仅存在过拟合风险,还要求每个模型重新学习该领域中的常见模式。
StudentSim 采用两阶段训练流程。在第一阶段,模型在同一领域的众多学生汇总记录上进行训练。这一阶段旨在学习常见的回复格式、典型错误以及学生在获得指导后的常见修改方式。在第二阶段,模型针对单个学生自身的记录进行专门化训练,从而为该学生生成个性化模拟器。
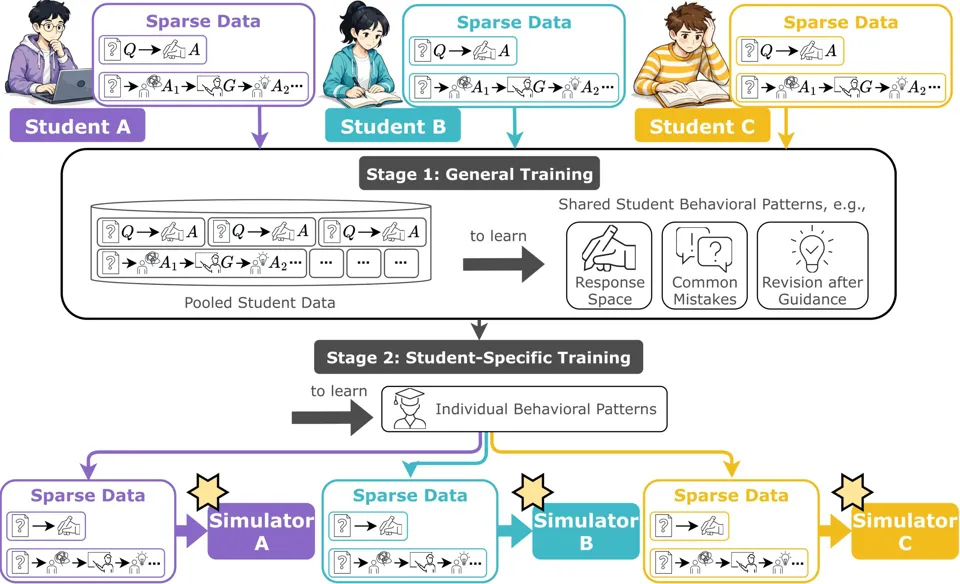
图 3:StudentSim 首先从汇总记录中学习共享的学生行为模式,然后适应每个学生的自身数据。
评估涵盖三个具有不同响应类型的领域。在国际象棋中,模拟器预测玩家的下一步走法,以及玩家在教练指导后可能进行的调整。在第二语言英语写作中,它生成包含与学习者匹配的错误模式的作文,并预测教师在反馈后学生所做的修正。在数学领域,它预测学生的多项选择题答案,以及学生在听取解释后是否更新其答案。在这些领域中,StudentSimEval 遵循相同的原则:在所有方法之间,使用相同的每学生训练记录和相同的留出评估记录进行比较。
StudentSim 在三个领域均优于领先的基线模型。以国际象棋为例,StudentSim 的行为保真度达到 0.5150,指导响应性达到 0.9067。相比之下,GPT-5.4 的这两项指标分别为 0.2316 和 0.7186。Maia2 是一款专门用于预测人类走棋的国际象棋模型,其两项指标分别为 0.4535 和 0.2721。这一对比揭示了不同基线模型家族之间的差异:GPT-5.4 能够响应指导,但无法可靠地匹配特定学生的行为模式;而 Maia2 虽然能更准确地预测人类的国际象棋走法,却缺乏自然语言指导通路。
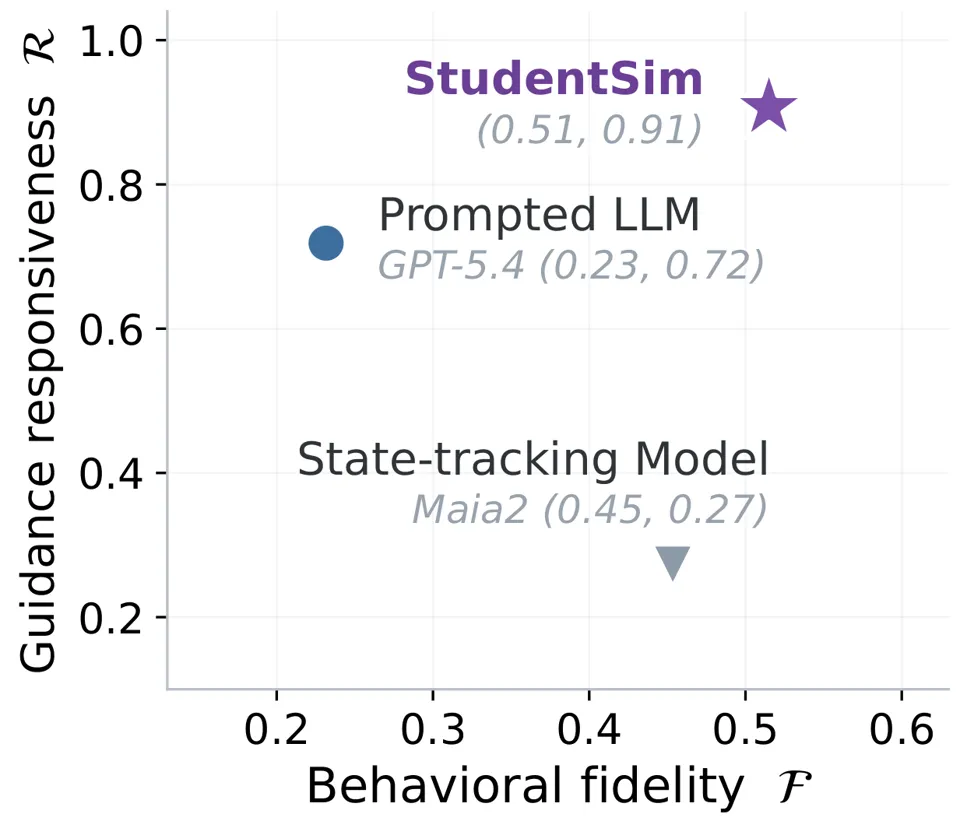
图 4:在国际象棋任务中,与领先基线模型相比,StudentSim 同时提升了行为保真度和指导响应性。
该研究还测试了经过训练的学生模拟器是否能为导师优化提供反馈。在一项国际象棋导师强化学习研究中,导师接收一个棋盘局面以及真实学生上一步的错误走法,然后生成指导信息。在此过程中,学生模拟器的参数保持固定,它读取指导信息并生成修正后的走法。奖励机制基于从学生上一步走法到模拟器修正后走法的质量提升程度,并使用 Stockfish 作为独立的国际象棋引擎信号进行评估。
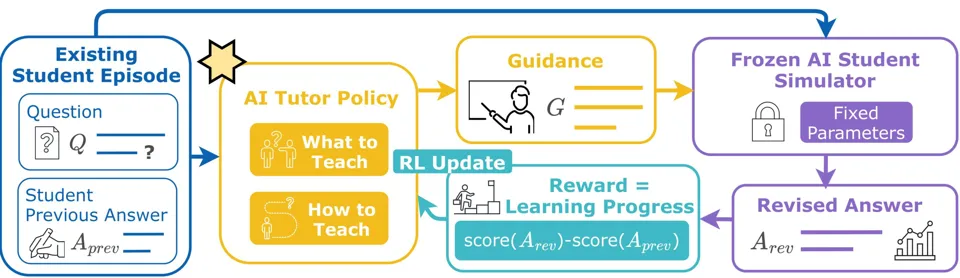
图 5:StudentSim 可通过估算学生在接受指导后响应如何变化,在 AI 导师的强化学习中提供反馈。
本研究比较了三种条件:未经过强化学习的监督微调导师、以 GPT-5.4 作为模拟学生奖励源训练的导师,以及以 StudentSim 作为奖励源训练的导师。所有条件均使用相同的导师策略、监督起始点和强化学习设置。随后,人类国际象棋专家在盲测条件下对导师的回复进行评估。
在所有报告的维度上,基于 StudentSim 奖励训练出的导师获得了最高评分。与无强化学习基线的 75.7% 准确率相比,使用 StudentSim 训练的导师达到了 90.5% 的准确率;相比之下,GPT-5.4 奖励条件下的准确率为 71.6%。此外,它在指导质量和个性化方面也得到了更高的评价。这一结果证明了概念可行性:基于真实学习者数据训练的学生模拟器可以为改进 AI 导师提供有用的反馈。
展望未来
StudentSim 并不能取代教育研究中真实学习者的需求。人类研究对于衡量学习成果、安全性、可用性以及课堂适配度仍然至关重要。学生模拟器的作用在于开发过程的早期阶段:它们可以帮助研究人员测试导师策略、比较模型,并在转向成本更高的真实学生研究之前优化训练信号。
更宏观的方向是构建能够从学生反应中学习的 AI 导师系统,而不仅仅依赖专家撰写的解释或静态的正确性标签。StudentSim 展示了一条可行路径:利用真实的学习记录训练个性化模拟器,在独立行为表现和对指导的响应两方面评估这些模拟器,并将其作为可扩展的反馈源用于导师训练。未来的工作可以将这一方法扩展到更长的学习轨迹、更多学科、更丰富的学生画像,以及将模拟反馈与真实学习成果相关联的研究。
论文及 StudentSim 的训练和评估代码(包括 StudentSimEval 协议)均已公开发布。
来源
在新标签页中打开
文章 通过模拟学生学习提升 AI 辅导效果 首发于 Microsoft Research。