The Decoder · 2026/10/16 23:03:46
谷歌 Gemini 4 Argon 攻克 ARC-AGI-3 基准,但数学与编程仍落后竞品
谷歌 DeepMind 发布前沿模型 Gemini 4 Argon,在 ARC-AGI-3 基准测试中得分 97.5%,成为继 OpenAI 之后第二家突破 95% 大关的实验室。然而,Epoch AI 指出该成绩高度依赖特定测试框架(Provider Adapter Harness),且模型在数学推理和软件工程领域的表现分别仅排第八和第六,显示其通用能力存在明显短板。
报道全文原始报道全文
本文目录2 个章节
Google Deepmind 成为第二家 ARC-AGI-3 基准测试得分超过 95% 的主要 AI 实验室。但据 Epoch AI 指出,测试结果高度依赖于测试方法,且 Argon 在数学和软件工程方面落后于竞争对手。
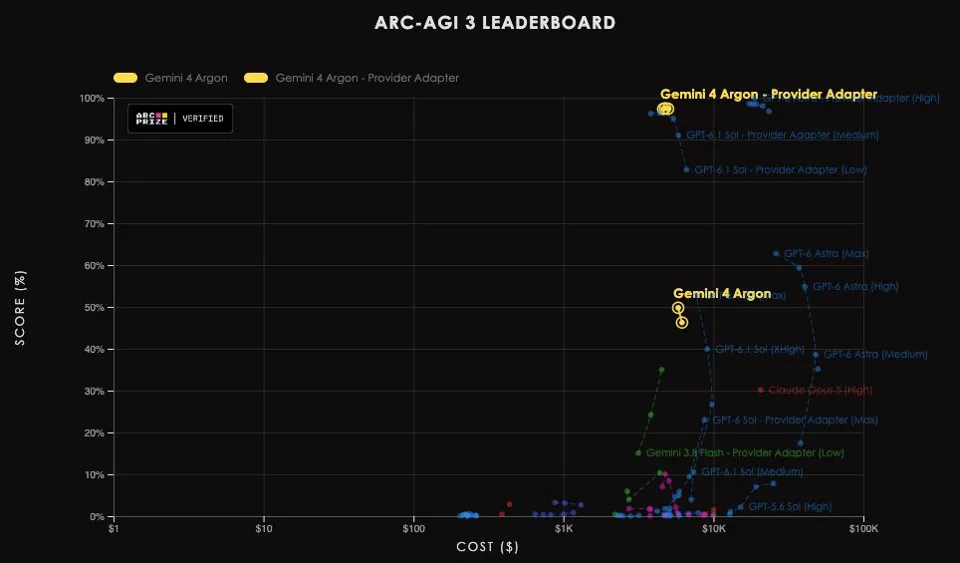
Google Deepmind 的新前沿模型 Gemini 4 Argon 在使用“Provider Adapter Harness”(一种利用保留推理和上下文压缩等供应商特定功能的测试设置)的情况下,以 4,800 美元的成本在 ARC-AGI-3 上取得了 97.5% 的分数。根据 ARC Prize 的数据,Google 现已成为继 OpenAI 之后第二家在广泛被认为是最具挑战性的通用问题解决基准测试中突破 95% 大关的 AI 实验室。目前仅有 GPT-6 Astra 以 99.9% 的分数高于它。
在 ARC-AGI-3 的 25 个公开游戏中,Gemini 4 Argon(黄色)和 GPT-6 Astra(蓝色)所需的操作次数均比人类基线(紫色)少 62%,并且经常接近速通记录(红色)。| 图片:ARC Prize
与 Astra 类似,Argon 在这 25 个公开游戏中所需的操作次数也比人类基线少 62%。它在三个游戏中追平或打破了速通记录,并在另外六个游戏中将成绩控制在最佳时间的 10% 以内。在该基准测试的旧版本中,基于每百万输入 token 2 美元、每百万输出 token 10 美元的入门价格,Argon 在 ARC-AGI-2 上的得分为 91.3%(每个任务成本 0.32 美元),在 ARC-AGI-1 上的得分为 98.5%(每个任务成本 0.16 美元)。
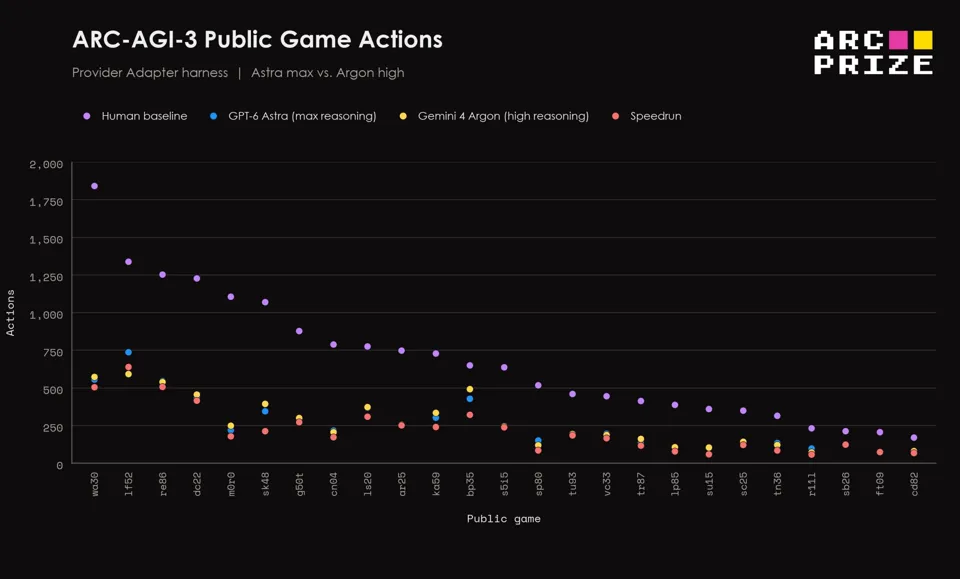
在 ARC-AGI-3 的 25 个公开游戏中,Gemini 4 Argon(黄色)和 GPT-6 Astra(蓝色)所需的操作次数均比人类基线(紫色)少 62%,并且经常接近速通记录(红色)。| 图片:ARC Prize
基准测试结果高度依赖于测试设置
在仅允许回合间进行简单笔记的“标准测试框架”(Standard Harness)中,Argon 在低推理模式下的得分降至 49.8%,成本为 5,800 美元。这一差距可追溯至 2026 年 7 月的一场争议,当时 OpenAI 的 GPT-5.6 Sol 利用两种 API 设置在 ARC-AGI-3 上击败了 Claude Opus 5。
GPT-5.6 Sol 在标准环境中仅获得 7.8% 的成绩,该环境会在每次行动后丢弃内部推理过程,并使用了一个缺乏较新 Claude API 功能的旧接口。这意味着 Claude 是在与 GPT-5.6 Sol 不同的条件下进行测试的。当使用 OpenAI 自家的 Responses API 进行测试时,包括启用“保留推理”(Retained Reasoning)和智能上下文“压缩”(Compaction)功能,模型得分跃升至 38.3%,超过了 Opus 5 的 30.2%。OpenAI 辩称,基准测试始终也在衡量技术环境。ARC Prize 联合创始人 Francois Chollet 随后允许使用通用的、公开可用的 API 设置。
据测试人员称,API 问题也导致 Argon 无法在标准测试框架中完成全部 55 局游戏。在低推理模式下,系统完成了 42 局游戏(49.8%),中等推理模式下完成了 46 局游戏(46.3%)。在最高推理级别下,它仅完成了 19 局游戏,因此 ARC Prize 未公布其得分。报告中的结果通过包含中止运行的部分得分,仍涵盖了全部 55 局游戏。
Argon 缩小了差距,但在数学和编程方面落后
研究机构 Epoch AI 也追踪了 Google 的进展。Argon 在 Epoch 能力指数(ECI)上 获得了 165 分,与 Fable 5.1 持平,略低于 Opus 5.5(167 分)和 GPT-6 Astra(166 分)。ECI 将 50 多个基准测试整合为一个单一的能力量表,类似于 Artificial Analysis 构建其主评分的方式。
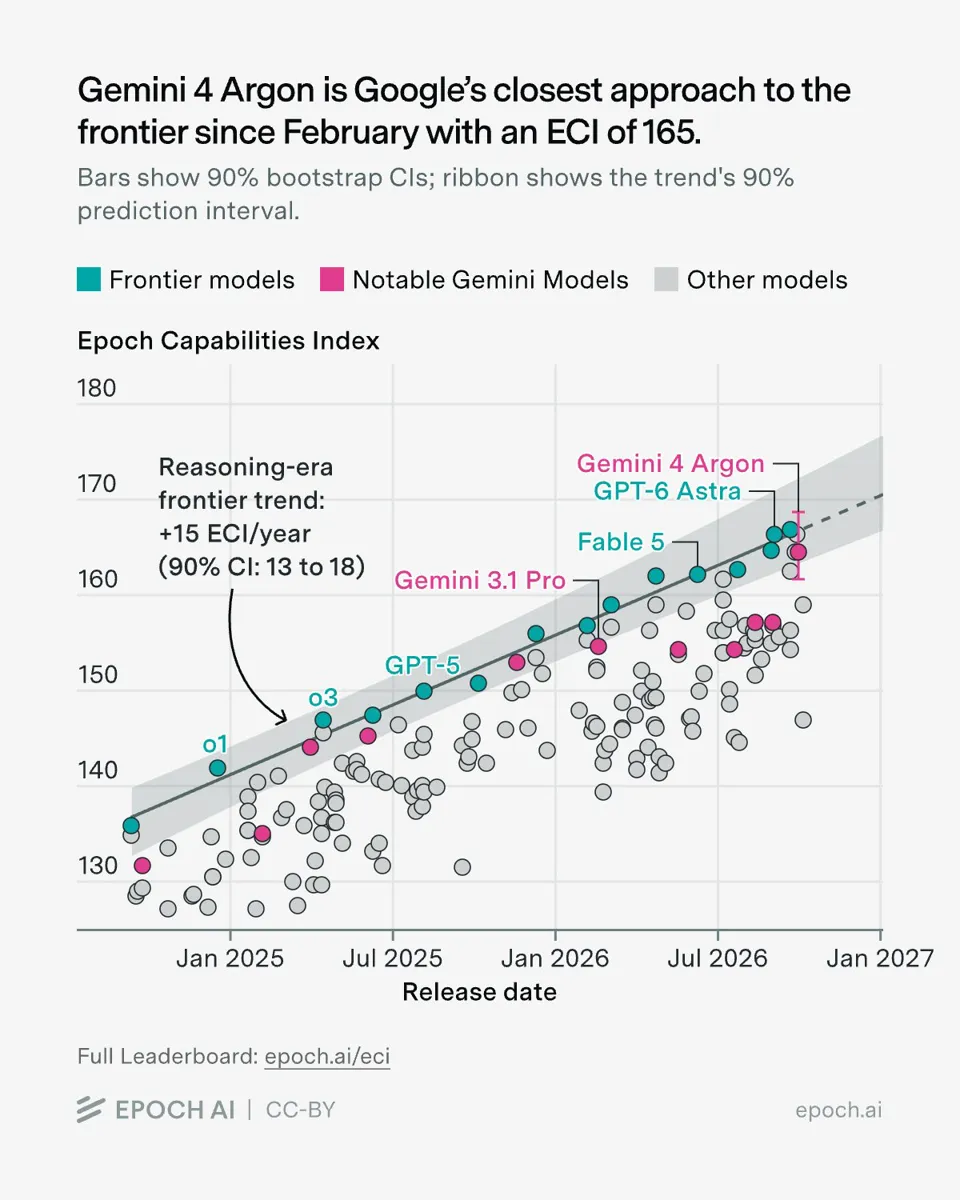
凭借 165 分的 ECI 得分,Google 比自 2026 年 2 月 Gemini 3.1 Pro 以来更接近由 GPT-6 Astra(166 分)和 Opus 5.5(167 分)引领的当前 AI 前沿水平。| 图片:Epoch AI
Argon 大幅领先于 Gemini 3.8 Flash(157 分),使 Google 的排名更接近榜首,这是自二月份 Gemini 3.1 Pro 以来的最佳表现。Artificial Analysis 和 Vals.ai 此前已证实了这一趋势。
不过,性能表现因领域而异。根据 Epoch AI 的数据,Argon 在多个知识、智能体(agent)和视觉基准测试中处于领先地位,但初步估算显示,其在数学 ECI 上排名第八,在软件工程指数(SWE ECI)上排名第六。