Gemini 4 Carbon 发布 智能体基准跃居第二
Google DeepMind 推出 Gemini 4 Carbon,在基于真实任务的 Agent Arena 中排名第 2,净提升 16.2%。该模型在成本、时间和输出 Token 效率上处于帕累托前沿,相比前代 Argon 在任务完成率和可控性上有显著改进。
报道正文
Arena.ai (@arena) · 2026-10-28 21
@GoogleDeepmind 的 Gemini 4 Carbon 在 Agent Arena(智能体竞技场)中排名第 2,这是基于真实世界任务评估的结果(净提升 +16.2%),并且在成本、时间和每任务输出 token 数方面均处于帕累托前沿!
此次发布相比 Gemini 4 Argon(排名第 7,提升 +11%)高出 5 个排名位次,性能提升幅度达 +5.2 个百分点。
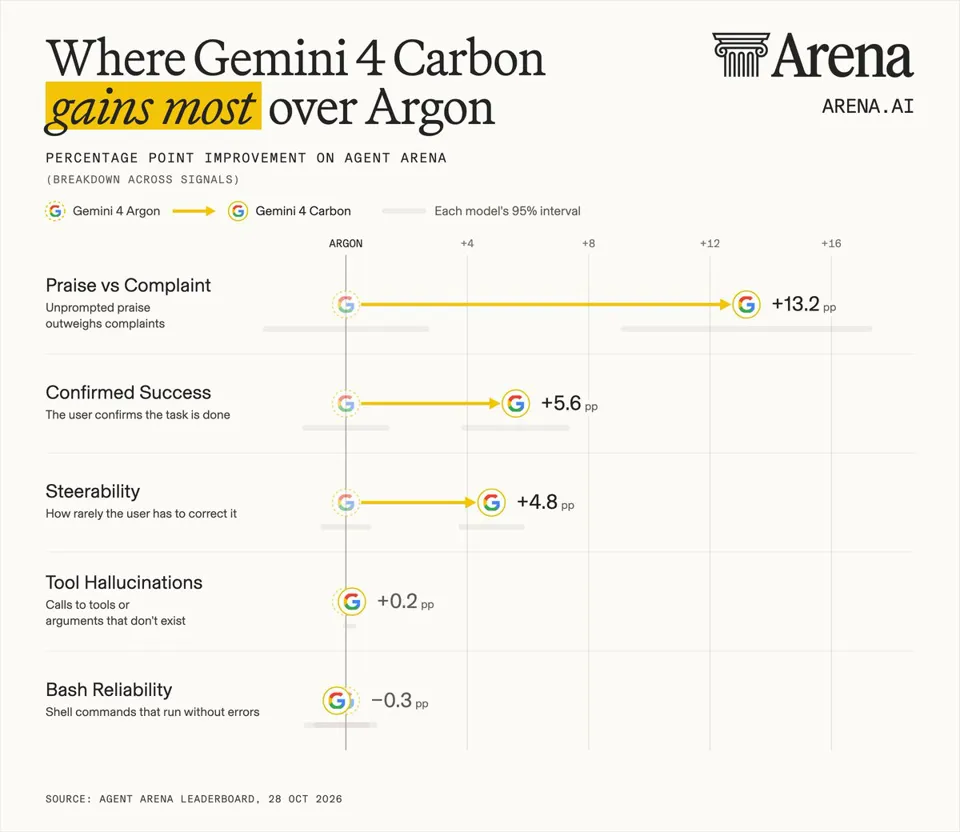
Agent Arena 的信号显示,Carbon 相对于 Argon 的提升主要源于:
-
获得的赞誉明显多于上一版本(赞誉与抱怨之比:+13.2 pp)
-
更频繁地完成任务(确认成功率:+5.6 pp)
-
更好地处理用户反馈(可引导性/Steerability:+4.8 pp)
敬请期待 @googledeepmind 发布的 Carbon 可用性更新,并点击帖子中的链接深入探索 Agent Arena。
↳ 引用 @arena (Arena.ai): 令人振奋的消息:来自 @GoogleDeepMind 的 Gemini 4 Carbon (High) 刚刚在 Arena 上惊艳亮相,位列 Text Arena(文本竞技场)第 1、Agent Arena(智能体竞技场)第 2 以及 Code Arena: WebDev(代码竞技场:网页开发)第 4。Gemini 4 Carbon 重返巅峰,提供前沿智能,并在三大竞技场中重塑了帕累托前沿。
在 Agent Arena 中,Gemini 4 Carbon 以 +16.2% 的净提升排名第 2,这一数据基于我们全球社区提供的超过 2.19 万次真实世界智能体会话,超越了顶级模型 GPT-6 Astra 和 Fable-5.1。其中位任务成本为 1.80 美元,比排名第 1 的 Claude Opus 5.5 (Max) 便宜 72%。
其在关键信号上的突出表现如下:
- 第 1 名 可引导性 (+18.6%):当用户提出反对意见时,模型能否进行路径修正?
- 第 2 名 赞誉与抱怨之比 (+37.9%):用户反应中的隐含情感倾向
- 第 3 名 确认成功率 (+18.7%):用户明确表达“是的,这行得通”
在 Code Arena: WebDev 中,Carbon 得分 1768 分,排名第 4:
- 仅比第 3 名 Claude Sonnet 5.5 (xHigh)(1770 分)低 2 分
- 比第 11 名 Gemini 4 Argon (High)(1679 分)高 89 分
按类别划分,它在游戏与模拟类中排名第 3,在品牌与营销类中排名第 5。
在 Text Arena 中,Gemini 4 Carbon (High) 以 1528 分成为新的第 1 名,目前领先于排名第 2 的 Gemini 4 Argon (High)(1520 分)。
祝贺 @GoogleDeepMind 团队达成这一重大里程碑!