斯坦福等机构发现 27B 开源模型可自主编辑权重自我提升
原标题:New Stanford+other top labs paper finds that a 27B open model can improve itself by editing its own ...
78AI 研判分
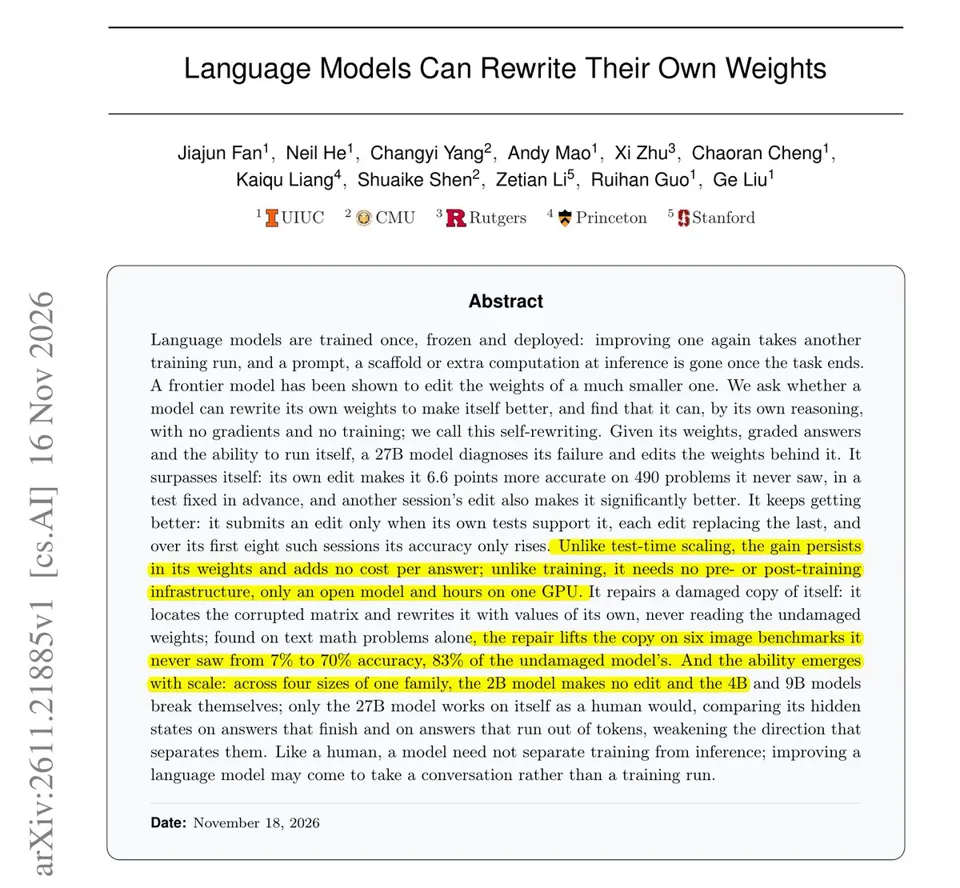
斯坦福等机构的新论文提出一种无需训练与梯度的自我改进方法:让 Qwen3.5-27B 在梯度屏蔽下访问自身权重、带评分的练习答案与 Python 会话,通过推理对比答完与截断两类答案的隐藏状态,削弱区分二者的方向,从而直接编辑权重。在预先固定的 490 道未见题目上,准确率从 57.2% 提升至 63.8%;2B 模型未能产生有效编辑,4B 与 9B 模型则出现自我损伤。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-20 17
斯坦福及其他顶尖实验室的新论文发现,一个 27B 的开源模型可以通过推理编辑自身权重来实现自我提升,无需训练,也无需梯度。
如今要改进一个已部署的模型,意味着要在大型集群上再跑一次训练。提示词和额外的推理算力虽有帮助,但任务一旦结束,这些收益便随之消失。
他们让 Qwen3.5-27B 获得自己的权重、带评分的练习答案以及一个 Python 会话,同时屏蔽梯度。它对比了自己在已完成作答的答案与因 token 耗尽而中断的答案上的隐藏状态,然后削弱了区分二者的方向。
在事先固定的测试中,它自身的编辑将 490 道未见问题上的准确率从 57.2% 提升至 63.8%。2B 模型未能做出编辑,而 4B 和 9B 模型则把自身搞坏了。
如果你运行一个大型开源模型,就让它针对自身的失败提出权重编辑方案,但只保留那些能通过留出测试的编辑。