Artificial Analysis 更新基准:以任务耗时取代流式速度
Artificial Analysis 调整 API 性能基准测试方法,将“任务耗时”(Time per Task)确立为衡量模型表现的核心指标,以替代传统的流式输出速度。该变更旨在反映智能体工作负载下,端到端完成效率比单纯 Token 生成速率更具实际意义,并优化了包含预填充和推理等待在内的全链路延迟测量逻辑。
报道正文
Artificial Analysis (@ArtificialAnlys) · 2026-11-04 17
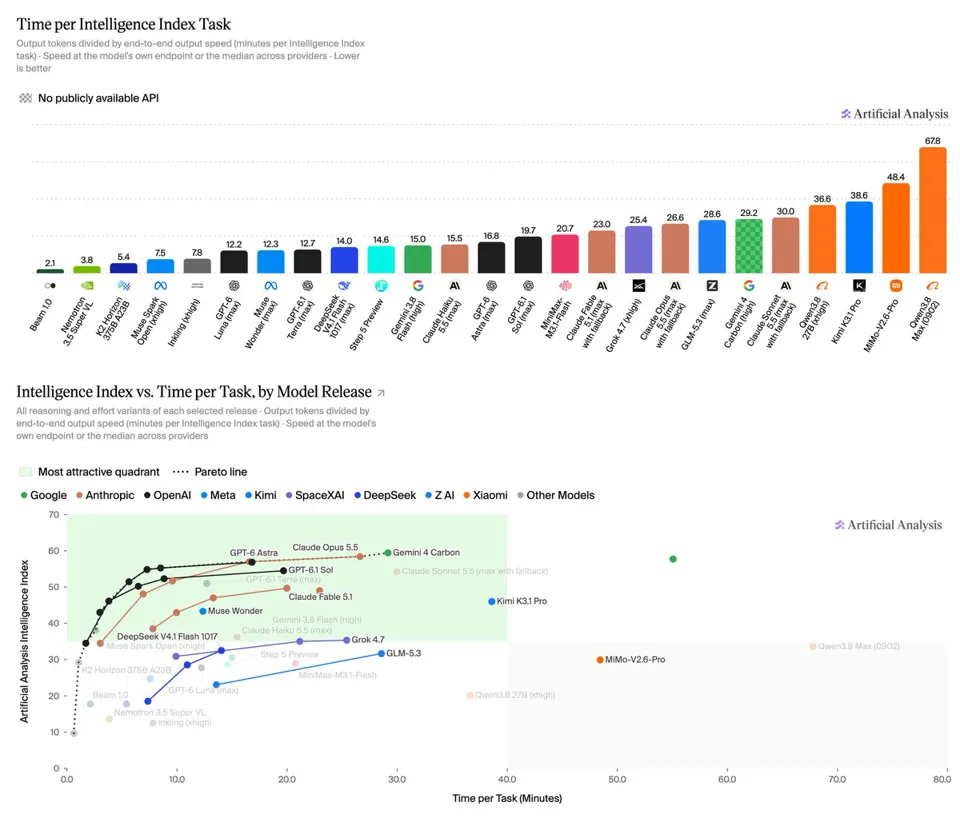
宣布 Artificial Analysis API 性能基准测试的下一个版本:Time per Task(单任务耗时)现已成为我们的核心性能指标,用于衡量模型完成任务所需的时间,而非其流式输出的速度。
此次更新适用于我们每天多次进行速度、延迟和缓存基准测试的约 1,000 个无服务器端点。
主要变化: ➤ Time per Task 现作为对比模型的核心指标:随着工作负载变得更加具备代理性(agentic),完成一项任务所花费的时间比单个 token 的速度更为重要。一个单 token 速度快但输出冗长的模型,可能比一个速度较慢但使用更少 token 的模型耗时更长。Time per Task 的计算方式为:将模型在 Intelligence Index 任务中的输出 token 数除以其端到端输出速度(End-to-End Output Speed)。
➤ 端到端输出速度涵盖完整请求流程:现在的速度测量范围从发送请求开始,直到接收最后一个 token 结束。这包括第一个 token 之前的等待时间(预填充 prefill,以及隐藏推理过程的模型的推理时间)以及生成阶段。输出 token 数量现在取自各提供商 API 报告的计数,而非 o200k_base 分词器,同时我们会监控报告计数中的差异。
➤ 代理型工作负载现已纳入所有测量环节:我们对短文本、文档长度及长上下文提示词进行基准测试,并涵盖编码和知识工作中的多轮会话。核心数据为过去 5 天内这些工作负载的平均值。
➤ API 默认努力程度(effort)现与最高努力程度一同追踪:大多数开发者会在各实验室设定的 API 默认努力程度级别下运行模型,因此我们现在也在该设置以及最高努力程度下对关键模型进行基准测试。由于不同实验室之间的“努力程度”名称不可直接比较,我们采用各实验室自身的默认设置,而非统一的标准。
关键结论: ➤ 尽管输出速度较慢,OpenAI 模型仍占据了 Intelligence vs. Time per Task 帕累托前沿的大部分区域:在不同努力程度下,GPT-6 Astra 和 GPT-6.1 Sol 在 Intelligence Index 约 45 到 55 的区间内保持领先。在最大努力程度下,GPT-6 Astra 的运行速度为 51 tokens/s,但完成一项任务需约 17 分钟;相比之下,Claude Opus 5.5(最大努力程度,111 tokens/s)需约 26 分钟,Gemini 4 Carbon(高努力程度,71 tokens/s)需约 29 分钟。这是因为 GPT-6 Astra 每项任务仅使用约 50k 输出 token,而其他模型则使用约 120k 至 170k token。
➤ API 默认 effort 设置使 GPT-6 Astra、GPT-6.1 Sol 和 Claude Opus 5.5 的单任务耗时(Time per Task)降低约 3 至 5 倍,单任务成本(Cost per Task)降低约 2 至 4 倍:这三款模型均默认采用 medium effort,作为交换,其在智能指数(Intelligence Index)上的得分下降约 5 至 11 分。以 Claude Opus 5.5 为例,从 max effort 降至 medium effort 时,单任务耗时从约 26 分钟降至约 6.8 分钟,成本从 10.04 美元降至 2.45 美元。
➤ 仅针对解码速度(decode speed)进行优化的端点,其端到端输出速度(End-to-End Output Speed)降幅最大:高解码速度往往以牺牲延迟为代价,例如通过排队请求以降低批处理大小(batch size)运行,或暂存输出并一次性突发发送。这两种方式都会延长首 token 等待时间,而端到端输出速度指标现已将此纳入考量。