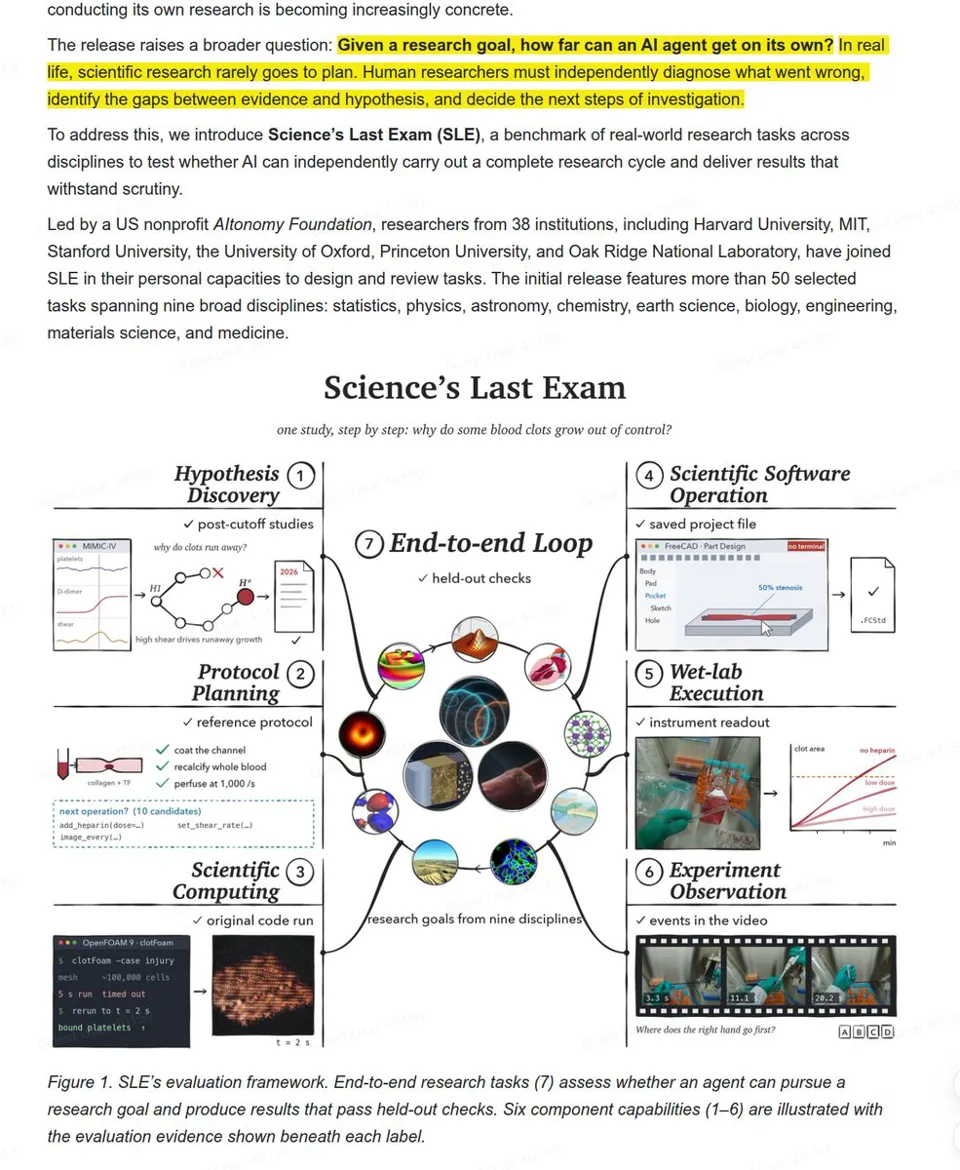
Science's Last Exam 基准发布 用隐藏专家检查评测 AI 科研能力
美国非营利机构 AItonomy Foundation 发布 Science's Last Exam(SLE)基准,覆盖 9 个学科共 113 项任务,向智能体提供真实研究目标、数据与实验室软件,再用智能体不可见的专家校验评分,并以模型训练截止之后发表的论文作为对照,避免记忆作弊。DeepSeek V4.1 Flash 以 21.28% 的假设命中后续研究领先,但端到端真实科研任务上所有模型均得 0 分。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-05 19
Lean 为 AI 数学提供了一个无人能质疑的评分器,而实证科学如今也正在获得这一理念的对应版本。
Science's Last Exam(SLE)是一个基准测试,它依据可打开、可重新运行的产物来给研究智能体评分,而检查项由领域专家在构建每项任务时封存。
该基准由美国非营利组织 AItonomy Foundation 牵头,涵盖 9 个学科中的 113 项任务,并用对智能体隐藏的检查项来给提交结果评分。
大多数 AI 科学测试都是用已知答案来提问;SLE 则给 AI 智能体一个研究目标、数据和实验室软件,然后用智能体从未见过的测试来检查其完成的工作。
它依据模型训练截止日期之后发表的研究来给 AI 假设打分,因此记忆帮不上忙。DeepSeek V4.1 Flash 领先,其 21.28% 的假设预见了后续研究。
↳ 引用 @aitonomyfound (AItonomy Foundation): 我非常自豪地分享我们在 AItonomy Foundation 一直在构建的东西:Science's Last Exam(SLE)。🧪✨
AI 能做科学吗?我们不采用问答形式,而是给智能体真实的研究目标和现实世界的工具(实验室数据、软件),然后用隐藏的专家检查项给它们评分。
深深感谢来自 34 家机构(哈佛、MIT、斯坦福等)的杰出人才,他们帮助打造了横跨 9 个学科的 113 项任务。❤️
结果如何?科学很难。在 8 个前沿模型中,最好的得分是 37.5/100。在真正的端到端研究上?全部得 0 分。我们前方还有一段激动人心的旅程!🚀 (Claude Opus 5.5 和 GPT-6 Astra 即将推出——只是在清理生物安全防护措施。)
一切将于 11 月 6 日开放。🗓️ 🌐