百度开源文心 5.5 Flash Base 2800 亿参数 MoE 刷新同尺寸 SOTA
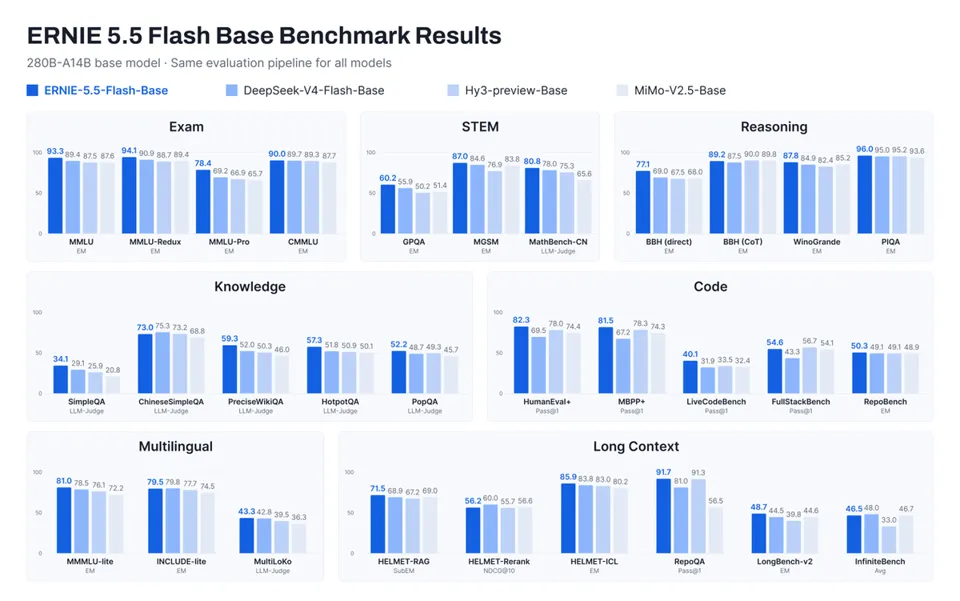
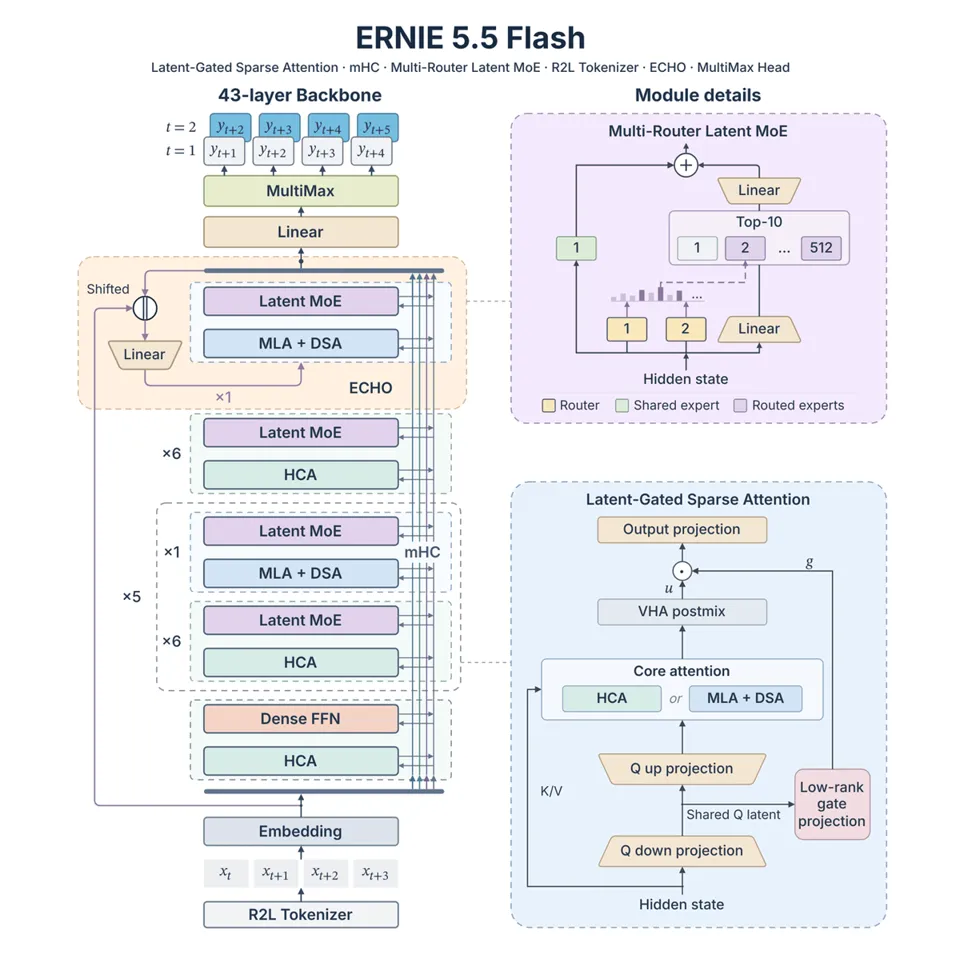
百度正式开源基座模型文心 5.5 Flash Base,采用 2800 亿总参数、每 Token 激活 140 亿的 MoE 架构,预训练使用 33.5 万亿 Token,微调与推理支持最长 100 万 Token 上下文。模型在知识、推理、数学、代码、多语言与长上下文等基准上取得同尺寸 SOTA,超过 DeepSeek-V4-Flash-Base 等同类模型。其核心创新围绕效率展开,包括 Latent-Gated Sparse Attention、Multi-Router Latent MoE 与复用主干末层的 ECHO 训练目标。
报道正文
11月5日,百度正式开源最新基座模型文心5.5 Flash Base
11月5日,百度正式开源最新基座模型文心5.5 Flash Base(ERNIE 5.5 Flash Base)。模型采用MoE架构,总参数量2800亿,每个 Token 激活140亿参数,使用33.5万亿个 Token 完成预训练,预训练上下文长度最高达128K,微调与推理阶段支持最长100万 Token上下文。在知识、推理、数学、代码、多语言和长上下文等多个基准测试中取得同尺寸模型 SOTA 表现,超过 DeepSeek-V4-Flash-Base、Hy3-preview-Base、MiMo-V2.5-Base 等模型。
开源地址:https://huggingface.co/baidu/ERNIE-5.5-Flash-Base
随着大模型应用从文本问答向长文档分析、多轮交互和智能体任务延伸,模型需要处理的信息量持续增加,计算和显存开销也随之上升。在保证模型能力的同时提高资源利用效率,已成为大模型研发的重要课题。
文心 5.5 Flash Base围绕“效率”这一设计主线,在注意力机制、专家路由及训练机制等关键环节进行系统性优化,并实现了多项算法创新。
在注意力机制上,文心提出 Latent-Gated Sparse Attention,将混合稀疏注意力、低秩门控注意力与虚拟头注意力结合起来。其中,模型通过组合HCA与MLA,让不同注意力层分别承担压缩历史信息和细粒度访问历史位置的任务;低秩门控注意力(Low-Rank Gated Attention)则利用已有的低维表示计算信息门控,使门控投影权重参数减少75%;此外,虚拟头注意力(Virtual Head Attention,VHA)可提升模型表达力与训练质量,推理时融合进注意力算子,开销极小。这些设计降低了长上下文处理的资源开销,同时保留模型对关键信息的处理能力。
在专家路由上,模型采用 Multi-Router Latent MoE,由多个独立路由器共同参与专家选择,改善路由评分与专家实际效用之间的相关性。相比依赖单一路由器的传统方案,该设计旨在降低单一评分偏差对专家选择的影响,同时保持激活专家数量、专家计算量和通信量不变。在训练目标上,模型引入 ECHO,无需额外增加 MTP 模块(Multi-Token Prediction),而是复用主干最后一层,让主干自身学习预测后续 token,从而提前规划序列走向,有效提升推理与代码能力。文心5.5 Flash 仅采用单步 ECHO 预训练,复用的最后一层还可作为投机解码的草稿模型,展现出多步外推能力:同样只训练一步,多步起草质量大幅优于辅助 MTP 模块。
除模型架构外,大模型基建创新也十分重要。文心对分布式Muon优化器进行了优化,并推出面向大 head dim 的注意力算子 FlashMask-4,改善大规模训练中的通信、显存利用与计算效率。模型能力的提升不仅依赖算法本身,也与训练系统能否高效支撑这些设计密切相关。
基座模型不仅承载着预训练阶段形成的通用能力,也是下游模型开发与应用创新的重要基础。与面向终端用户的应用模型不同,Base 模型为开发者和企业提供了进一步微调与定制的空间,可基于自身业务需求构建适应不同场景的专业模型与应用。开放基座模型能够为开发者提供更多技术选择,降低专业模型开发的训练成本与技术门槛。
当前,大模型的竞争逐渐迈向模型能力、训练效率与场景创新协同发展的新阶段。随着推理、Agent等技术与应用加速演进,行业对基座模型的需求也从单一的能力提升,转向更高效的训练范式、更灵活的能力拓展,以及更广泛的场景适配需求。文心5.5 Flash Base在提升模型基础能力与训练推理效率的同时,为开发者和社区提供了更具拓展性的技术基础,推动模型技术走向多样化的能力探索与应用创新。
本文由百度提供,量子位获授权转载,观点归原作者所有。