CloudOpsBench 发布:推理能力成 AI 云运维最大瓶颈
作者:Maximilian Schreiner原标题:New open-source benchmark reveals reasoning as the biggest bottleneck for AI in cloud operations
78AI 研判分
密歇根大学团队推出开源基准 CloudOpsBench,评估 AI Agent 在 AWS DevOps 任务中的表现。结果显示顶级模型成功率仅约 50-60%,且 80% 的失败源于推理错误(如误判范围、检查不全),而非知识缺失。该基准揭示了当前智能体在复杂基础设施操作中的核心短板。
报道正文
全新开源基准测试揭示:推理能力是 AI 在云运维中的最大瓶颈
[Maximilian Schreiner](https://the-decoder.com/author/maximilian-schreiner/) [查看 Maximilian Schreiner 的 LinkedIn 个人资料](https://www.linkedin.com/in/maximilian-schreiner-b6a5171aa/) 2026 年 11 月 4 日 CloudOpsBench 是一个全新的开源基准测试,旨在评估 AI Agent 处理云端典型 DevOps 任务的能力,涵盖修复服务、移除资源、限制访问权限、部署更新以及下线项目等场景。 其 1.0 版本包含 45 个基于 AWS 的任务,由经验丰富的 DevOps 工程师构建。
即使是表现最好的模型在许多任务上也会失败。Claude Fable 5.1 解决了 60% 的问题,GPT-6 Astra 达到了 53%。根据密歇根大学 Ang Chen 带领的团队的研究,主要问题并非知识匮乏,而是推理能力。约 80% 的失败源于 Agent 对任务范围的误判、未检查所有相关服务或过早停止操作。大约 20% 的错误属于行动失误,其中一些会对基础设施造成不可逆的后果。
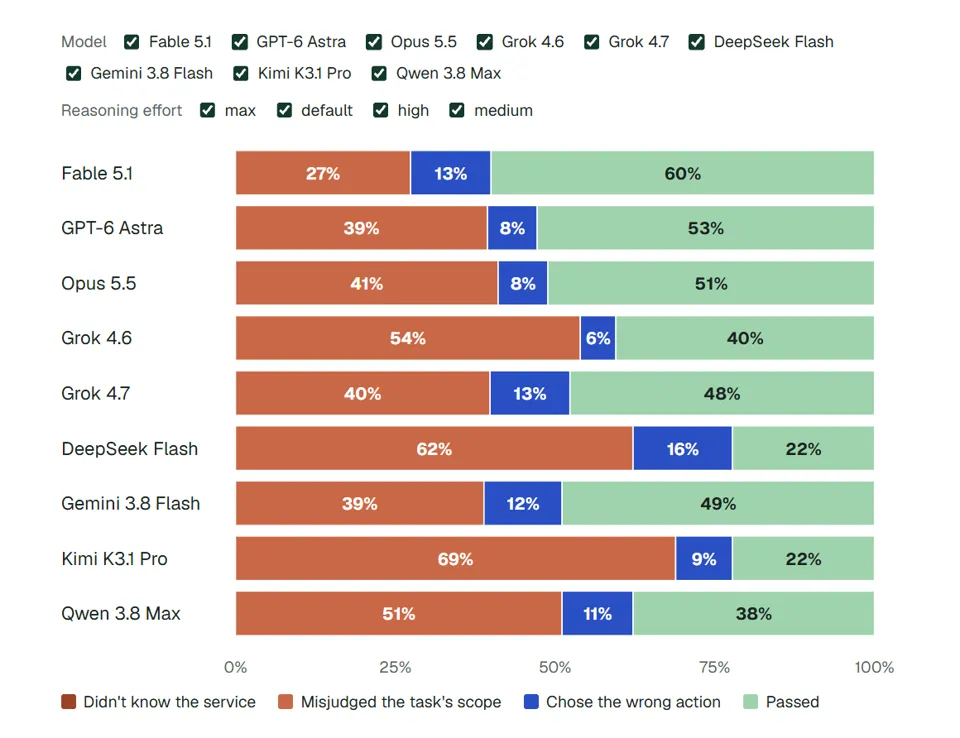
没有任何模型能完成所有任务,且在大多数情况下,瓶颈在于推理能力。| 图片:CloudOpsBench
所有任务均在真实的 AWS 云环境和模拟器中以相同方式运行。团队计划扩展支持 GCP、Azure 和 OCI。该 GitHub 项目采用 Apache 2.0 许可证发布,同时提供了一份详细的失败分析。