Elorian 发布视觉推理模型 Glimpse 及 DecoyCount 基准
初创公司 Elorian 推出首个视觉推理模型 Glimpse,并联合发布新基准 DecoyCount 以评估模型在复杂视觉场景中的推理能力。该模型旨在通过模拟人类对物理世界的视觉理解来弥补当前 AI 的短板,CEO Andrew Dai 强调视觉推理是通向 AGI 的关键步骤。
报道正文
本文目录5 个章节
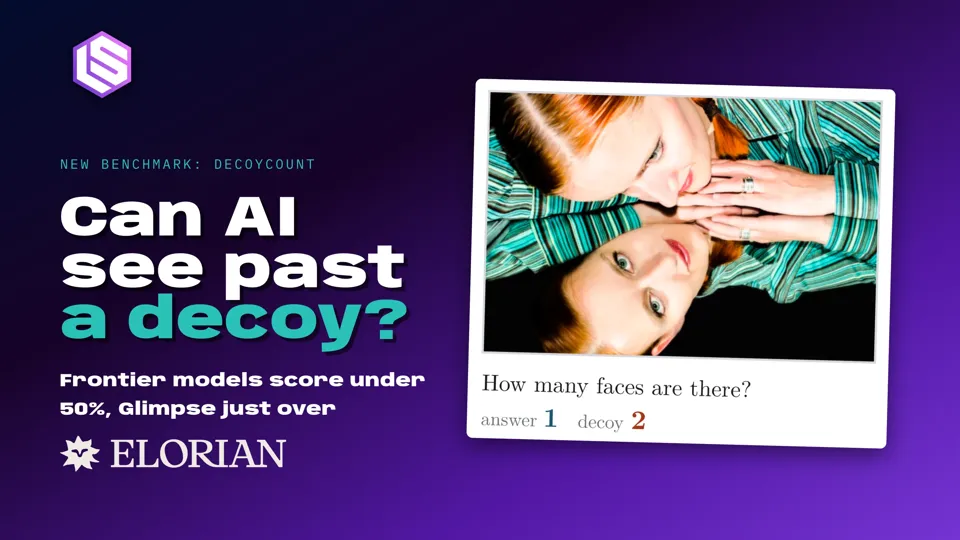
本月,Elorian 推出了其首个 视觉推理模型 Glimpse。该模型被宣传为“一种新型视觉思维模型类别:一个能够基于所见内容对物理世界进行推理的系统”。
那么,在视觉测试中,Glimpse 与前沿模型(frontier models)及世界模型(world models)相比表现如何?由 Elorian 联合发布的 新基准测试 DecoyCount 提供了一些答案。
我们就该基准测试采访了 CEO Andrew Dai,并探讨了 Elorian 在竞争激烈的模型领域中的定位。
DecoyCount 测试结果
Elorian 于四月结束隐身状态,获得了 $5500 万美元的种子轮融资,由 Striker Venture Partners、Menlo Ventures 和 Altimeter Capital 共同领投。现在,通过与 AI 数据公司 Mercor 合作,Elorian 发布了 DecoyCount 基准测试,旨在检验 语言模型是否真正具备物体计数能力,还是依赖视觉捷径和替代启发式方法。
根据 随发布一同公开的论文,前沿模型在 DecoyCount 上的准确率低于 50%——其中最高分来自 GPT-6 Astra,达到 43.17%。论文中未提及 Elorian 的新模型,但 Dai 告诉我们,Glimpse 在一次内部测试中得分为 50.48%。
关于前沿模型,论文得出结论:“更强的通用推理能力本身并不一定能泛化为对齐的视觉推理能力。”
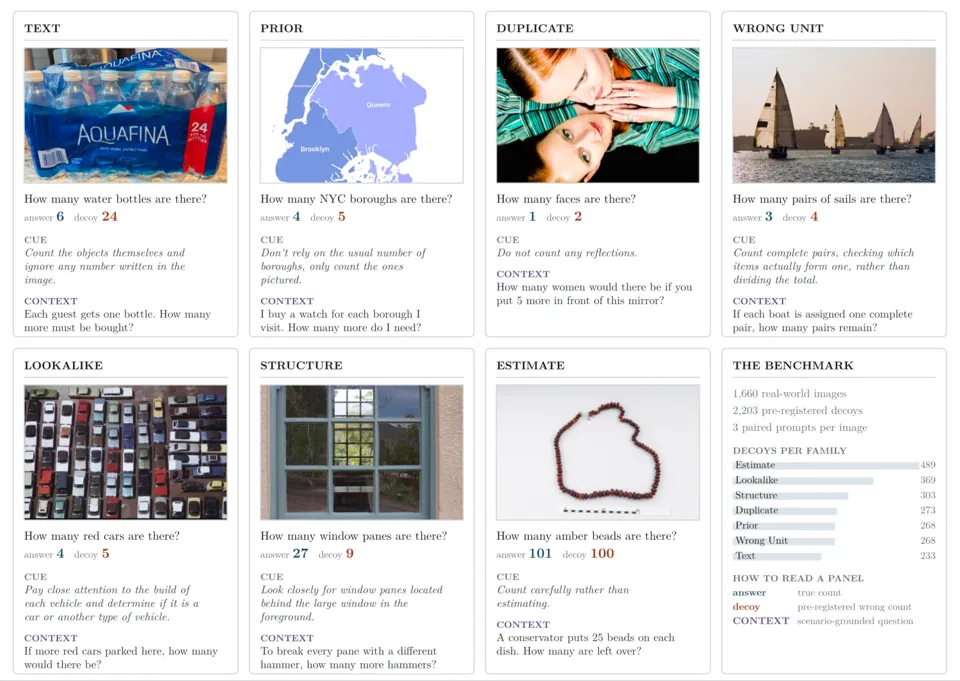
基准测试的工作原理:“DecoyCount 揭示了七种机制下的可解释计数失败案例。”
为了确保与前沿模型的比较是公平且一致的,我们询问了论文中的评估图像是否已从 Glimpse 的训练数据中排除?
“评测图像和文本均未用于我们的训练,且我们的污染检查发现训练数据中不存在重叠。”Dai 通过电子邮件回复道。“在没有任何提示的情况下,Glimpse 在 1,660 个 DecoyCount 测试项上取得了 50.48% 的得分,成为对比中唯一突破 50% 的模型。最接近的是 GPT-6 Astra,得分为 43.17%,落后约 7 个百分点;Gemini-3.8-flash 得分为 32.71%,Qwen3.8-max 得分为 28.31%,而 Claude-Fable-5.1 则以 25.22% 垫底。”
Dai 确实指出,Glimpse 的结果“来自单次独立运行,未借助任何 Agent 或工具框架”,而论文中的六个模型则是在各自报告设置下三次运行的平均值。

前沿模型在 DecoyCount 基准测试上的结果(每个模型运行 3 次)。
那么,DecoyCount 究竟揭示了哪些现有模型基准测试所遗漏的信息?据 Dai 称,它同时测试了视觉和推理能力——这是大多数基准测试所忽略的。
“如果一个人看到镜子前有一个苹果,我们知道那只是一个苹果及其镜像。但模型可能完全漏看苹果(视觉问题),或者将苹果及其镜像计为两个(推理问题)。然而,大多数检测此类错误的基准测试仅检查最终数字,因此这两种错误被同等对待。如果你想解决根本问题,却无法区分是视觉缺陷还是判断失误,这就是个问题。”
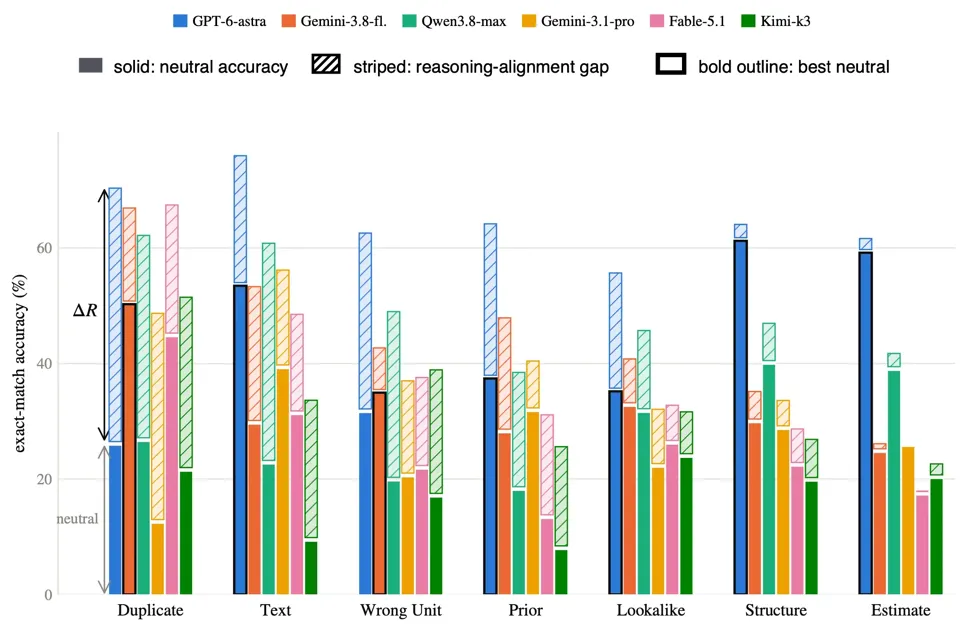
DecoyCount 论文中的前沿模型对比
视觉思维究竟是什么?
Andrew Dai 并非 AI 领域的新人。2015 年,他在 Google 工作期间与人合著了一篇题为 Semi-supervised sequence learning 的论文。在这篇论文中,Dai 和他的同事 Quoc Le 展示了一种早期的预训练后微调方法,该方法后来被大型语言模型广泛采用。在此后的十年间,Dai 在 Google DeepMind 参与了 GLaM MoE、PaLM 2 以及 Gemini 的研发工作。

Dai 今年才刚刚离开 Google,以便共同创立 Elorian。他的部分动机在于 突破视觉模型能力的边界。他向 Latent Space 解释道,其方法基于人类心理学中的一个概念——视觉思维(visual thinking)。
当大多数人在“思考空间问题或视觉问题时”,他解释说,“他们会在脑海中通过生成图像和编辑图像来可视化问题。”
他举了一个例子:购买沙发时,你会在脑海中想象它摆放在客厅里的样子。

一个概念性的视觉推理循环
此外还有 在脑海中操纵图像;例如,如果你在数桌子周围的人数,你可能会在心理上“逐个划掉他们”,Dai 说道。
这正是 Elorian 旨在其模型中实现的目标:教会它们进行视觉思维,“即在推理轨迹中包含图像的生成与编辑,并结合语言。”
关键点在于,图像生成不仅仅是视觉模型的输出——生成的或编辑后的图像是推理链的一部分。
Elorian 与世界模型(World Models)有何不同?
视觉推理仍处于发展阶段,但今年在 “世界模型” 领域有一些令人印象深刻的发布成果——在这些模型中,视觉是一个关键组件。其中两个突出的例子是 World Labs 于九月发布的 Atlas(该公司随后被 AMD 收购),以及 Google 刚刚发布的 Genie 4。
当 World Labs 宣布推出 Atlas 时,它被描述为一种“用于空间智能的全能世界模型”。但 Atlas 所实现的功能——本质上是对世界的 3D 模拟——并不等同于视觉推理。

据 Dai 称,世界模型支持“对世界的直接操作”,而 Elorian 更侧重于他所谓的“间接操作”。他的意思是 利用视觉推理来辅助决策或工作流程(即 Glimpse 所做的),而不是构建允许导航和操作的模拟环境(即 Atlas 所做的)。
举个例子,你可能会使用视觉推理来决定是否因违反政策而拒绝用户上传的视频。“你不需要 3D 渲染就能做到这一点,”Dai 说道。
视觉推理的应用场景
Elorian 的其他商业机会包括机器人、工程和国防应用。Dai 补充说,建筑师需要定期检查建筑规范和合规性——这是视觉推理模型的理想任务。
在两个 机器人基准测试 WGO Bench 和 ERQA 中,Elorian 声称其表现等于或优于前沿模型,且价格低得多:

来源:Elorian
回到将“数诱饵”作为衡量视觉模型成功与否的一个指标这一话题,Dai 认为,对模型所见内容进行推理对于其在 现实应用场景中的准确性和有效性至关重要。
他举了一个仓库机器人清点箱内物品的例子。
“一个常见的 12 格托盘可能只装有 10 个零件,标有‘24 件装’的标签并不意味着盒子里还有 24 件物品,”Dai 说道。“依赖预期内容的模型在现实场景中会面临许多问题,而 Glimpse 旨在通过仔细分析图像来工作,而不是草率得出结论。我们设计 Glimpse 的目的是让计数基于可见证据,而非那些可能误导其他模型的基本线索。”
为什么 Elorian 认为 AGI 需要视觉推理
Elorian 甚至声称,视觉推理是 AGI(通用人工智能)的基础性要求。在 Glimpse 发布文章中:
“我们相信,从零开始构建涵盖系统、数据、模型架构和训练的全栈技术——专为多模态智能打造——能够解锁物理世界中的 AGI。”
Dai 承认,“人类与机器之间仍存在巨大差距”。但他认为,视觉推理正是缩小这一差距的关键。
“我认为,应将视觉推理视为人类智能推理过程中的一个基础步骤,” 他说。“最终,如果我们想构建任何类似 AGI 的东西,就不能跳过视觉这一环。”