LangChain Blog · 2026/10/24 01:45:02
Deep Agents 提出检索优先上下文工程范式
LangChain 团队发布 Deep Agents 框架,针对智能体上下文窗口限制提出“检索优先”的工程范式。该方案通过内置文件系统工具实现先搜后读,并利用“检索、卸载、委托”机制将大结果存盘仅返回路径,有效解决搜索低效与上下文过载问题。
报道全文原始报道全文
本文目录18 个章节
核心要点
- Agent 在有限的上下文窗口中工作,信息检索通常会在三个方面出现问题:搜索效率低下、一次性加载过多上下文、以及包含无关或过时的上下文。
- Deep Agents 框架开箱即用地保持搜索范围精简。内置的文件系统工具遵循“先搜后读”原则:
glob匹配文件名,grep查找匹配行,read_file每次只读取一页。过大的工具输出会被卸载(offload):完整结果保存到文件中,但 Agent 仅获取文件路径和预览内容。 - 对于自定义搜索工具(如 RAG),应采用“检索、卸载、委托”策略:将结果保存到文件,返回路径,并让子 Agent 去读取这些文件。主 Agent 只需关注相关内容。
想象一下你正在参加一场开卷考试:虽然理论上所有答案都在手边,但这反而让你更难找到正确的那个答案。
- 你该从哪里开始搜索?
- 你如何判断资料来源是否准确?
- 你如何优化时间分配,以免把精力浪费在重复无效的搜索上?
高效地找到正确信息并非易事。
交给 Agent 一个问题,它也面临类似的困境:由于上下文窗口有限,它必须像人类一样检索信息来完成特定任务(而不是依靠记忆存储所有内容)。在搜索过程中,Agent 常遇到以下挑战:
- 搜索效率低下: 每次搜索都会消耗 Token 和时间。如果 Agent 搜索方式笨拙(例如打开每个文件只为查看内容,或不断改写同一个查询语句),它在找到有用信息之前就可能用搜索结果填满上下文窗口。
- 一次性加载过多上下文: 一次搜索若直接导出完整数据或加载十几份文档,会瞬间占满上下文窗口,导致没有空间留给实际的任务处理。
- 无关或过时的上下文: 过时或偏离主题的信息对模型来说可能与正确答案一样具有迷惑性。一旦进入上下文窗口,Agent 可能会基于这些错误信息进行推理(且这一错误会延续到后续每一步)。
幸运的是,Agent 拥有多种技术来确保检索到正确的信息。Agent 框架(agent harness)的职责就是策略性地应用这些技术,以便为当前任务提供恰到好处的上下文。
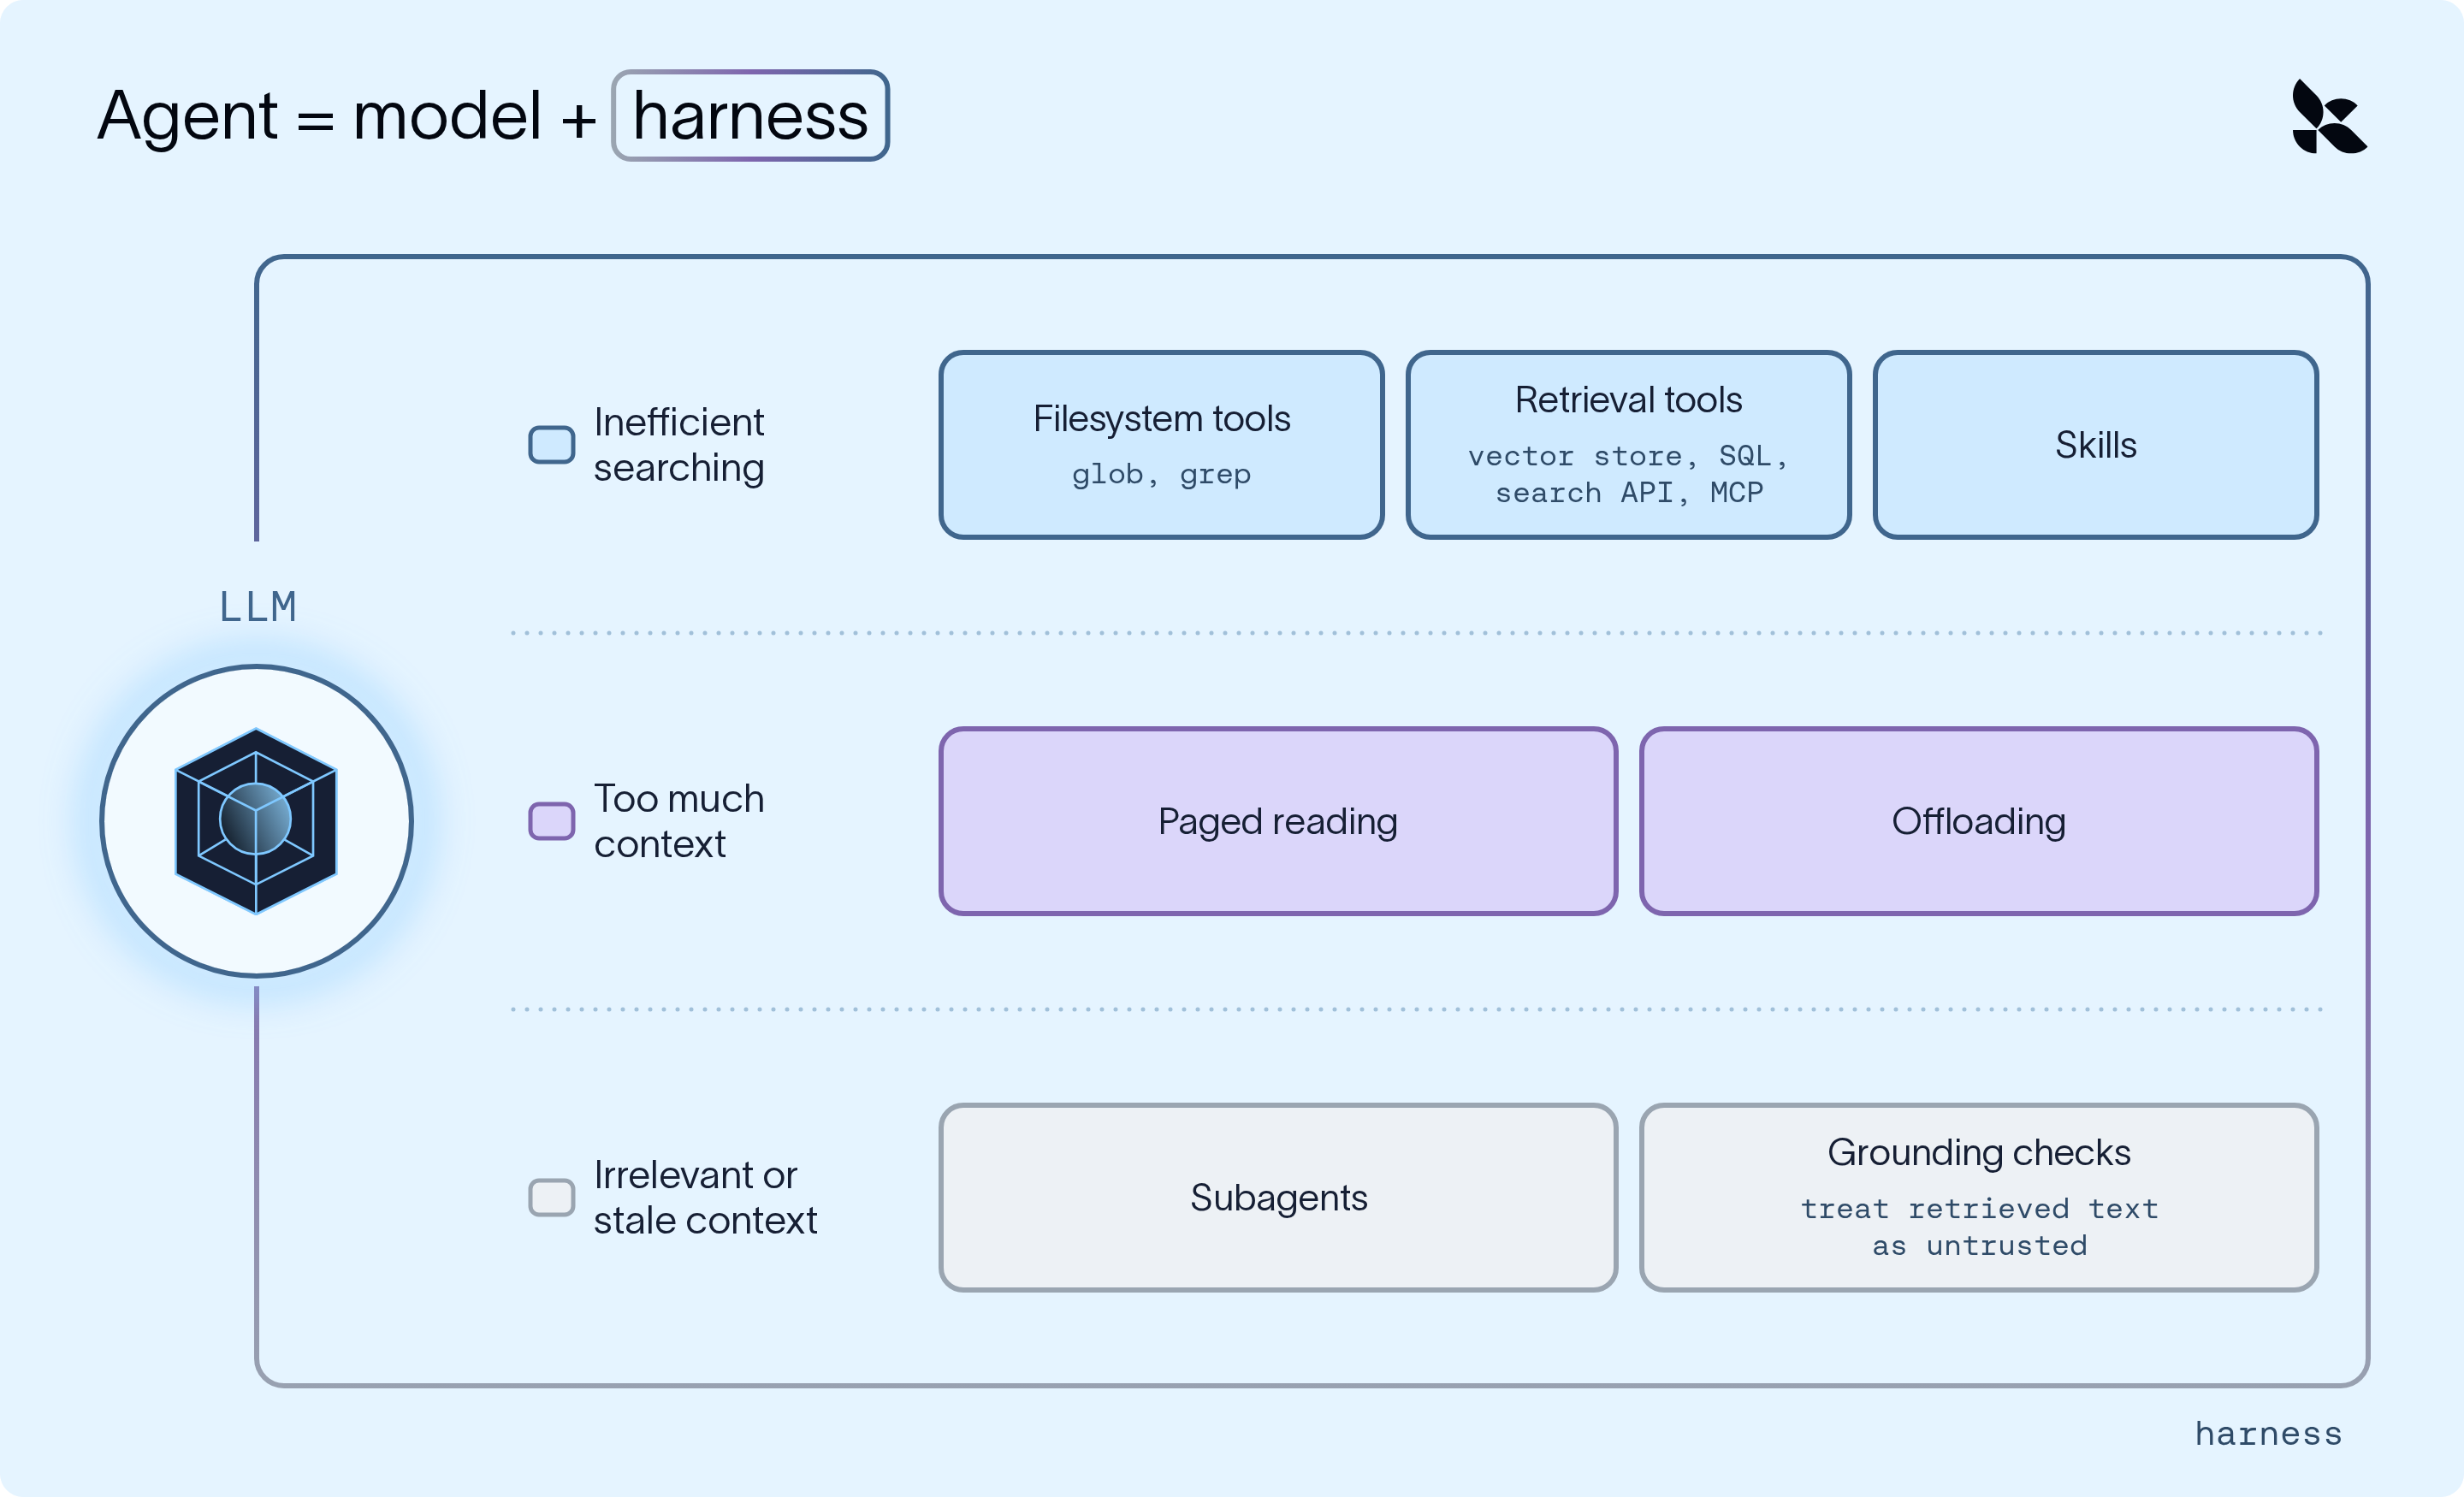
本文探讨了智能体检索(即查找并仅获取当前任务所需信息)面临的挑战、我们可用的应对技术,以及在设计智能体框架(以 LangChain 的 Deep Agents 框架为例)时如何将这些因素纳入考量。
如需了解更多关于如何在上下文窗口中管理已加载内容的信息,请查阅这篇关于上下文工程的博客。
我们的示例:竞品分析智能体
让我们看看这在真实用例中如何应用:一个竞品分析智能体。每周一,该智能体会调研数百个竞争对手,并按照团队模板撰写报告。它需要执行以下操作:
- 查找上周关于公司 A 的笔记
- 在庞大的市场数据导出文件中查找特定的营收数字
- 在新闻档案中搜索任何新动态
每一项都属于不同类型的检索,因此面临不同的问题。我们使用 Deep Agents 框架构建了该智能体,因此有一些开箱即用的技术可以最小化这些问题。
1. 低效搜索
我们的智能体必须为每个竞争对手找到三项内容。如果每项都需要尝试十几次(例如打开文件只是为了查看其内容,或者因为源文档使用了不同的词汇而重新措辞搜索),那么在撰写报告的任何文字之前,其上下文窗口就会被失败的搜索填满。
因此,最好的搜索是智能体无需重复进行的搜索,这意味着要为每项任务使用合适的工具。
从内置的文件系统工具开始
智能体搜索信息最常见的方式之一是通过文件系统。然而,如果我们的智能体为了查看内容而打开每一个文件,那么它的搜索效率极低:它读取的每个文件都会进入其上下文窗口,因此仅仅通过“查看”就可能使窗口填满。
更好的方法是首先检查名称和关键词(就像你在开卷考试中扫描书籍索引而不是阅读每一页一样)。两种常见的文件系统工具正是这样做的:
glob通过文件名模式查找文件。例如,**/company-a*.md可以查找上周关于 Company A 的笔记。grep在文件内部进行搜索,而无需将文件加载到上下文窗口中。它匹配字面文本,并可以返回匹配的文件、匹配的行或计数。
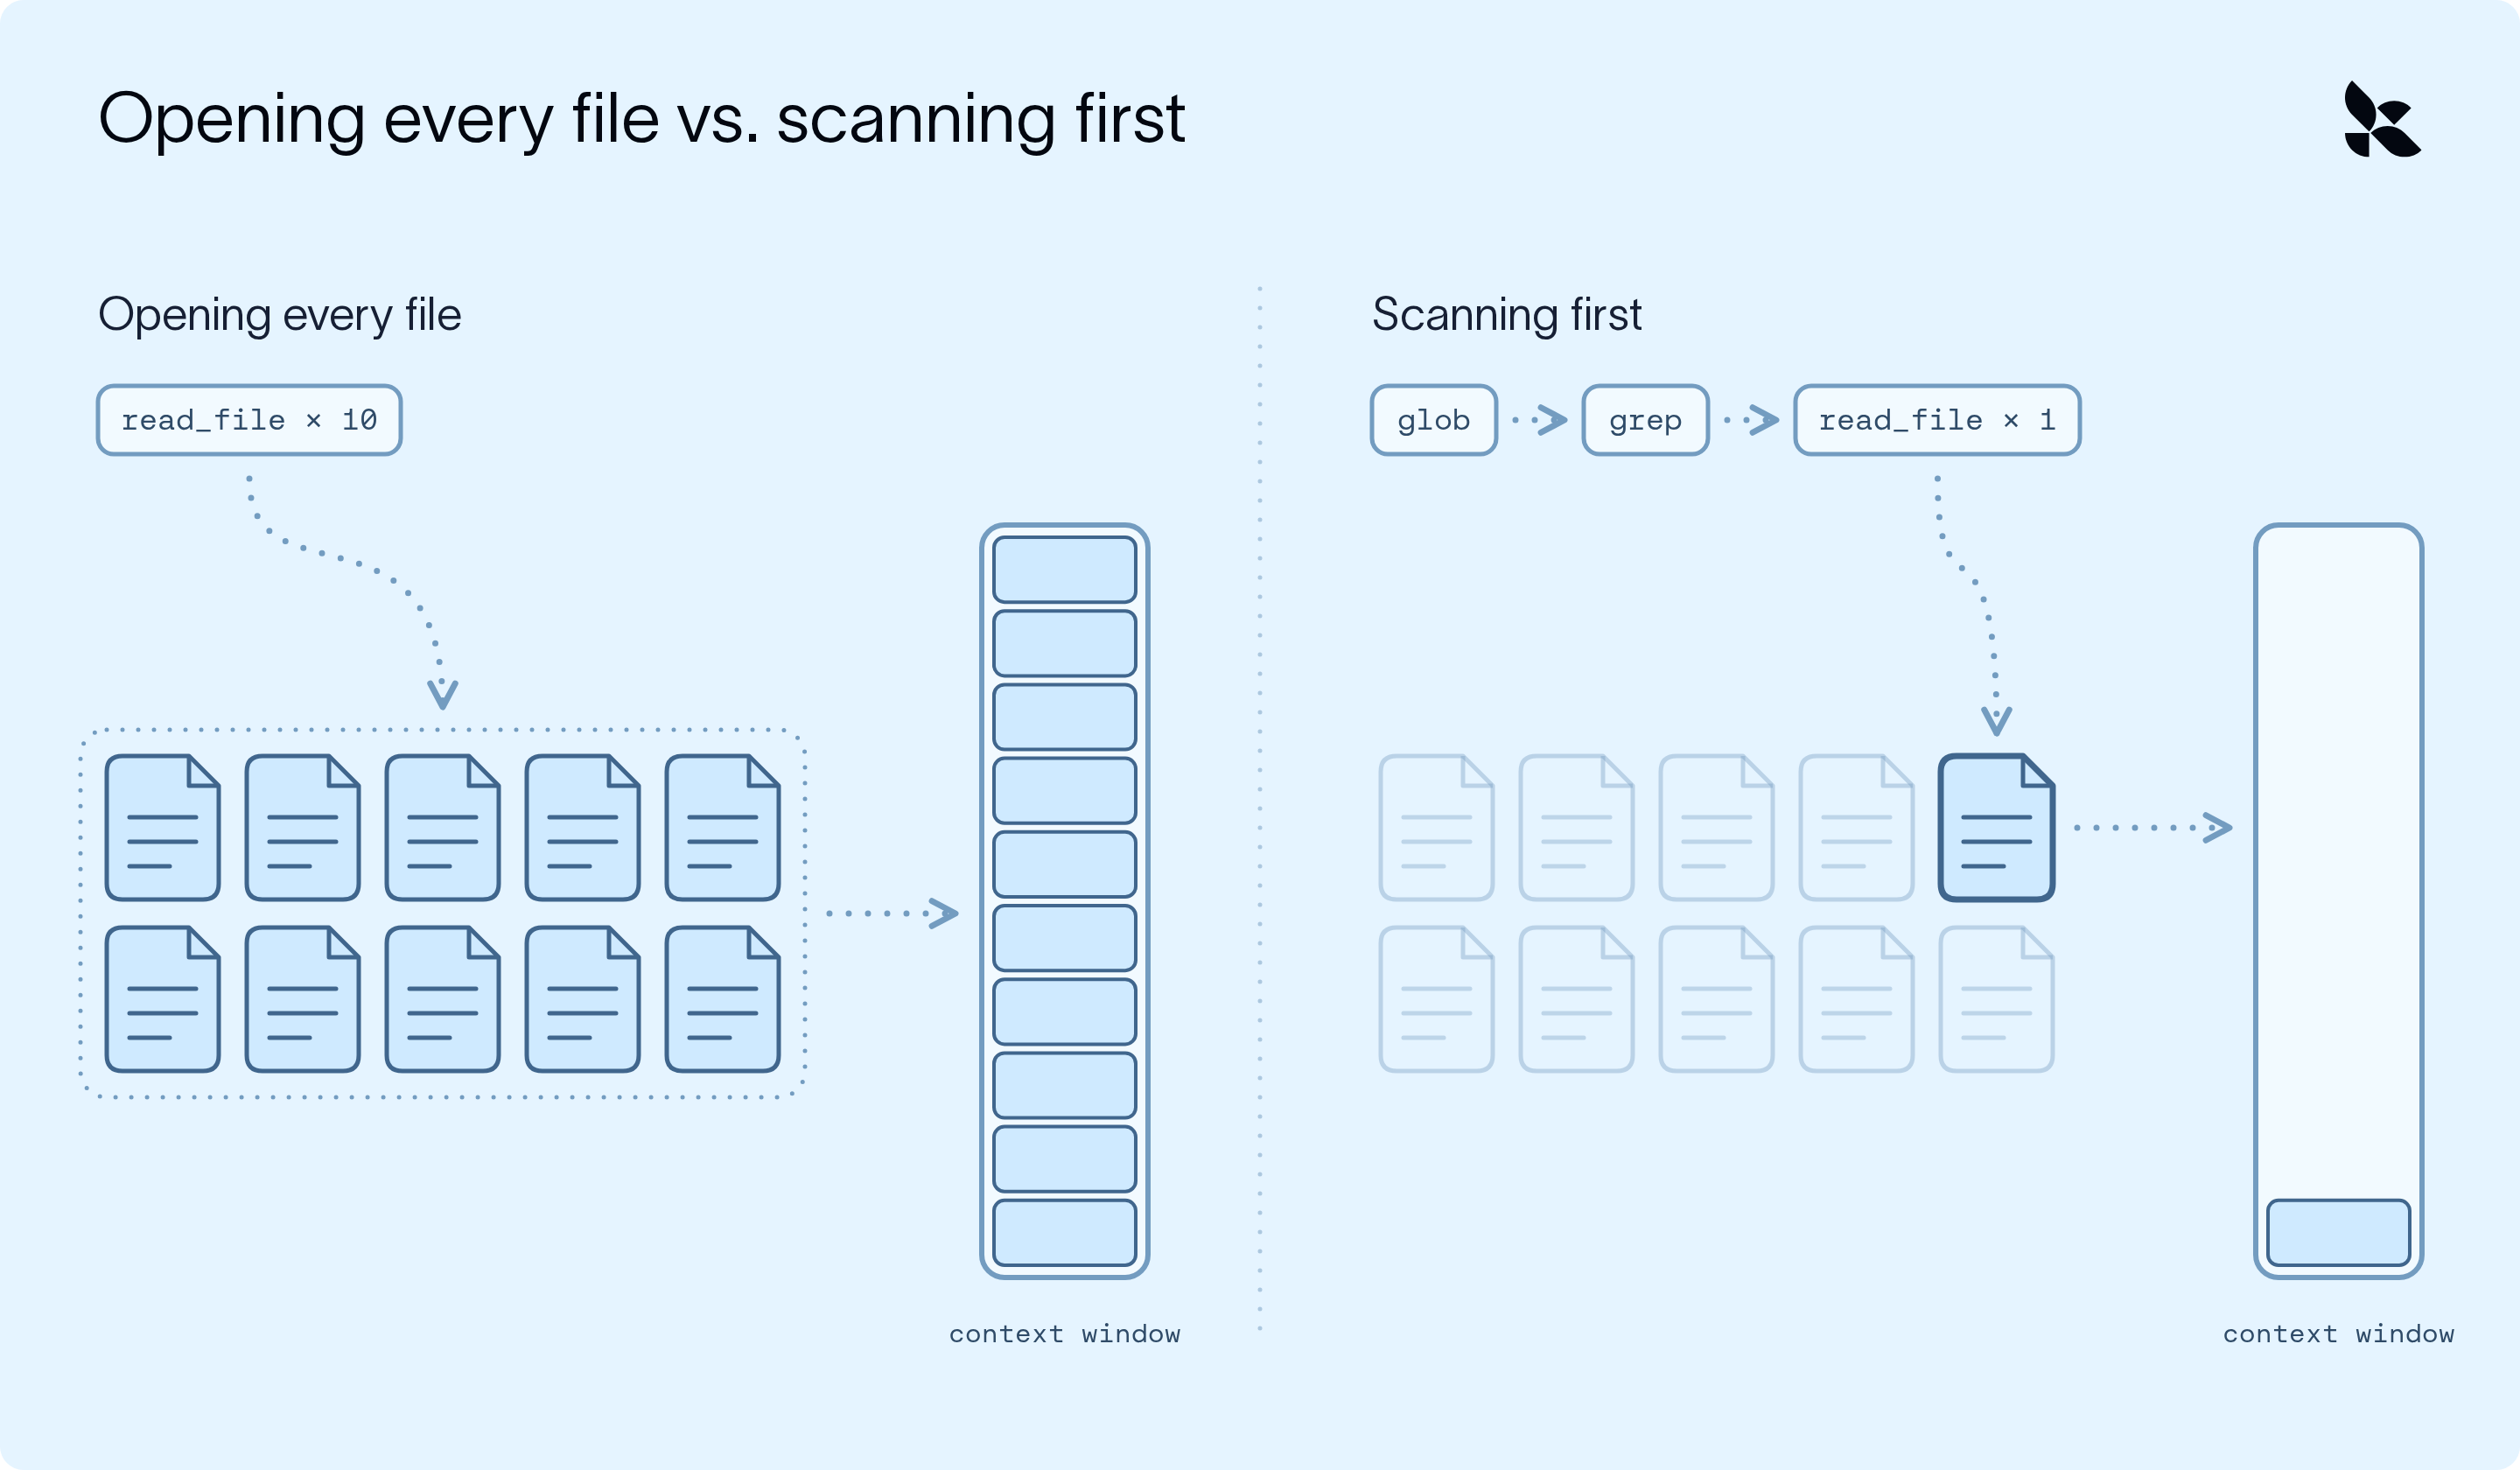
每个深度智能体(deep agent)都内置了这些工具,以及 ls、read_file、write_file 和 edit_file。无论文件位于何处(智能体状态、本地磁盘、持久化存储或沙箱),这些工具都能正常工作,因为它们都通过智能体的 backend 进行访问。
当关键词不足时添加检索工具
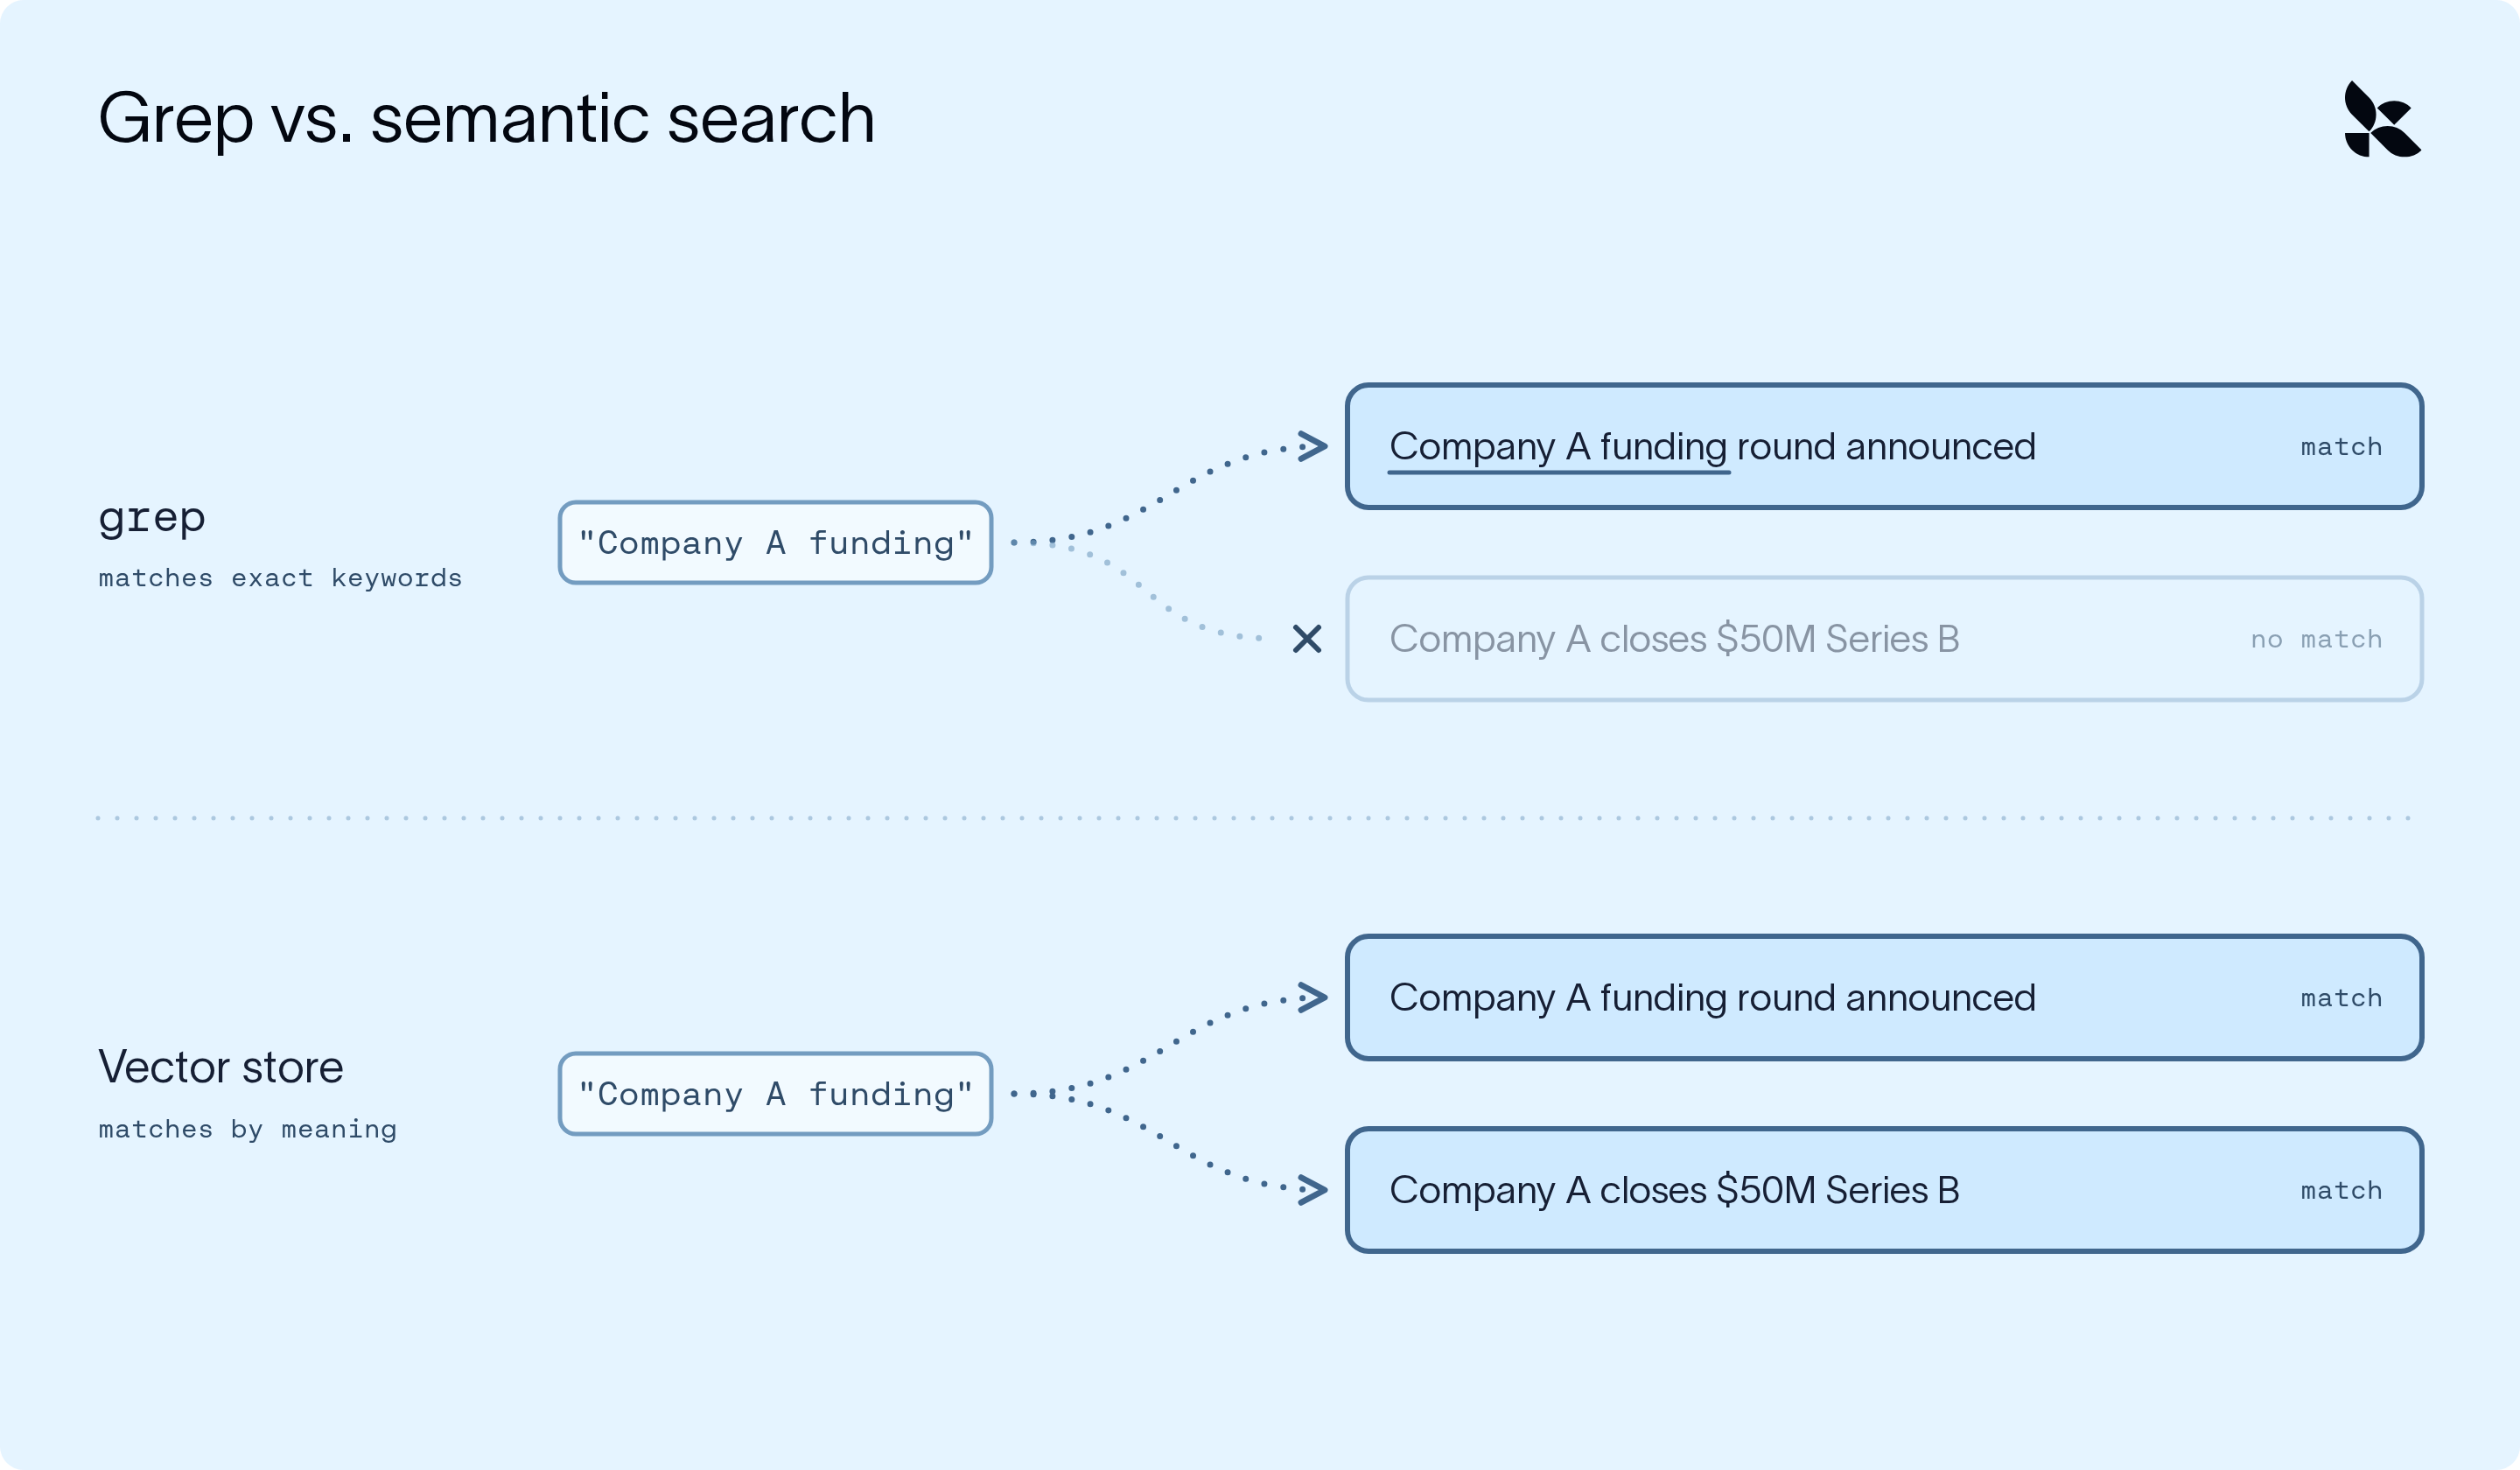
当你知道要查找的具体词汇时,Grep 非常有用,但它只能匹配你提供的确切文本。这对于我们示例中的第三个任务来说是个问题:在新闻档案中搜索任何新内容。如果我们的智能体 grep 搜索 "Company A funding",它将错过标题为 "Company A closes $50M Series B" 的文章,尽管这正是它在寻找的内容。
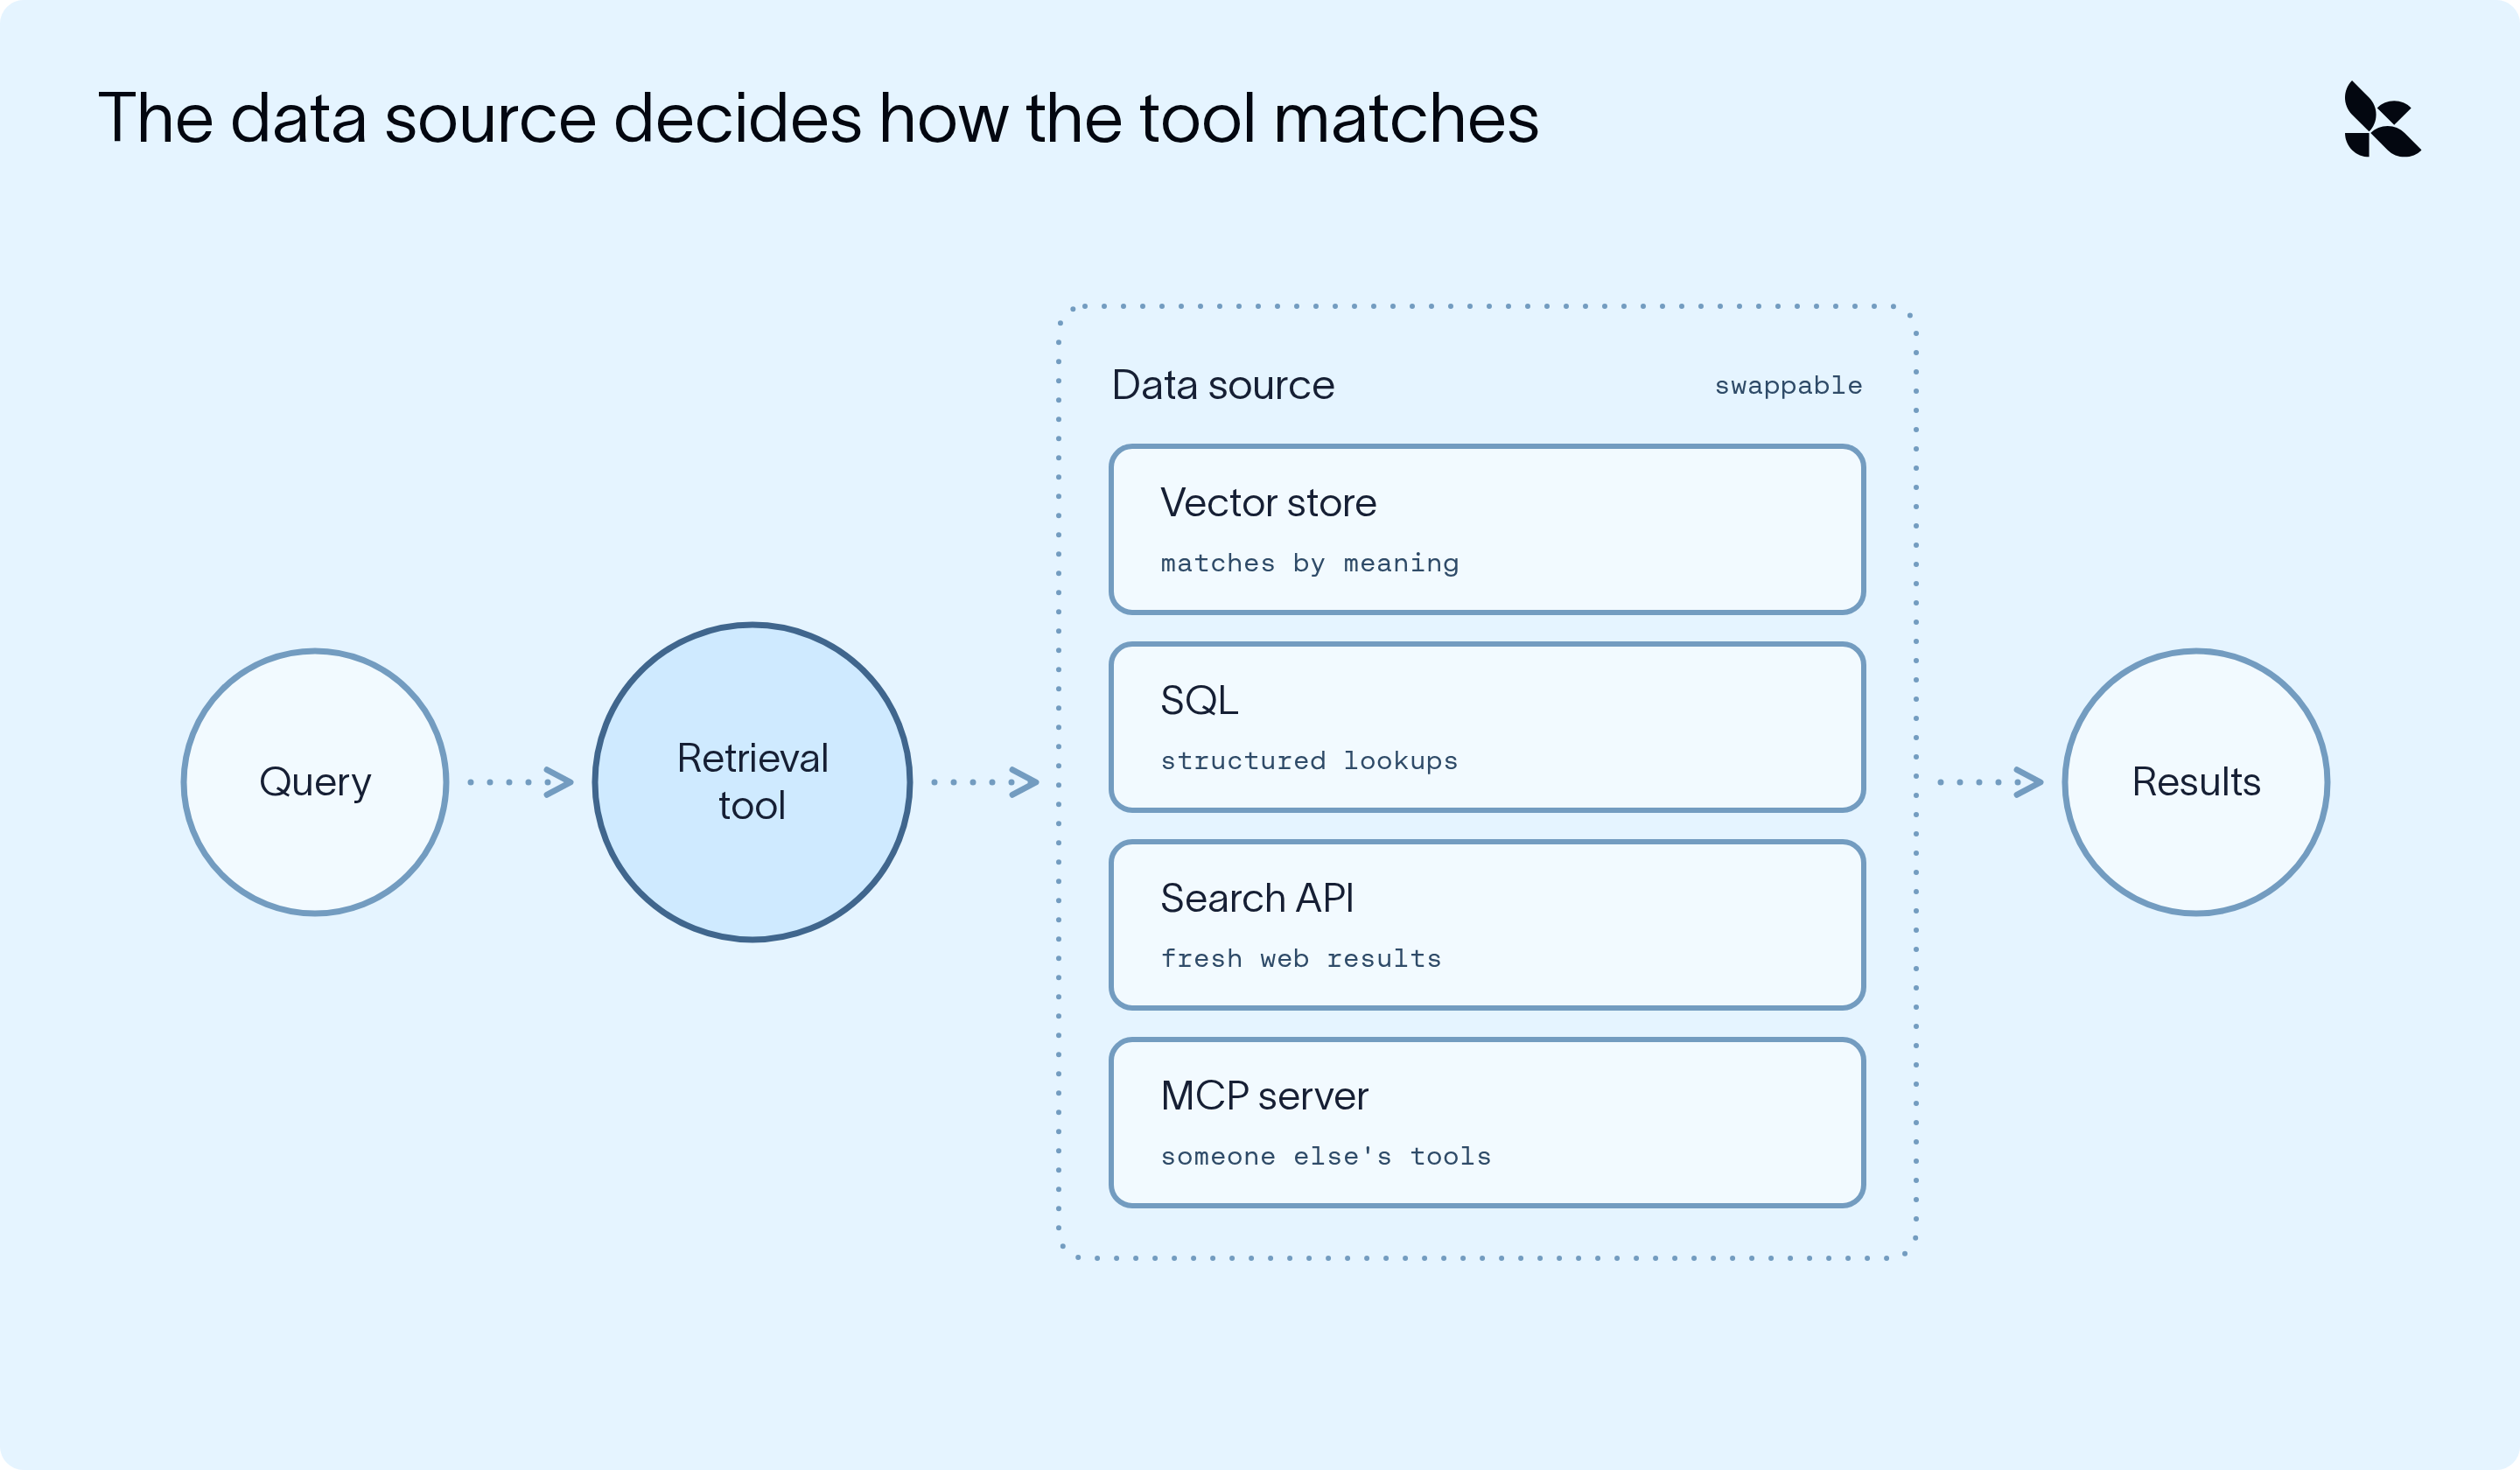
为了按含义而非确切词汇进行搜索(即语义搜索),你需要添加一个由 vector store 支持的 retrieval tool。检索工具是智能体可以调用来获取信息的任何工具:它接收一个查询,在某些数据源中查找该查询,并返回找到的结果(最匹配的项)。
检索工具的匹配方式取决于其背后的数据源。如果由 vector store 支持,它按含义匹配,但检索工具也可以建立在其他数据源之上:
- SQL 数据库,用于结构化查询(如销售数据或客户记录)
- 搜索 API(用于从网络获取最新信息)
- MCP server(用于其他人已经构建的工具,如文档搜索)
想深入了解语义搜索的工作原理,请参阅 LangChain 指南。
让智能体决定何时进行搜索
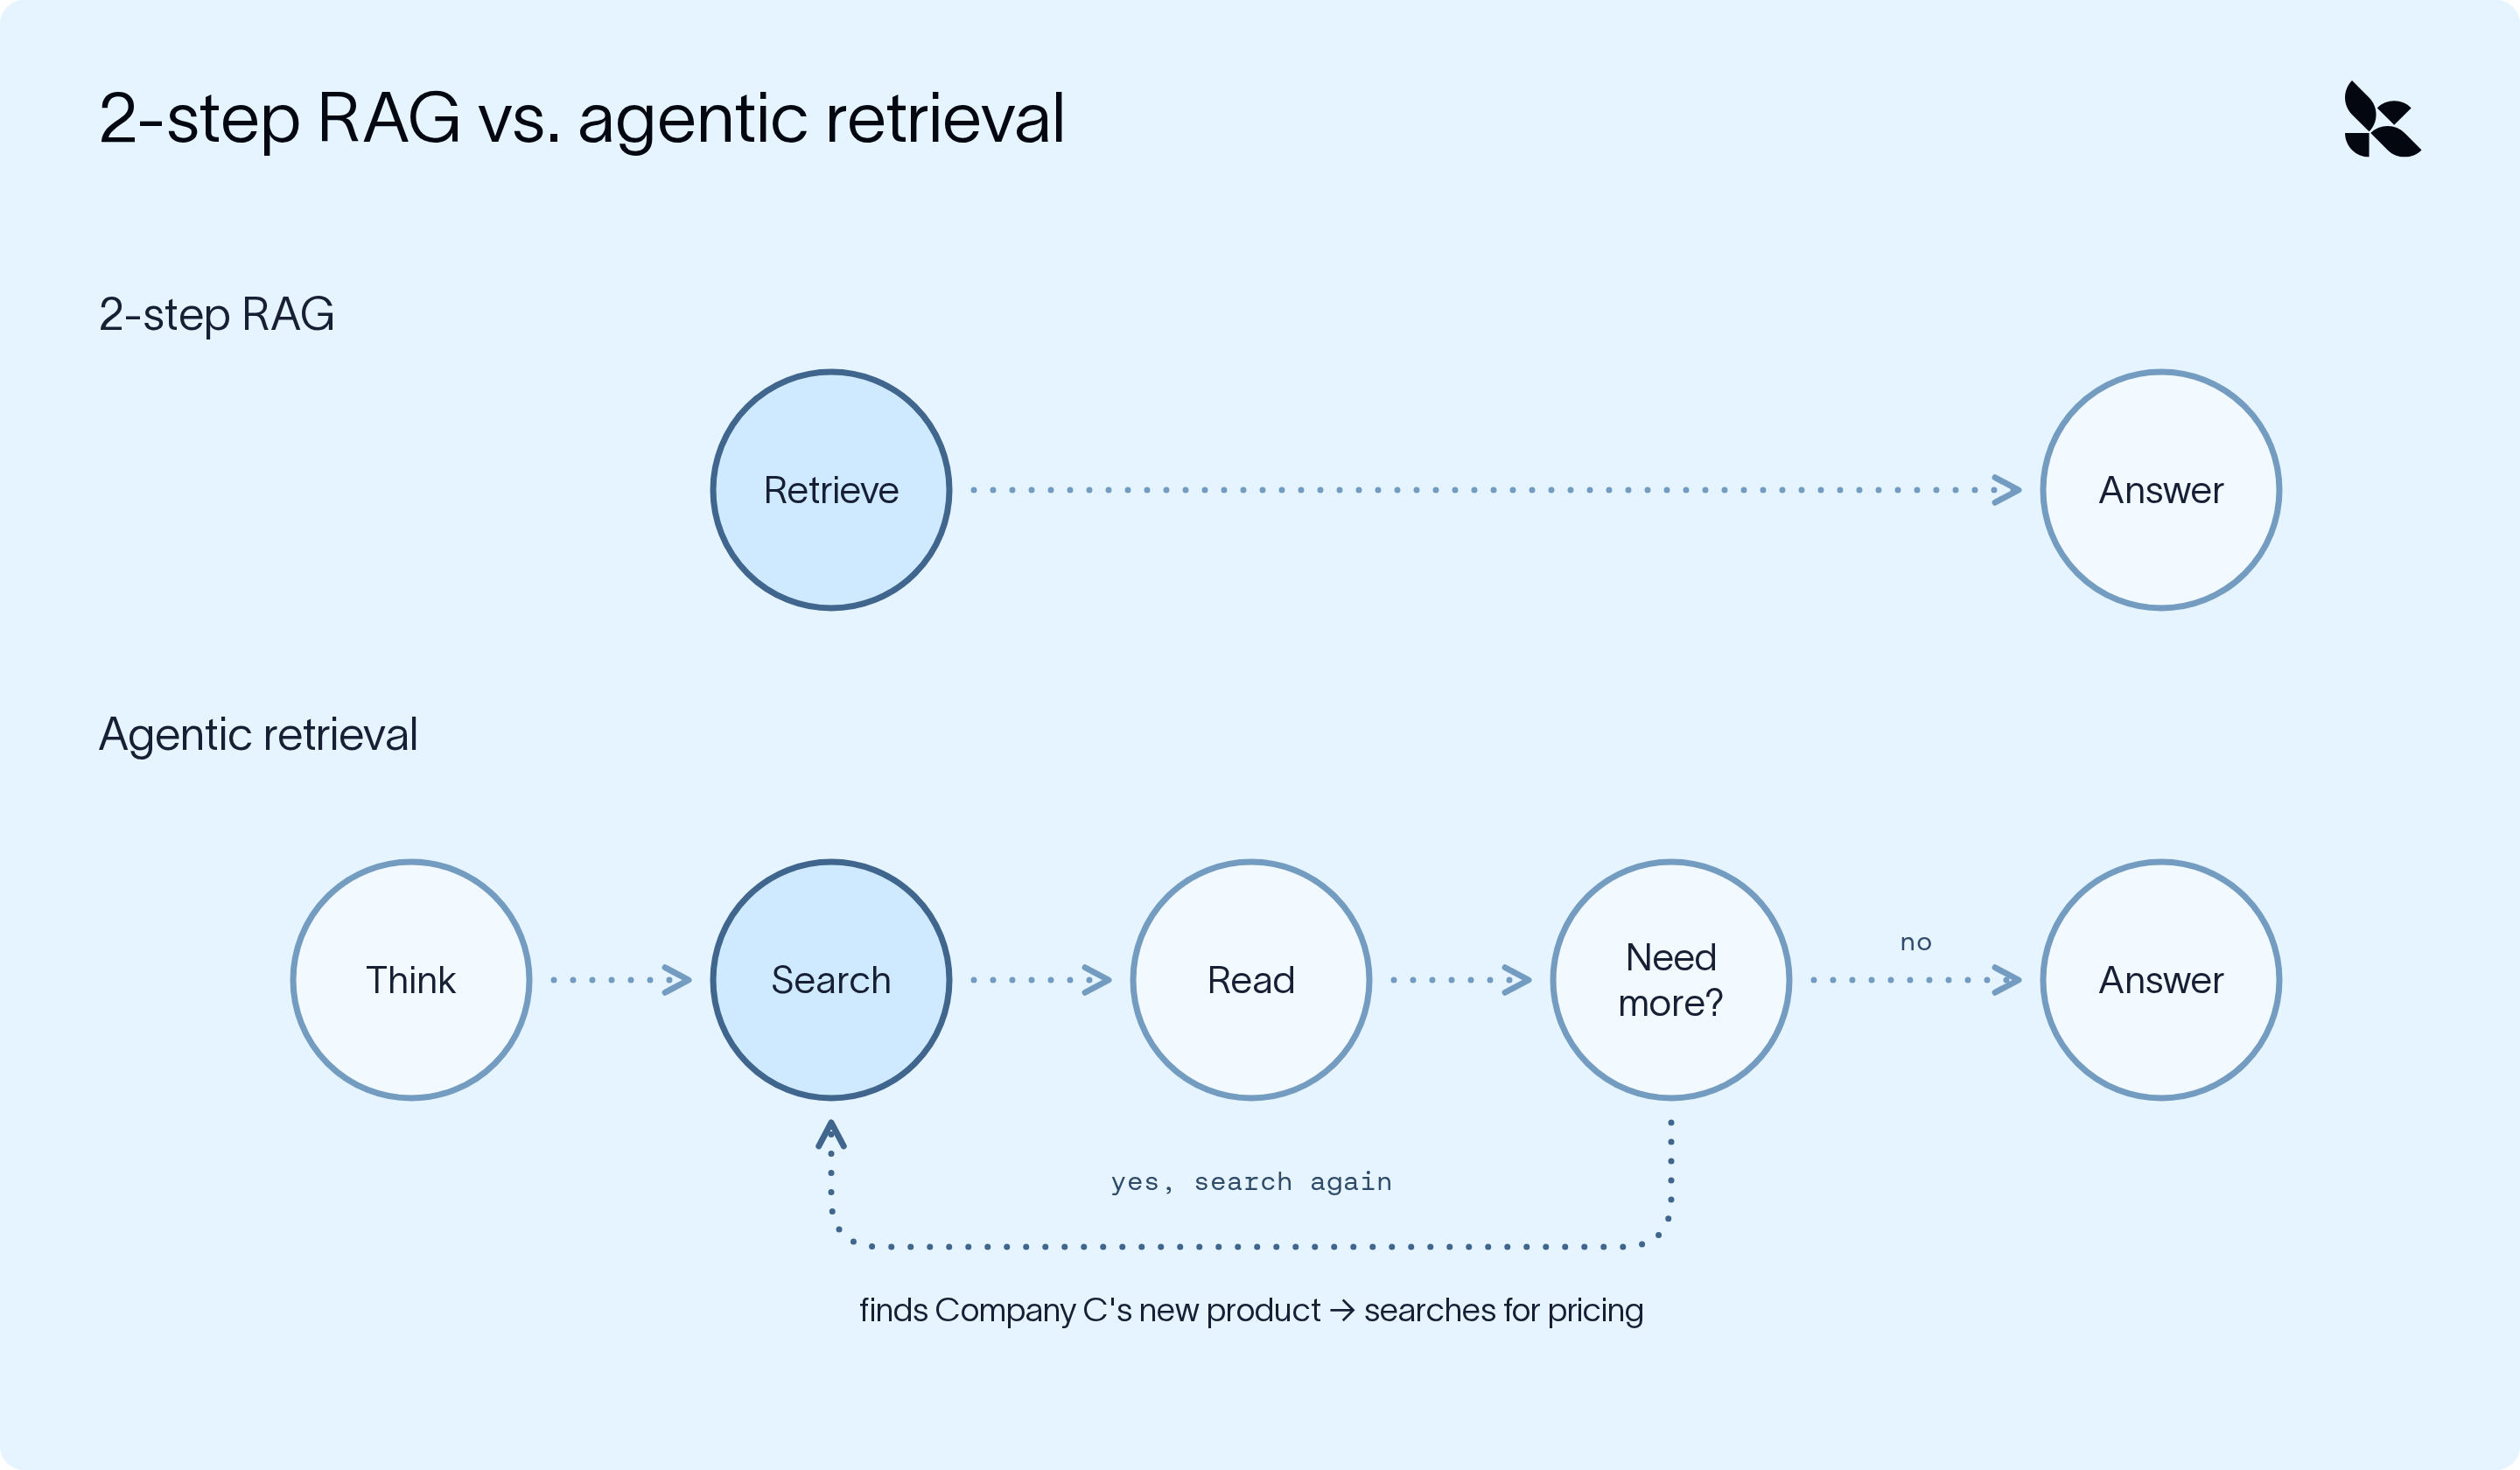
许多检索配置会在开始时执行一次搜索,然后直接生成答案。这种方式适用于 FAQ 机器人(2 步 RAG),但并不适合我们的智能体。例如,假设在研究公司 C 的过程中,智能体发现了一篇关于某产品发布的文章,而该产品此前并不在其已知范围内,现在它需要获取该产品的定价信息(这在初始阶段是无法预知并主动查找的)。如果仅进行一次搜索,最终生成的报告将缺失这一关键信息。
研究型智能体需要采用 Agentic Retrieval(而非 2 步 RAG):由智能体自行决定何时搜索、搜索什么内容,以及是否需要进一步检索。借助 Deep Agents,默认情况下即已实现这一机制:智能体以循环方式运行,可根据需要多次调用任意工具。
将搜索专业知识封装为技能
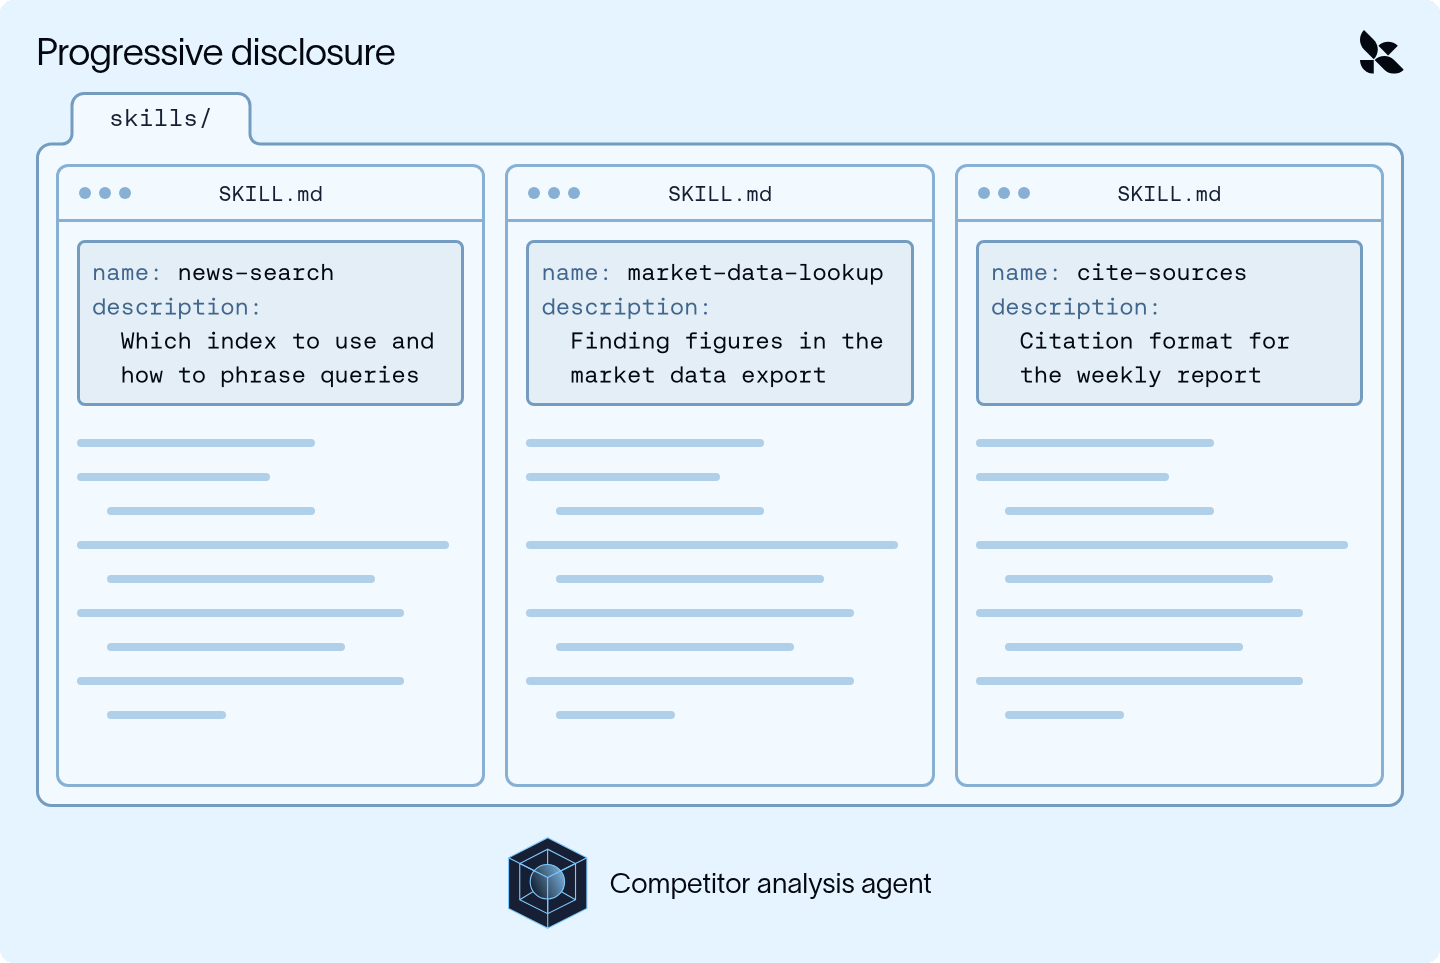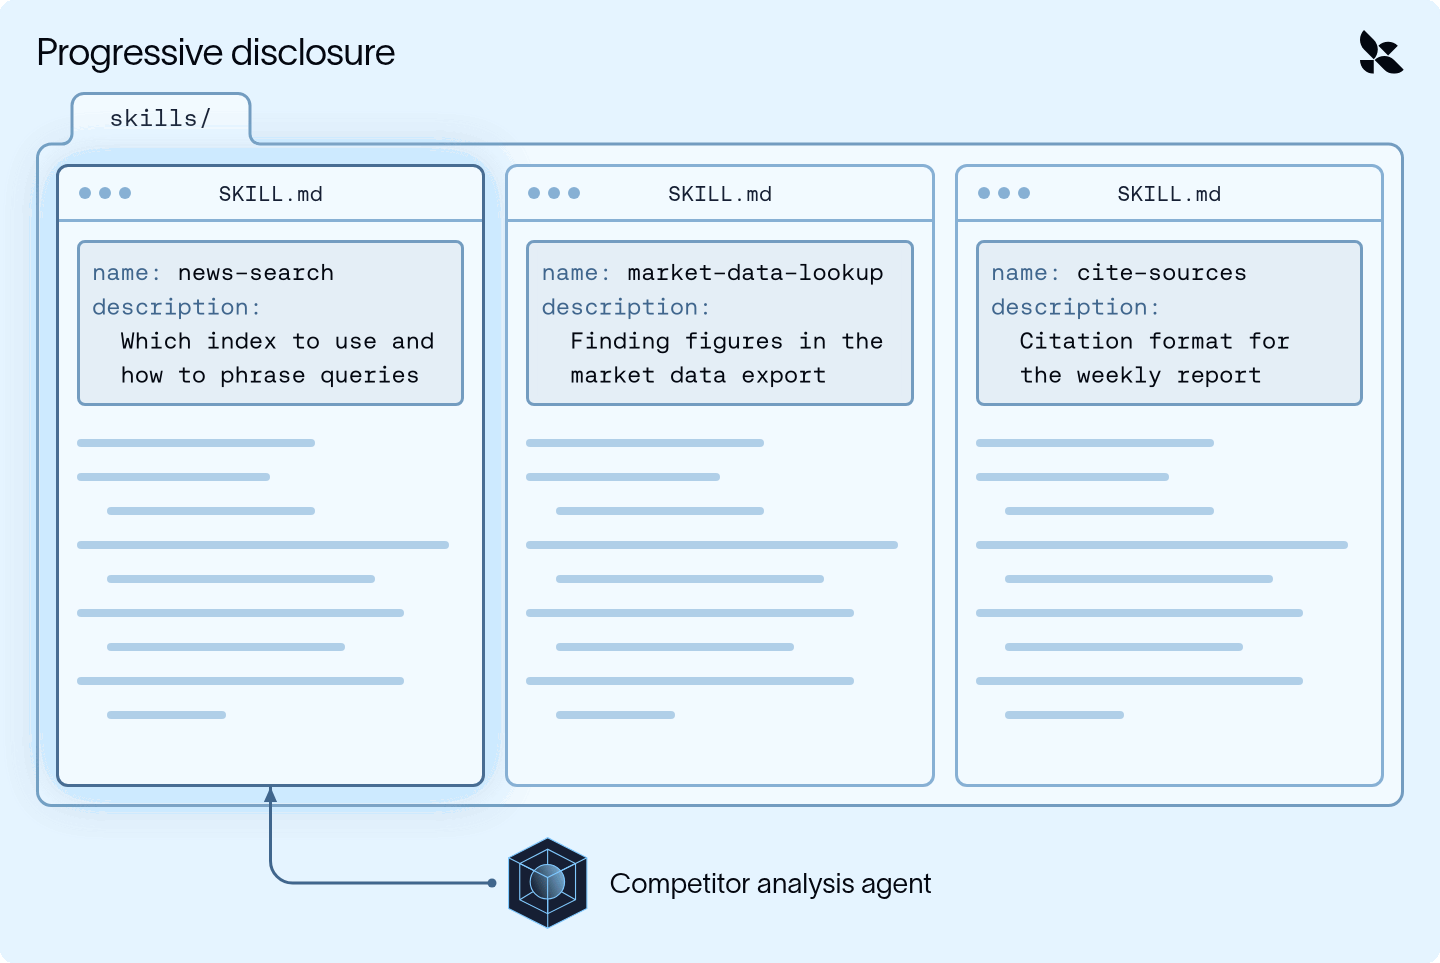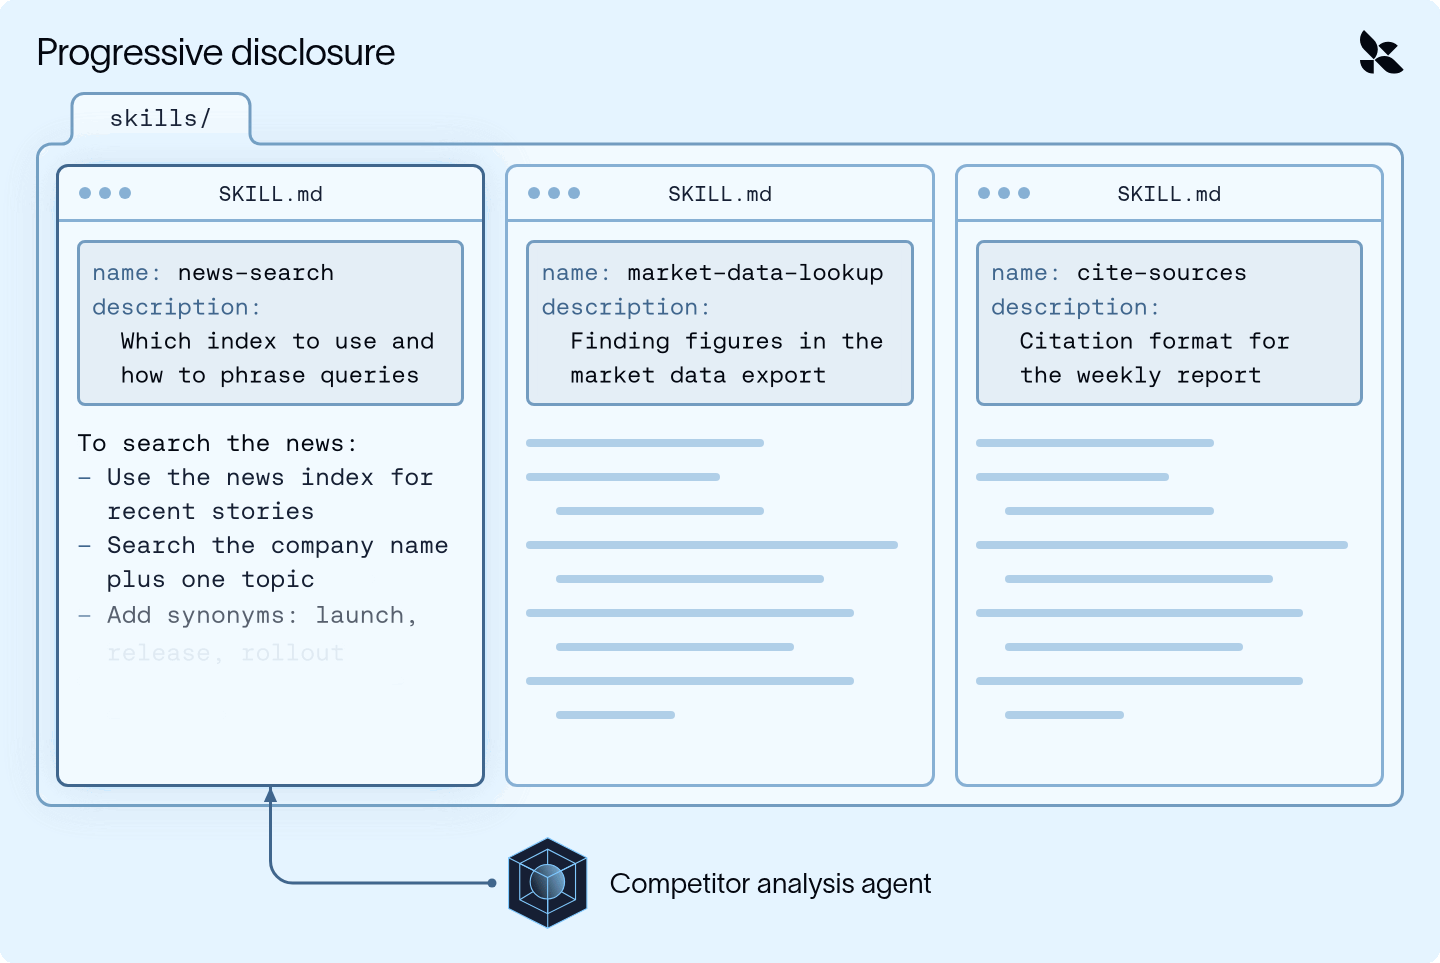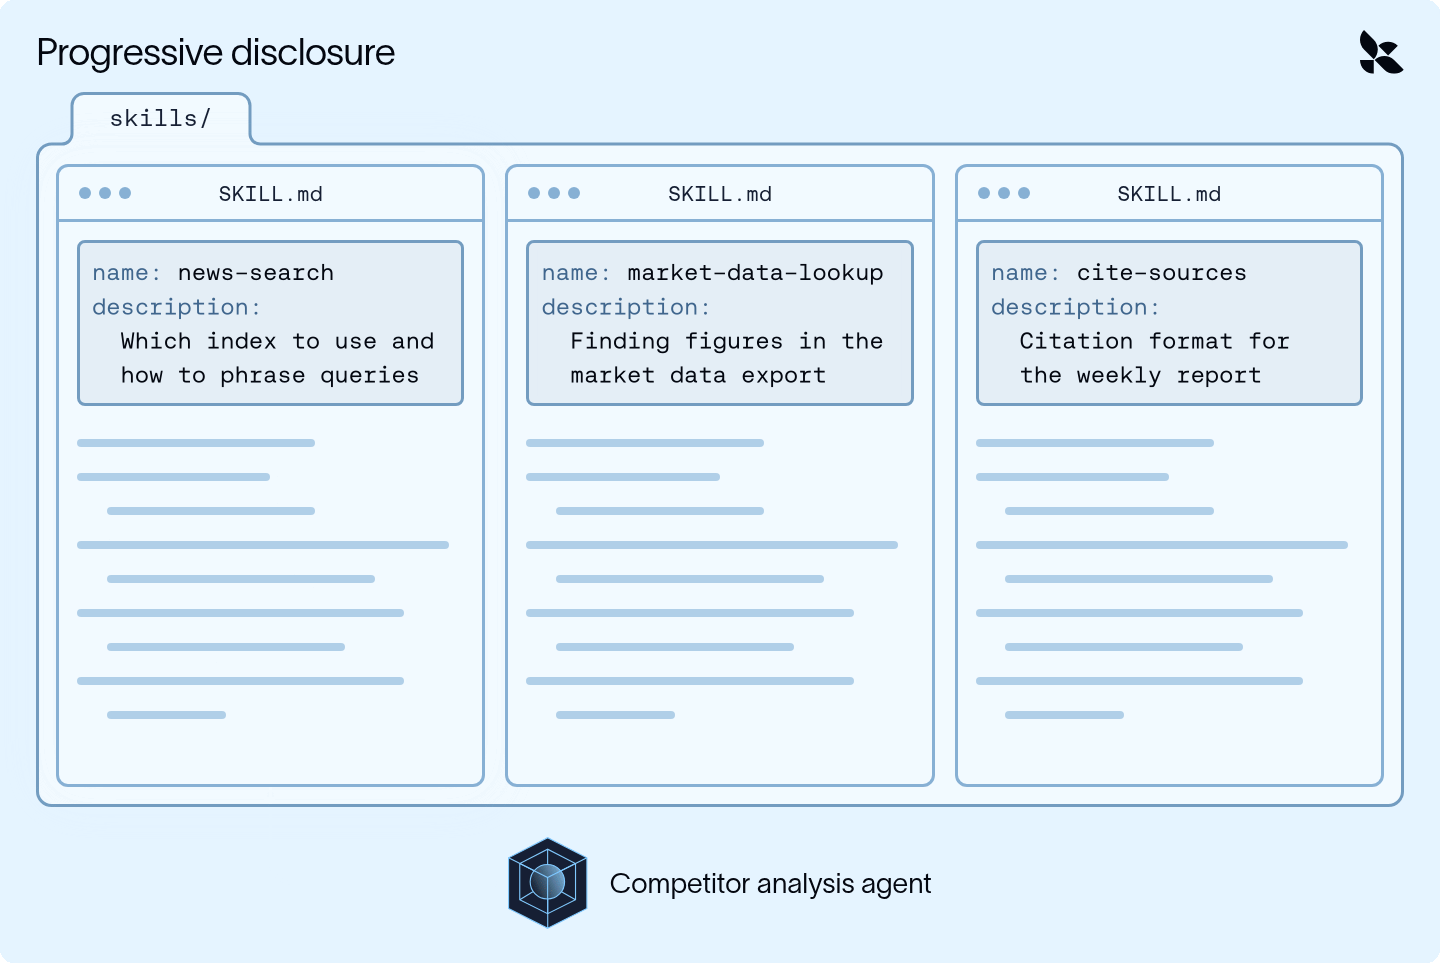
为了帮助智能体更高效地进行搜索,你可以将自身的搜索专业知识封装为一项 技能:即针对特定任务的一组指令(例如使用哪个索引、如何构造查询语句以及如何格式化引用等)。
在任务触发之前,智能体只能看到每项技能的名称和简短描述;当相关任务出现时,才会加载完整的指令内容。这种设计使得小众的专业知识仅在需要时才被引入,而在其余时间不会占用上下文窗口——这一技术被称为 渐进式披露。以下是关于该技术的 视频讲解。
渐进式披露(动画演示)
2. 一次性输入过多上下文
然而,即便优化了搜索流程,即使是正确的搜索结果也可能返回过多的数据。我们的智能体只需要从市场数据导出文件中提取一个数值(公司 B 的季度营收),但若要找到这个数值而加载全部 40,000 行数据,将会迅速填满其上下文窗口。我们的检索工具也面临同样的问题:如果它将每篇新闻文章原样返回给模型,那么每次搜索返回 4 条结果、覆盖 5 家公司,累积的数据量很快就会超出限制。
逐页读取大型文件
文件系统工具的设计目标是尽可能减少返回的数据量。read_file 每次只读取一页(默认 100 行),智能体可以设置偏移量(从哪一行开始)和限制数量(读取多少行),从而跳转到所需的部分。因此,为了查找公司 B 的收入数据,智能体会先通过 grep 搜索关键词,然后仅读取匹配项附近的几行内容。
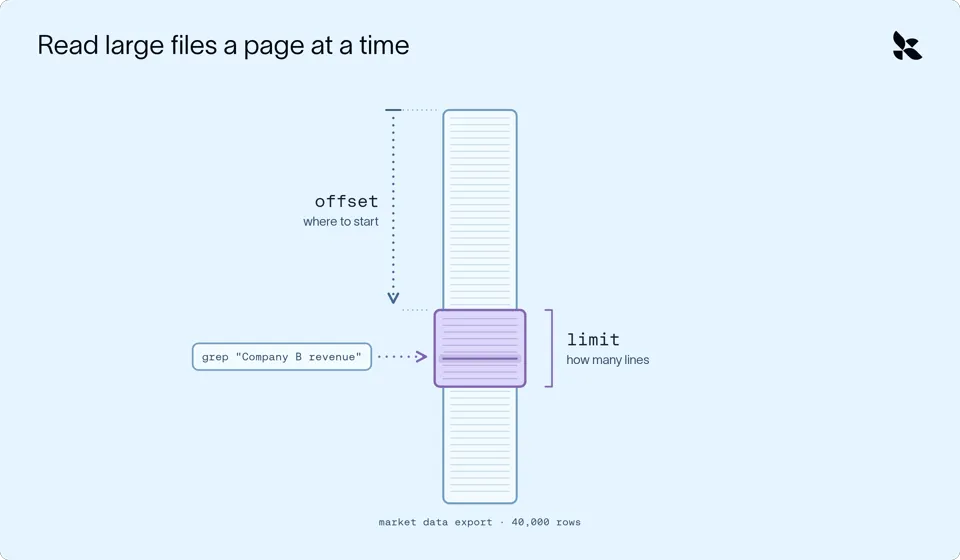
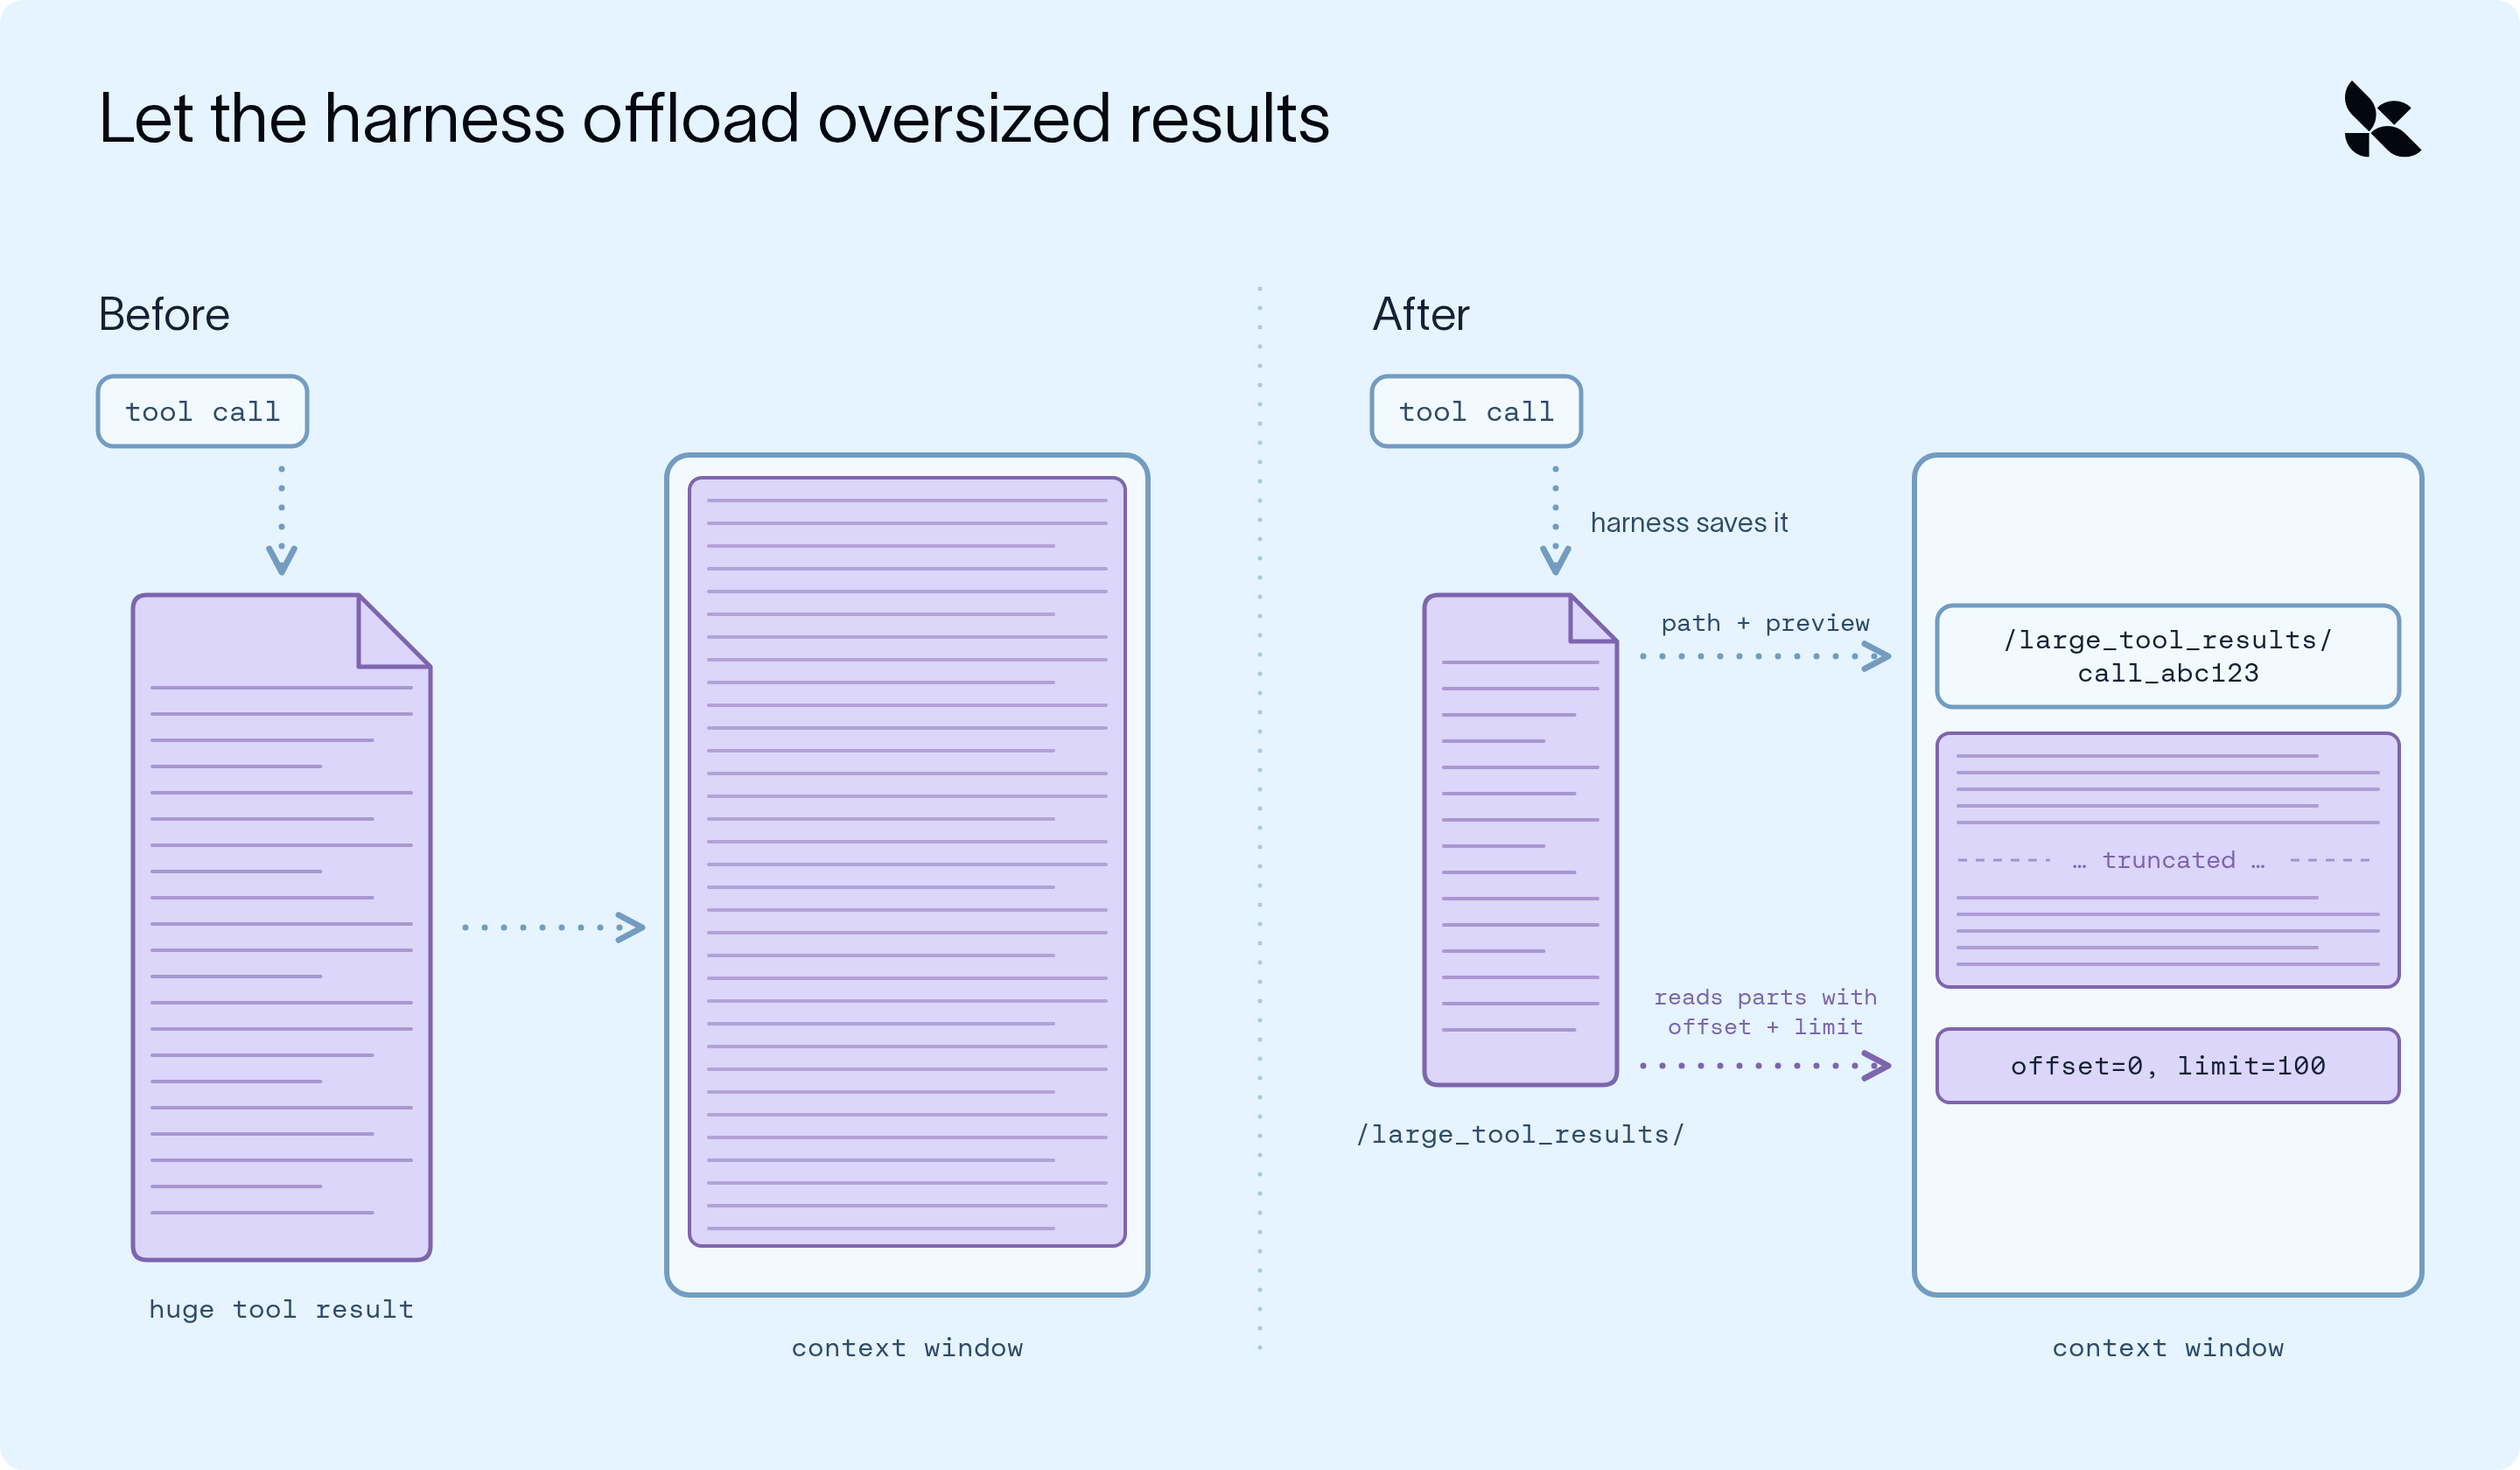
让执行框架卸载超大结果
有时工具返回的结果仍然超出预期。当工具结果过大时(超过约 20,000 个 token),执行框架会将其保存到 /large_tool_results/ 目录下的文件中,并向智能体提供该文件路径以及一个简短预览(首尾几行)。随后,智能体可以使用 read_file 的偏移量和限制参数,仅读取其需要的部分。
让你的检索工具返回文件路径
你可以将同样的思路应用于自己的检索工具,而不必等待达到大小限制:让工具将每个结果写入文件,并仅返回文件路径。这是“检索、卸载、委托”(retrieve, offload, delegate)模式的第一步(LangChain 的 RAG 指南对此进行了完整讲解)。
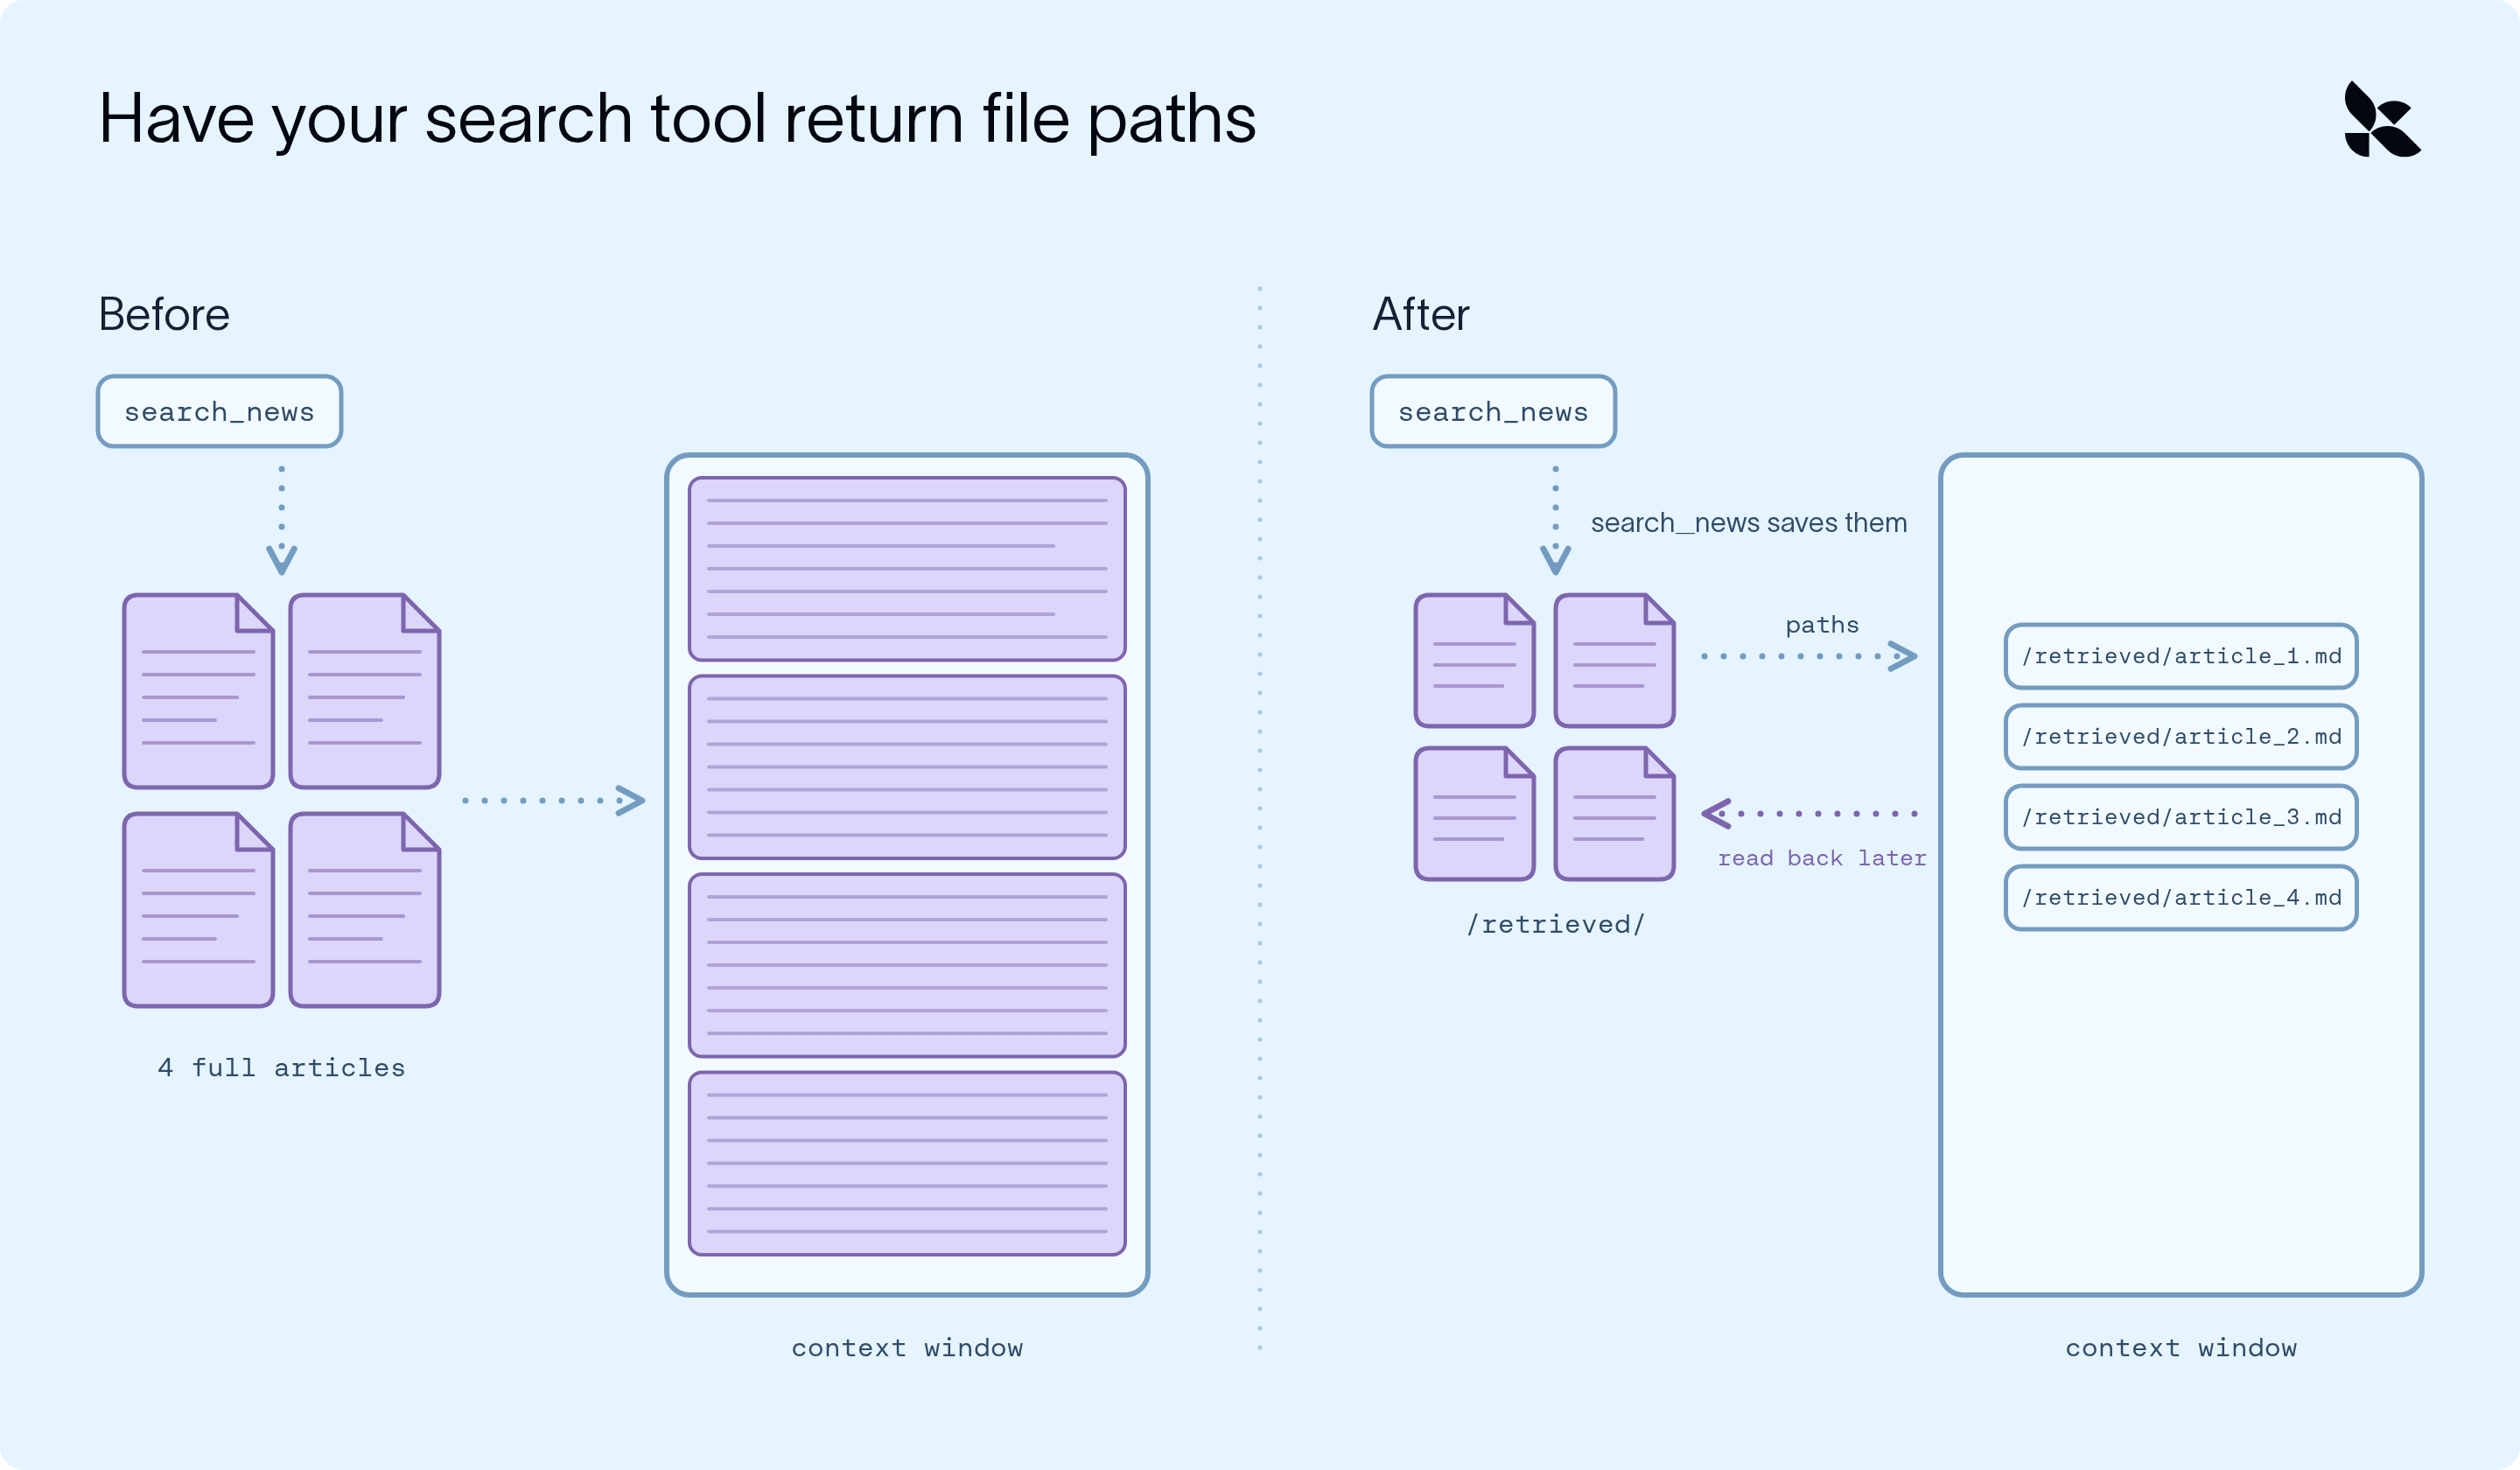
下面是一个简化的检索工具示例。它执行搜索操作,将每个结果保存为智能体 后端中的文件,并仅返回文件路径列表:
backend = StateBackend()

@tool
def search_news(query: str) -> str:
    """Search the news archive and save each result to a file."""
    docs = vector_store.similarity_search(query, k=4)
    files = [(f"/retrieved/result_{i}.md", doc.page_content.encode()) for i, doc in enumerate(docs)]
    backend.upload_files(files)
    return "Saved results to: " + ", ".join(path for path, _ in files)
现在,主智能体看到的是四个简短的路径,而不是四篇完整的文章。
3. 无关或过时的上下文
如果结果不对,哪怕数量再少也无济于事。这四个文件中的任何一个,都可能属于名称相似的另一家公司,或者是两年前的旧闻。对于模型而言,离题或过时的文本与正确答案一样具有说服力,因此目标是将这些内容完全排除在主 Agent 的上下文之外。
让子代理(Subagents)过滤结果
然而,主 Agent 仍然需要读取这些文件才能确定哪些是重要的(而它打开的每一篇离题文章都会进入其上下文)。这正是“检索、卸载、委派”(retrieve, offload, delegate)模式中“委派”环节发挥作用的地方:一个子代理负责读取每个检索到的文件,并仅返回关键事实。
- 定义子代理:描述信息告知主代理何时使用它(每次调用处理一个文件),系统提示词则告诉子代理如何处理该文件。
chunk_analyst = {
		"name": "chunk-analyst",
		"description": "Analyze one retrieved file. Pass the question and a single path under /retrieved/.",
		"system_prompt": "Use read_file to read the assigned file. Return the key facts and the source URL.",
}- 将检索工具和子代理赋予主代理。传入你在
search_news中使用的同一个后端实例,以便子代理能够读取工具保存的文件。
agent = create_deep_agent(
		model=model,
		tools=[search_news],
		backend=backend,  # same instance, so read_file can see /retrieved/
		subagents=[chunk_analyst],
)
现在的流程如下:
- 搜索:主代理调用
search_news,获得四个路径。 - 委派:它将每个路径发送给一个 chunk-analyst 子代理,这些子代理可以并行运行。
- 综合:每个分析师返回带有来源的简短摘要。主代理将它们整合起来,如果发现有遗漏,则再次进行搜索。
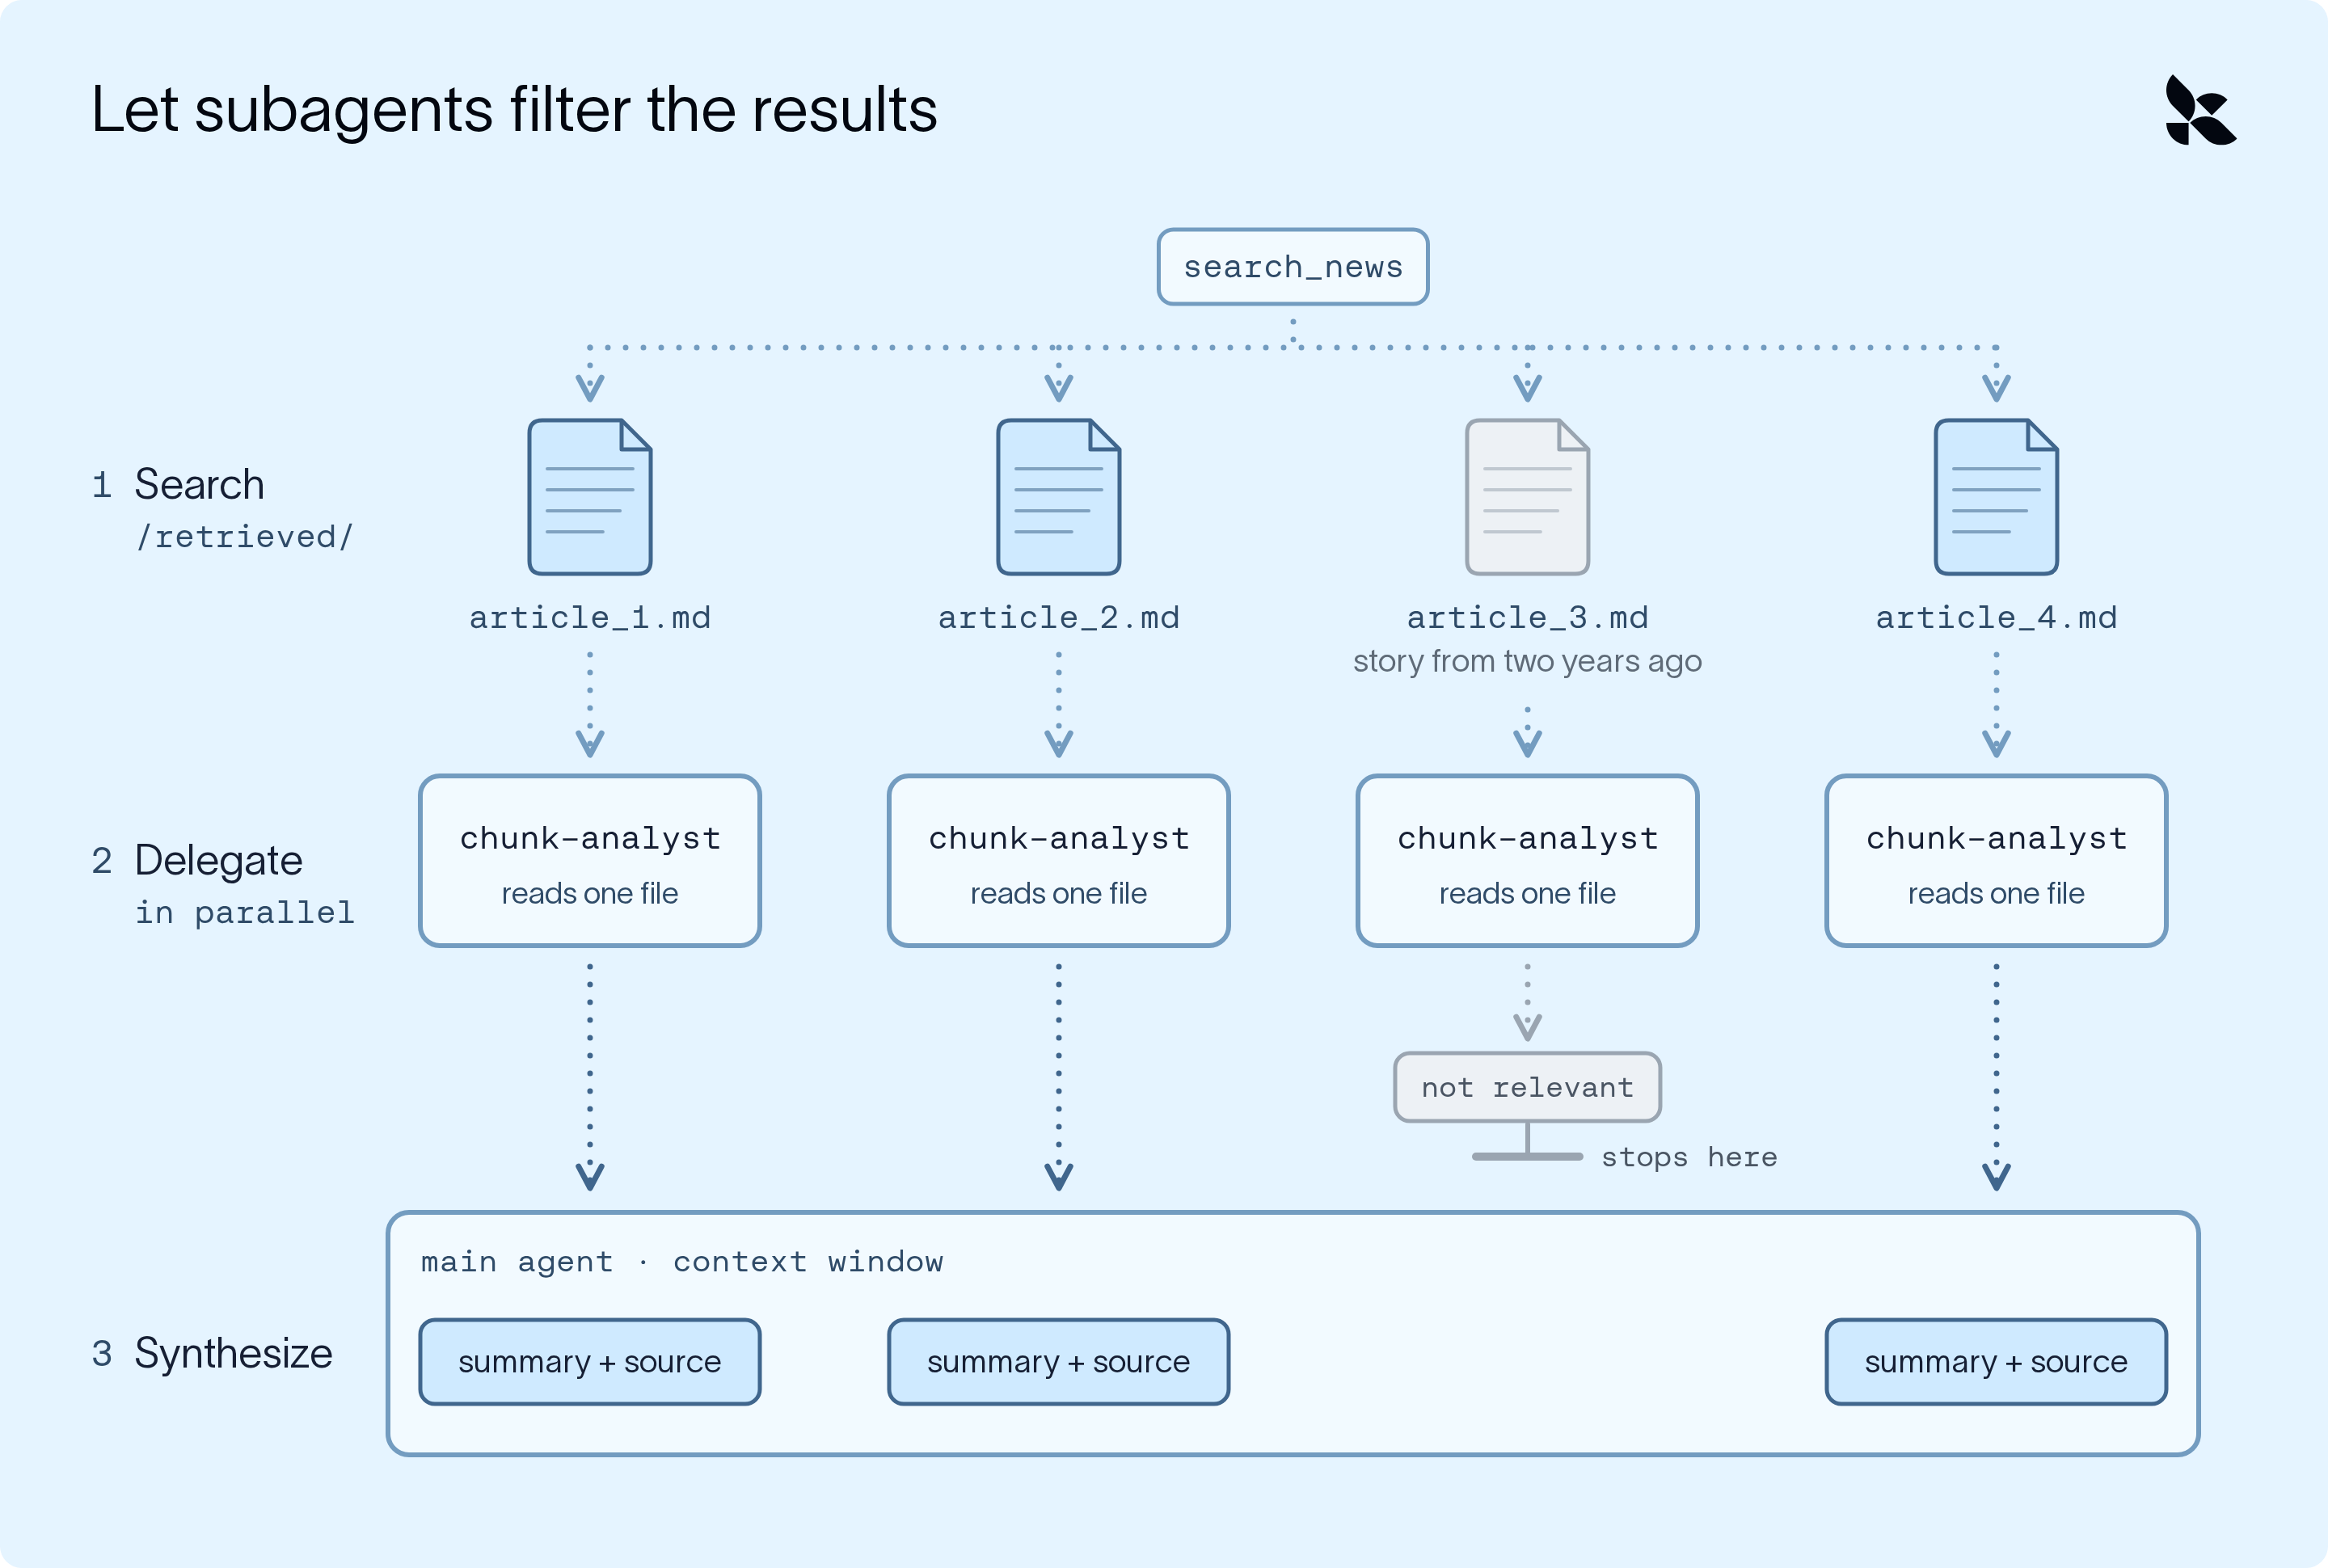
原始结果被写入文件,嘈杂的阅读过程发生在拥有独立上下文的子代理中,主代理只看到结论。任何离题的内容都留在子代理的上下文中,从而保持主代理上下文窗口的整洁!
从最新来源获取信息
过滤确实能排除离题的结果,但它无法修复过时的数据。我们的竞争分析代理每周一运行,因此上个月的索引无法捕捉到本周的新闻。
一种解决方案:搜索 API 或 MCP 服务器可以为智能体提供最新信息(而不是几个月前索引的内容)。如果你的数据包含日期,在检索工具中按日期过滤也可以排除过时的结果。
谨慎处理检索到的文本
另一方面,相关的最新结果也可能引发问题!由于检索到的文本是数据而非指令,任何检索到的内容都可能包含 提示注入(没有任何提示词或分隔符策略能完全防止这种情况)。务必验证输出:检查答案是否引用了你预期的来源,以及声明是否与这些来源一致。
需要牢记的检索策略
以下是需要注意的事项(无论你基于何种框架构建):
- 使用最高效且有效的工具。 如果你知道确切的关键词,
grep比嵌入查找更快。仅在真正需要时才使用语义搜索。 - 分页加载而非一次性读取。将大文件分块读取,而不是一次性全部加载。
- 返回指针而非载荷。 将检索到的内容写入文件,并将路径交给智能体。
- 委托阅读任务。 让子智能体负责阅读和总结,这样主智能体只需查看结论。
- 验证依据。 对照检索到的内容检查答案,并将检索到的文本视为不可信数据。
试一试
uv add deepagents想从现场讲师那里了解更多?我将于 11 月 9 日涵盖此主题:点击 此处 注册!
检索只是故事的一半:即信息如何找到通往智能体的路径。随着智能体随时间推移积累信息,我们该如何管理其上下文窗口?
欲了解更多信息,请查阅:
- 关于 Deep Agents 的上下文工程 的博客文章
- LangChain Academy 上的 Deep Agents 课程(免费、在线且自定进度)。

查看你的智能体实际在做什么
LangSmith 是我们的智能体工程平台,帮助开发者调试每一个智能体决策、评估变更并一键部署。