Artificial Analysis · 2026/10/15 08:00:00
NVIDIA RTX Spark N1X 首测:128GB 统一内存本地运行 Qwen3.8 智能体耗时 18.7 分钟
Artificial Analysis 发布首批 AA-AgentPerf-Local 基准测试结果,验证了 NVIDIA RTX Spark N1X 笔记本在本地运行 AI 智能体的性能。该设备凭借 Blackwell GPU 与最高 128 GB 统一内存,成功在 18.7 分钟内完成基于 Qwen3.8 27B 模型的完整智能体工作负载回放。这一数据为评估消费级高端硬件支持本地大模型推理的实际能力提供了量化参考。
报道全文原始报道全文
本文目录23 个章节
2026 年 10 月 15 日
NVIDIA RTX Spark N1X 笔记本电脑的首批 AA-AgentPerf-Local 测试结果
NVIDIA 的 RTX Spark N1X 在 Windows 笔记本中配备了高达 128 GB 的统一内存和 Blackwell GPU。在我们的首批 AA-AgentPerf-Local 结果中,一台 RTX Spark 笔记本在 Qwen3.8 27B 模型上完成本地智能体工作负载耗时 18.7 分钟。
笔记本与工作站长榜GitHub 上的 AA-AgentPerf-Local本文展示的是截至 2026 年 10 月 15 日的 AA-AgentPerf-Local 结果。由于图表实时更新,其数据可能与正文中的数字存在差异。如需查看最新结果,请访问 笔记本与工作站长榜。
AA-AgentPerf-Local 在本地硬件上重放已记录的智能体会话
AA-AgentPerf-Local 是我们的一款 开源工具,用于测量笔记本或工作站为 AI 智能体提供服务的速度。它会在机器上运行的模型服务器中重放已记录的智能体会话,每个请求都携带迄今为止的完整对话内容,并测量硬件响应每一轮交互所需的时间。
模型会生成与每轮记录完全一致的 token 数量,从而确保所有系统执行相同的工作量。大多数提示词都是对上一轮提示内容的重复。保留缓存的服务器只需读取每个任务的初始提示以及每轮新增的内容(中位数约为 450 个 token,在大型工具输出后最多可达 6.4K)。
8
已记录的智能体任务,其中五个来自 PinchBench,三个来自 SWE-bench
168
模型轮次,每一轮都携带完整的对话历史
56K
任务中最长上下文点的 token 数量
2.6M
整个工作负载中发送给模型的提示 token 总数
196K
新增提示 token(其余部分重复之前的提示)
31K
输出 token,在所有系统中数量一致
AA-AgentPerf-Local 默认工作负载
我们的排行榜涵盖了三种采用 4-bit 精度的模型,从 27B 稠密模型到 124B 混合专家模型,并在以下五个系统上进行测试。RTX Spark 笔记本加入了 NVIDIA DGX Spark、AMD Ryzen AI Halo、MacBook Pro (M5 Pro) 以及配备 GeForce RTX 5090 的台式机行列。
系统
MacBook Pro
M5 Pro · 64 GB · 20-core GPU
发布建议零售价 (64 GB)$3,000内存64 GB 统一内存内存带宽307 GB/s内存类型LPDDR5X-9600芯片M5 Pro发布时间2026年3月
AMD Ryzen AI Halo
发布建议零售价$4,000内存128 GB 统一内存内存带宽256 GB/s内存类型LPDDR5X-8000芯片Ryzen AI Max+ 395发布时间2026年7月
NVIDIA DGX Spark
发布建议零售价$4,000内存128 GB 统一内存内存带宽273 GB/s内存类型LPDDR5X-8533芯片GB10发布时间2025年10月
NVIDIA RTX Spark N1X
20-core CPU · 6144-core GPU
发布建议零售价 (128 GB)$5,900内存128 GB 统一内存内存带宽300 GB/s内存类型LPDDR5X-9400芯片N1X发布时间2026年10月
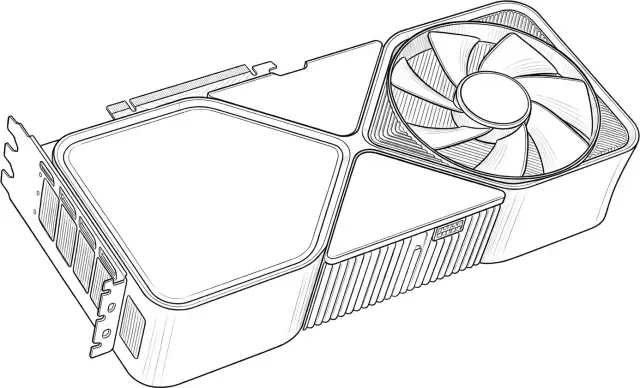
NVIDIA GeForce RTX 5090
发布建议零售价 (显卡)$2,000显存32 GB VRAM显存带宽1,792 GB/s显存类型GDDR7芯片RTX 5090发布时间2025年1月
Models
Qwen3.8 27B (Xhigh)
智能指数34总参数27B激活参数27B上下文窗口256K发布时间2026年8月测试构建版本Q4_K_M, UD-Q4_K_M
Qwen3.6 35B A3B (Reasoning)
智能指数18总参数36B激活参数3B上下文窗口256K发布时间2026年4月测试构建版本UD-Q4_K_M, NVFP4
Ling 3.0 Flash
智能指数20总参数124B激活参数5.1B上下文窗口256K发布时间2026年8月测试构建版本Q4_K_M
RTX Spark 将 DGX Spark 的芯片装入 Windows 笔记本
RTX Spark 是 NVIDIA 面向 Windows on Arm PC 的平台,NVIDIA 将其定位为可在本地运行 AI Agent 的设备。其 N1X 芯片本质上就是 DGX Spark 中的 GB10(在 NVIDIA 自家的配方目录中,RTX Spark 被列为 GB10),配备 20 核 Arm CPU、6,144 核 Blackwell GPU,以及两者共享的最高 128 GB LPDDR5X 内存。在笔记本电脑中,内存运行速度更快,相比 DGX Spark 提供了多 10% 的带宽(300 GB/s 对 273 GB/s)。然而,该芯片的运行功耗为 45 至 80 W(NVIDIA 公布的 N1X 笔记本范围),而 GB10 的额定功耗为 140 W。
我们测试了一款原型版 15 英寸 Surface Laptop Ultra,配备 128 GB 内存,售价为 5,899.99 美元。该设备运行 Windows 11 on Arm 系统,并通过 GPU 上的原生 Windows 版 llama.cpp 为所有模型提供服务。我们在插电状态下进行测试,并将 Windows 电源模式设置为高性能模式。
| RTX Spark N1X | GB10 (DGX Spark) | M5 Pro (MacBook Pro 14-inch) | |
|---|---|---|---|
| CPU | 20 核(10 Cortex-X925,10 Cortex-A725) | 20 核(10 Cortex-X925,10 Cortex-A725) | 18 核 |
| GPU | Blackwell,6,144 CUDA 核心 | Blackwell,6,144 CUDA 核心 | 20 核 |
| 统一内存 | 128 GB LPDDR5X-9400 | 128 GB LPDDR5X-8533 | 64 GB LPDDR5X-9600 |
| 内存带宽 | 300 GB/s | 273 GB/s | 307 GB/s |
| 芯片功耗 | 45 至 80 W | 140 W | 未公布 |
| 操作系统 | Windows 11 on Arm | DGX OS (Ubuntu) | macOS |
规格数据来源于 NVIDIA 的 RTX Spark 页面和移植指南、NVIDIA 的 DGX Spark 文档 以及截至 2026 年 10 月的 Apple 官方资料,内存速度则基于我们实际测试的系统报告值。
每个系统采用各自的优化方案
我们为每个系统选择特定的配置方案来运行模型;若厂商已发布推荐方案,则优先采用。因此,各系统在运行时环境、投机解码(speculative decoding)及 4-bit 权重格式上存在差异。RTX Spark 笔记本采用了 NVIDIA 针对 RTX Spark 发布的 llama.cpp 配置方案,并依据 NVIDIA 的设置将其移植到 AA-AgentPerf-Local 中。
| Qwen3.8 27B | 运行时环境 | 权重格式 | 投机解码 |
|---|---|---|---|
| RTX Spark 笔记本 | llama.cpp, Windows | UD-Q4_K_M | DFlash,7 个草稿 token |
| DGX Spark | llama.cpp, Linux | UD-Q4_K_M | DFlash,7 个草稿 token |
| MacBook Pro (M5 Pro) | llama.cpp, macOS | Q4_K_M | MTP,4 个草稿 token |
| AMD Ryzen AI Halo | llama.cpp, Linux | Q4_K_M | MTP,2 个草稿 token |
| GeForce RTX 5090 台式机 | llama.cpp, Linux | Q4_K_M | MTP,2 个草稿 token |
上述表格展示了使各系统在 Qwen3.8 27B 模型上达到最快推理速度的具体配置方案
我们也在测试更多权重格式和运行时,包括更小的 4-bit 格式(如 IQ4_XS)以及 Inco AI 的 Splash——这是一款面向 Apple Silicon 的 Metal 引擎,采用 DFlash 推测解码技术。待这些方案通过我们的精度校验后,我们将公布其测试结果,相关数据即将发布。早期测试显示,在部分系统上完成时间有所缩短。
RTX Spark 笔记本完成工作负载耗时 8-19 分钟,具体取决于模型
- ➤在 Qwen3.8 27B 上,RTX Spark 笔记本完成工作负载耗时 18.7 分钟,接近 DGX Spark(17.3 分钟),比 MacBook Pro(37.6 分钟)快 2.0 倍,比 Ryzen AI Halo(34.5 分钟)快 1.8 倍。GeForce RTX 5090 台式机速度最快,仅需 4.9 分钟。
- ➤在 Qwen3.6 35B A3B(每个 token 激活 3B 参数)上,耗时为 7.6 分钟,接近 DGX Spark(7.3 分钟),比 Ryzen AI Halo(11.7 分钟)快 1.5 倍,比 MacBook Pro(11.9 分钟)快 1.6 倍。
- ➤在 Ling 3.0 Flash(我们排行榜上最大的模型)上,耗时为 15.3 分钟,接近 DGX Spark(14.9 分钟),比 Ryzen AI Halo(25.1 分钟)快 1.6 倍。其 77 GB 的权重无法装入 MacBook Pro 或 RTX 5090。
各模型在各系统上的完成时间
完成 AgentPerf-Local 默认工作负载(168 轮对话,172 次工具调用)所需时间 · 数值越低越好MacBook Pro (M5 Pro, 64 GB)64 GB 统一内存AMD Ryzen AI Halo128 GB 统一内存NVIDIA DGX Spark128 GB 统一内存NewNVIDIA RTX Spark Laptop128 GB 统一内存NVIDIA GeForce RTX 509032 GB 显存Qwen3.8 27B (Xhigh)27B 参数37.6 min34.5 min17.3 min18.7 min4.9 minQwen3.6 35B A3B (Reasoning)36B, 3B 激活参数11.9 min11.7 min7.3 min7.6 min2.0 minLing 3.0 Flash124B, 5.1B 激活参数Does not fitin 64 GB unified25.1 min14.9 min15.3 minDoes not fitin 32 GB VRAMFasterSlowerDoes not fit in memory
系统回答工作负载中所有记录代理任务轮次的总耗时。轮次逐一发送,每轮包含此前的对话历史,且模型生成的 token 数量与原始记录保持一致,因此每个系统执行的工作量相同。运行工具所花费的时间不计入内。
Qwen3.6 35B A3B(每个 token 激活 3B 参数)在所有系统上都是最快的模型,RTX Spark 笔记本完成它仅需 7.6 分钟,而 Ling 3.0 Flash 需要 15.3 分钟,稠密模型 Qwen3.8 27B 则需要 18.7 分钟。GeForce RTX 5090 台式机在所有能装入其 32 GB 显存的模型上均为最快系统。
Completion Time|Qwen3.8 27B (Xhigh)
完成 AgentPerf-Local 默认工作负载(168 轮对话,172 次工具调用)所需时间 · 数值越低越好
系统回答工作负载中记录的代理任务每一轮所需的总时间。每轮对话单独发送,包含此前的完整对话历史,且模型生成的 token 数量与原始记录完全一致,因此所有系统执行的工作量相同。运行工具所花费的时间不计入内。
这些系统的价格仅为近似值,且每周都会波动。按当前价格计算,5,899.99 美元的 RTX Spark 笔记本电脑比 MacBook Pro(约 3,700 美元)和 Ryzen AI Halo(4,000 美元)更贵,但略低于 DGX Spark(约 6,000 美元)。RTX 5090 台式机是最昂贵的系统,约为 9,500 美元(显卡约 7,000 美元,加上其余 PC 组件保守估计的 2,500 美元)。下图使用了这些价格,我们的排行榜也允许你输入自己的价格。
完成时间与价格对比 | Qwen3.8 27B (Xhigh)
在测试系统上完成 AgentPerf-Local 默认工作负载所需时间与其价格的对比 · 时间和价格越低越好最具吸引力象限帕累托前沿线2026 年 10 月的近似当前价格
系统回答工作负载中记录的代理任务每一轮所需的总时间。每轮对话单独发送,包含此前的完整对话历史,且模型生成的 token 数量与原始记录完全一致,因此所有系统执行的工作量相同。运行工具所花费的时间不计入内。
截至 2026 年 10 月的近似当前美元价格。仍按发布建议零售价(MSRP)销售的系统采用该价格。独立显卡的价格为显卡本身加上 2,500 美元(任意估算值)作为系统其余部分的费用。你可以输入自己的价格以反映你能获得的实际报价。
进一步探索
- 在 笔记本与工作站内存推理堆栈排行榜 上比较所有系统和模型
- 在 配置页面 查看每个结果背后的完整启动命令
- 使用 GitHub 上的 AA-AgentPerf-Local 在你自己的机器上运行任何配方
阅读最新动态
[
NVIDIA 发布 Nemotron 3.5 Super VL 和 Nemotron 3.5 Bolt 74B A9B
Nvidia 的 Nemotron 3.5 Super VL 现已成为领先的美国开源权重模型,在 Artificial Analysis 智能指数中得分 26
欢迎来到具身智能时代:推出 AA-Robotics v0.1
我们正式推出 AA-Robotics v0.1,这是一项研究预览版,旨在衡量前沿语言模型在理解、规划以及在物理世界中行动方面的性能。在 v0.1 版本中,每个模型被赋予控制一个六轴机械臂(包含 5 个关节和一个夹爪)的权限,并需完成一项简单目标。今天我们将发布首批八项任务的测试结果。
Artificial Analysis 决策指数 v1.0
Artificial Analysis 决策指数对决策模型进行基准测试,这是一类新型模型,能够在单次调用中针对结构化决策为每个选项输出概率。v1.0 版本综合了四项评估,涵盖分类、工具调用、知识、幻觉和推理能力。