vLLM 集成文本水印技术:在不改变输出分布前提下实现 AI 生成内容溯源与抗篡改检测
vLLM 正式引入文本水印功能,旨在解决大模型生成内容的溯源难题。该技术通过干预生成过程而非扰动离散文本本身,在保持模型输出分布不变(非失真)的同时嵌入可检测信号,并具备抵抗编辑、截断等篡改的鲁棒性。这一更新为开发者提供了平衡安全性与生成质量的基础设施级解决方案。
报道正文
本文目录18 个章节
什么是文本溯源,为何它充满挑战?
确立数字内容的溯源对于建立我们所分享信息的信任与问责机制至关重要。水印技术提供了一种解决方案:它通过修改作品来嵌入关于该作品的信息 [1],例如其来源信息。图像和音频可以通过细微的扰动来嵌入水印,但由于文本具有离散性,这些技术并不适用于文本。我们不再试图扰动文本本身,而是以一种可检测但不改变预期输出分布的方式影响生成过程。
文本水印既是一个科学难题,也是一个工程挑战,为了实现一个实用的解决方案,我们需要平衡以下几个关键要求:
非失真性
添加水印不应改变模型的预期输出分布 [2]:它不应系统性地偏向某些词汇、写作风格或问题的解法。
鲁棒性
生成的文本可能会以多种方式被篡改:缩短、编辑、与其他语料混合,甚至由另一个 LLM 改写。一个好的水印系统旨在即使在这些修改下也能保留其溯源信号。
速度
水印应在生成和检测过程中仅增加最小的延迟和内存开销。这对于像 vLLM 这样的高吞吐量服务引擎尤为重要。在部署对调度延迟敏感的小型模型以及拥有大词汇表的模型时,性能下降尤为明显。
最小化检测依赖
对文本进行水印检测应尽可能少地依赖额外信息:试图确定某段文字来源的用户,可能并不具备关于其起源的额外信息,例如创建日期或用于生成它的语言模型类型。
这些期望的特性往往相互制约:易于检测的强信号可能需要显著改变模型的输出,而避免依赖额外信息则限制了我们可用的算法范围。
例如:
- 附加在文件上的元数据可以被剥离,且在将数据复制到新文件时不会保留。
- 红绿列表 [3] 和直接数据水印化可能导致输出分布的失真。
- Unicode 替换容易被移除和篡改。
- 文本建模技术(例如观察句子长度、异常词汇和表达)不可靠。
- 锦标赛采样 [2] 需要多轮处理,若在不影响推理速度的前提下高效实现则较为困难。
为了满足这些标准,我们利用了语言模型生成过程中的一个自然属性:随机性。
利用 LLM 中的随机性
在每个生成步骤中,语言模型会为每个可能的下一个 token 分配一个概率,然后从中采样一个。这一过程在可能延续路径构成的树状结构中追踪出一条路径:其中一些路径比其他路径更有可能出现,但许多路径都是有效的最终输出。
普通的随机采样会在每一步绘制并丢弃新的随机值。而水印化技术则从最近的上下文和每个候选 token 中派生出可复现的密钥值。由于上下文和选定的 token 仍保留在输出中,拥有密钥的检测器可以在生成后重建这些值。带水印的文本会系统性地与这些值对齐,从而在足够长的序列上累积形成信号。
下一节将讨论如何在保持模型初始采样分布的前提下实现这一过程,从而有效地允许我们可复现地选择模型的可能最终输出之一。
Gumbel-max Trick
Gumbel-max trick 是一种从类别分布中进行采样的技术。假设模型为每个候选 token 分配了一个概率 :对于每个 token,我们抽取独立的均匀随机变量 ,并将其转换为 Gumbel 随机变量:
采样的 token 随后为:
这一变换的一个显著结果是:
换言之,向 token 的对数概率添加 Gumbel 噪声并取其 argmax,会产生与普通随机采样完全相同的类别分布:事实上,Model Runner v2 的标准采样路径已经使用了这一过程。在实践中,我们可以直接将 Gumbel 噪声应用于 logits,从而避免 softmax 计算并使计算更具并行性。
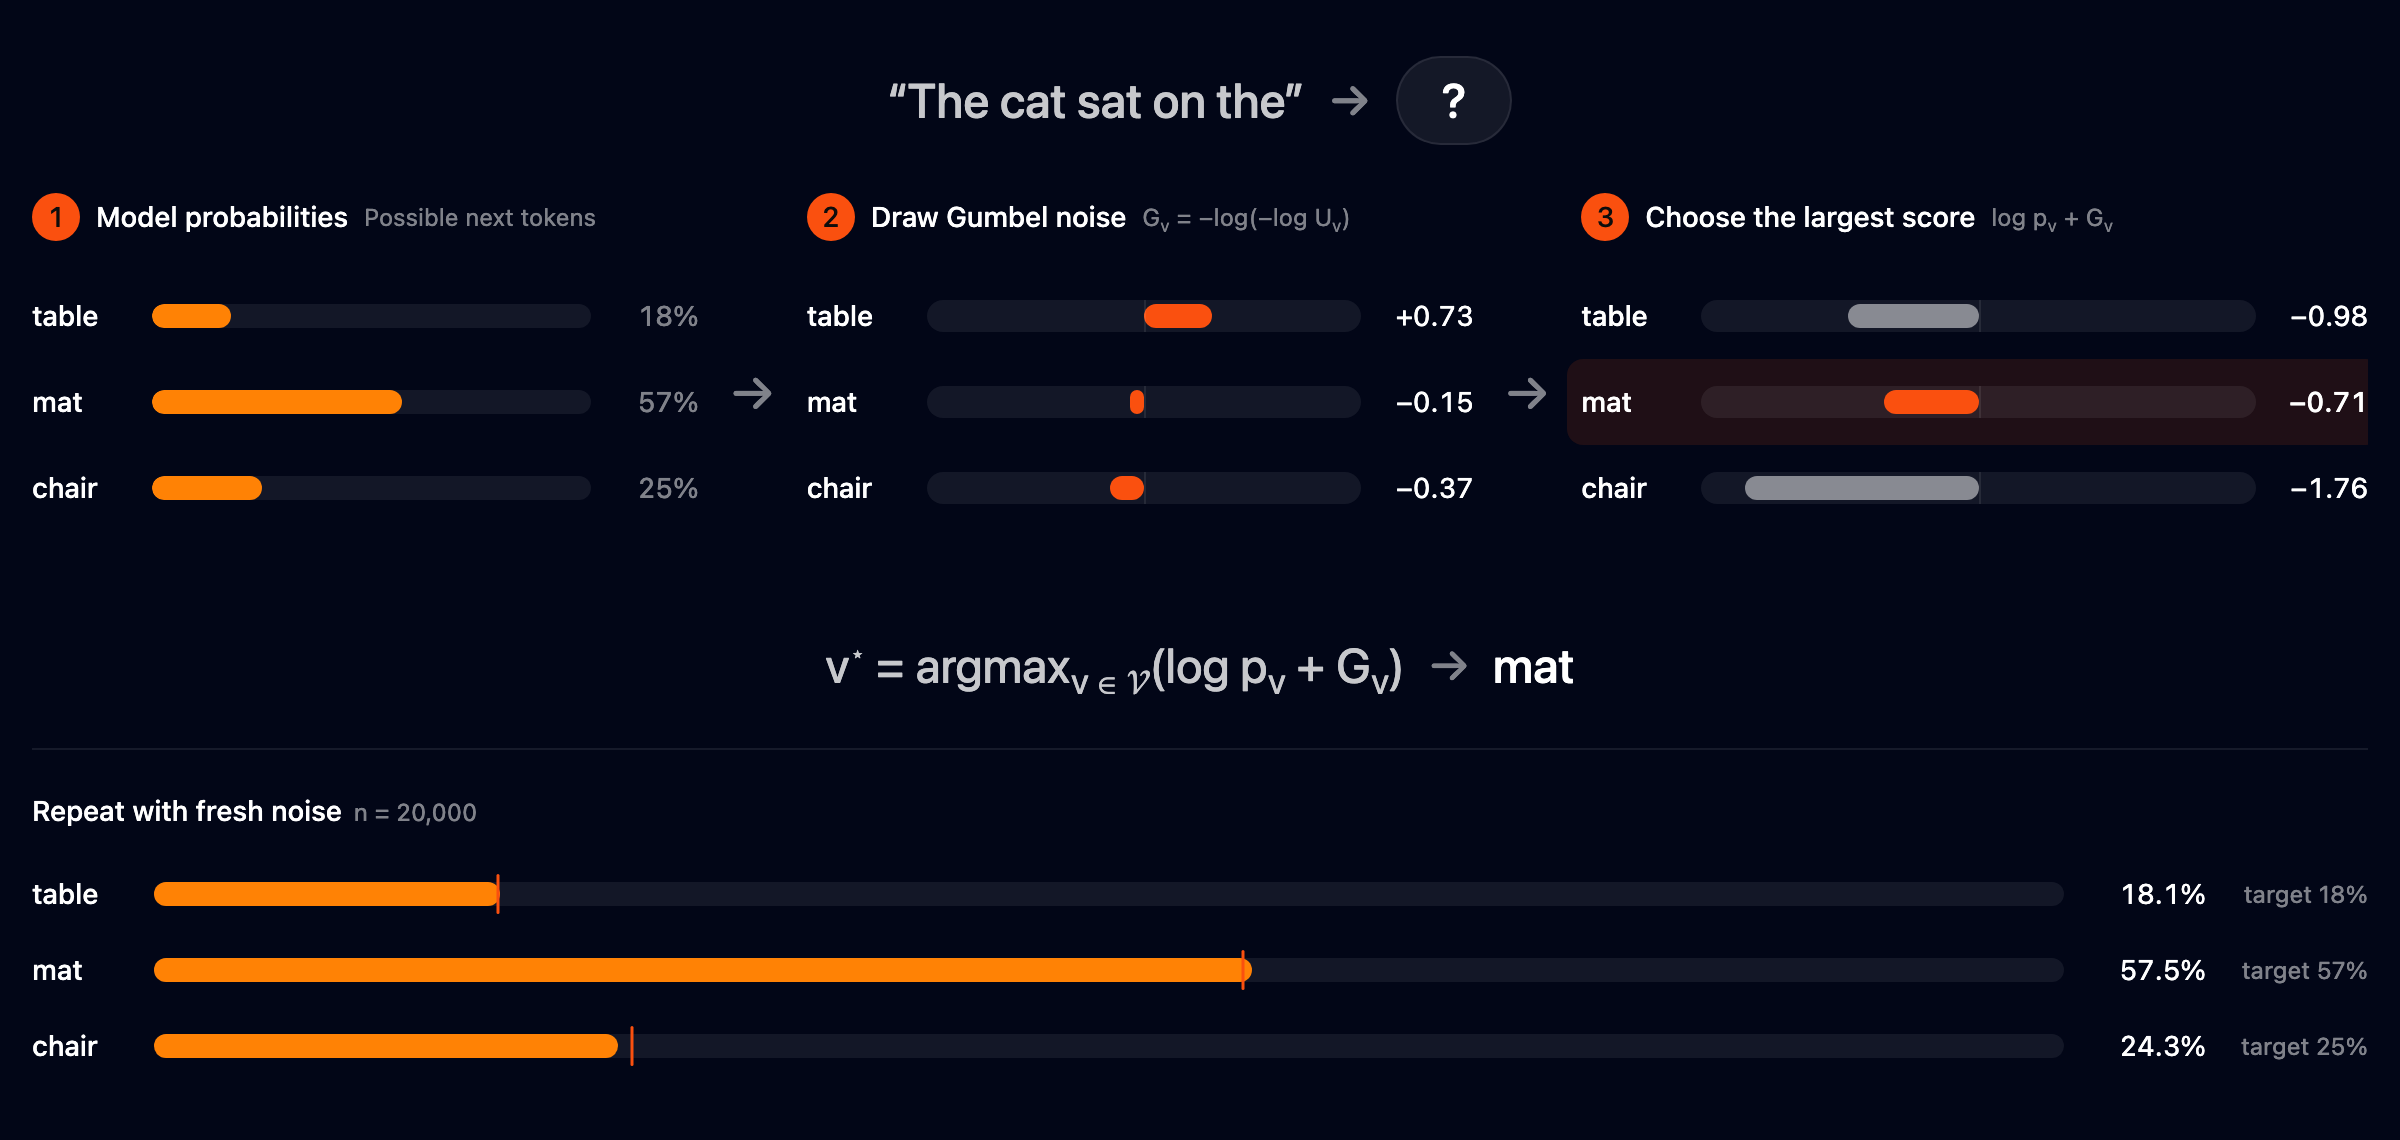
Gumbel-max 采样示例:table、mat 和 chair 的模型概率与 Gumbel 噪声相结合。“mat”在一次抽样中胜出,而重复 20,000 次后接近恢复原始的 18%、57% 和 25% 分布。
为了使这些随机抽样可复现,我们使用伪随机函数(PRF)[4]。PRF 将密钥和输入确定性地映射为一个表现得像均匀随机抽样的值:由于相同的输入总是产生相同的输出,检测器可以重建生成期间使用的值。我们将每个独立的均匀随机抽样替换为:
其中是秘密水印密钥,是最近的水印上下文(最近的 tokens)。
包含 token ID 很重要,因为它允许每个 token 接收不同的噪声;最近的上下文(默认情况下,我们使用最后 4 个 tokens)意味着我们应用的随机噪声在几乎每一个生成步骤都是不同的;而秘密密钥使得这种模式对于没有该密钥的人来说是不可预测的。
生成器为每个候选 token 计算这些带密钥的值,并选择具有最大加噪对数概率的 token。给定相同的密钥和上下文,这一选择是可以复现的,但在没有密钥的情况下,它看起来就像普通的随机样本。
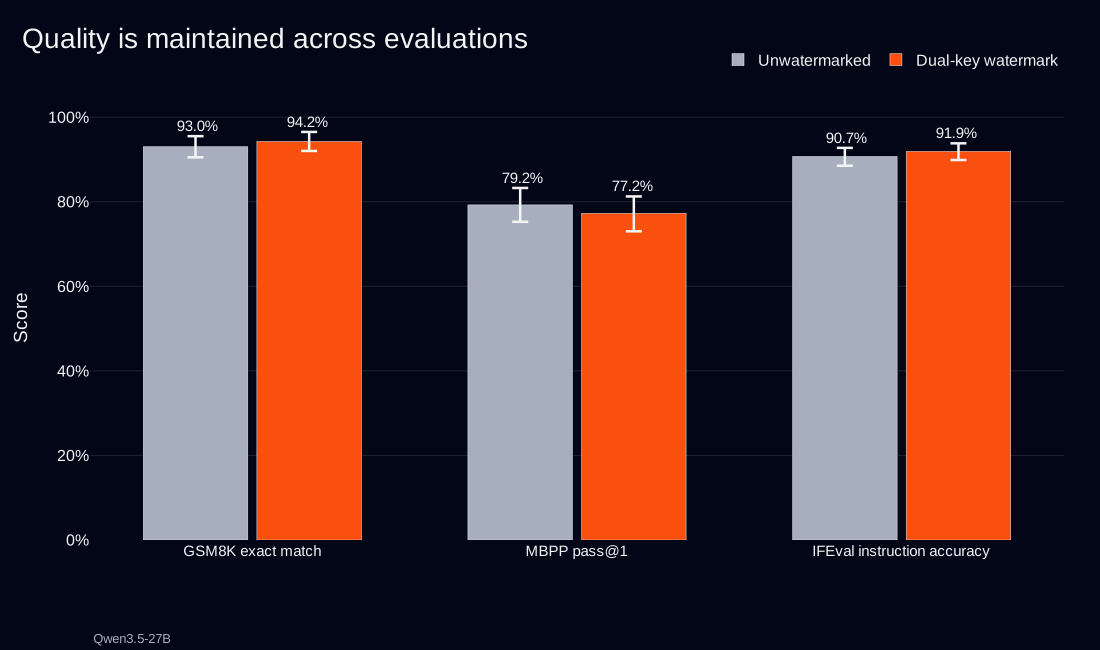
比较 Qwen3.5-27B 在启用与禁用双密钥水印时的质量柱状图:GSM8K 为 93.0% 对比 94.2%,MBPP 为 79.2% 对比 77.2%,IFEval 为 90.7% 对比 91.9%,误差条存在重叠。
这为该算法提供了精确的无失真保证:在密钥的期望意义上,选择某个 token 的概率保持完全不变。然而,仅凭这一点并不能保证完整序列是无失真的。我们在“维持输出多样性”一节中进一步讨论这一局限性及其解决方案。
检测水印
在检测阶段,我们逆转生成过程中使用的流程。它不需要访问模型的权重或 logits,但需要知道秘密密钥和分词器(tokenizer)。
用户将向检测器提供一段来源未知的文本序列。该检测器会将文本序列转换回 token ID。对于每个 token ,检测器利用其前文上下文和秘密密钥重新计算其伪随机值:
对于未加水印的文本,观察到的 token 与其密钥化值相互独立,因此其行为类似于均匀分布的随机变量。而加水印的生成结果则会倾向于选择具有较大值的 token。我们将每个值转换为一个 token 级别的分数:
由于重复的上下文会重现相同的密钥化值,检测器对每个上下文只评分一次。如果文本未加水印,这些分数服从均值为 的指数分布。它们的总和,
因此服从形状参数为 、尺度参数为 的 Gamma 分布。这使我们能够计算单侧 p 值:即未加水印文本产生至少与 一样大的分数的概率。较小的 p 值表明该文本与水印花纹一致。
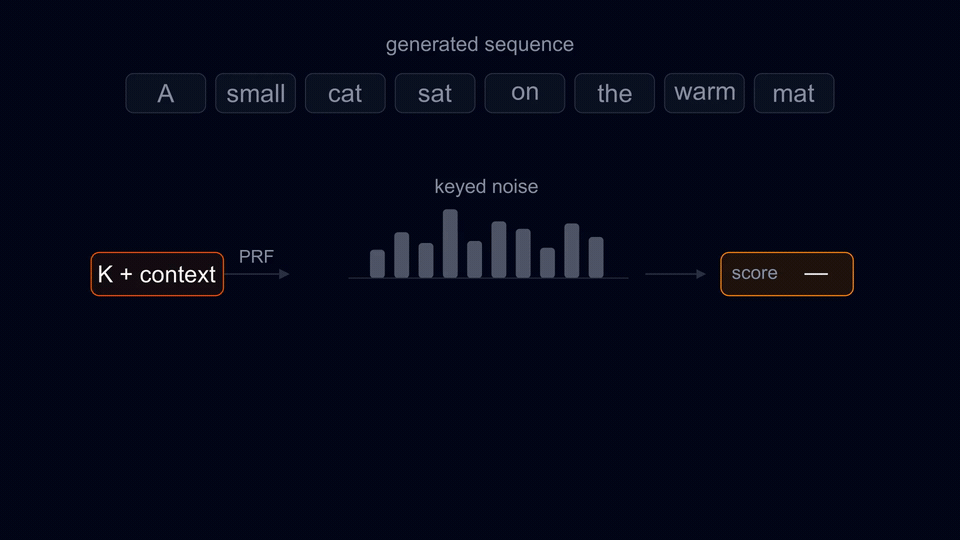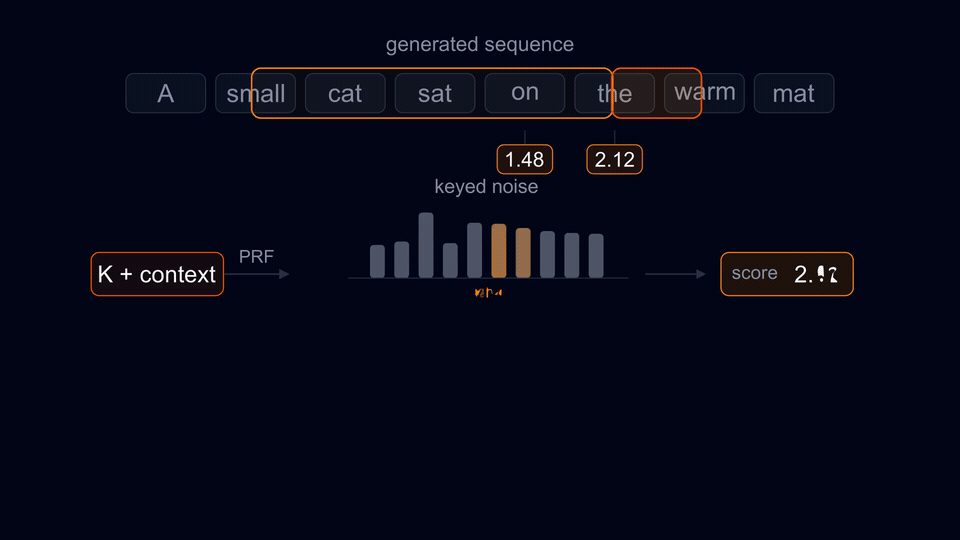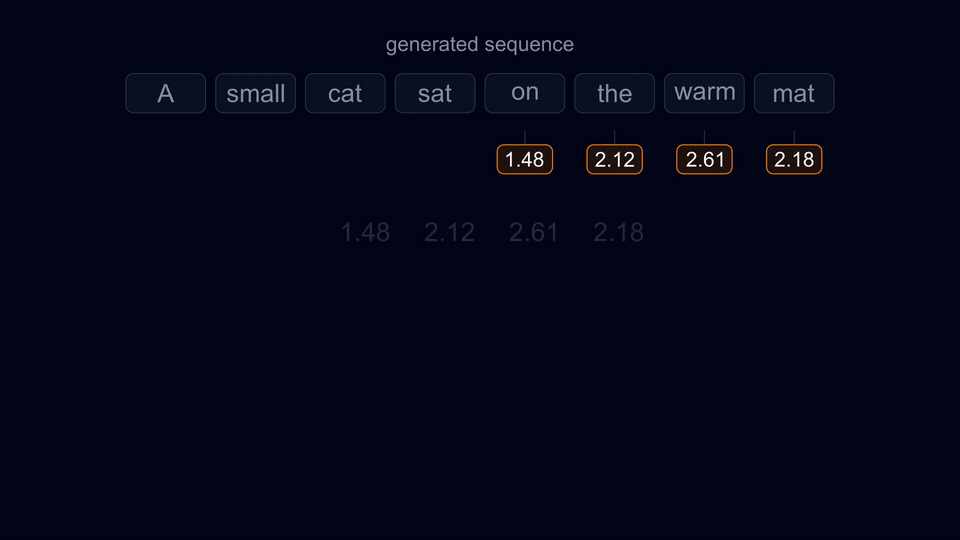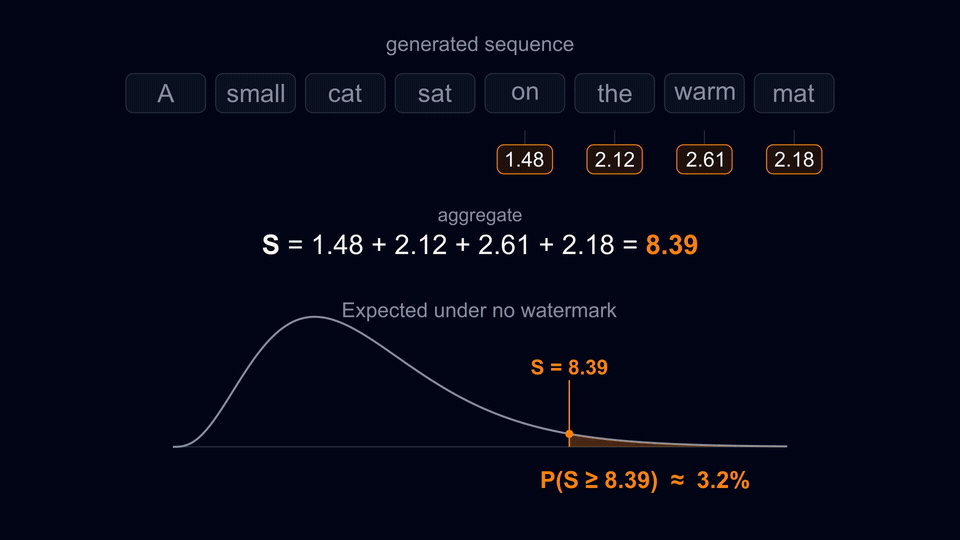
水印检测动画演示:每个 token 的密钥和前文上下文重建出密钥化噪声,进而转化为 token 分数。将这些分数求和后,与未加水印的 Gamma 分布进行比较以获取 p 值。
选择阈值需要在假阳性与假阴性之间进行权衡。对于经过校准的检测方法,大约会将 1% 的未加水印序列标记为阳性。在实际应用中,我们可能还会针对多个密钥、分词器或水印配置进行测试。这会增加偶然发现高分值的概率,因此我们需要应用多重检验校正。随着候选项数量的增加,阈值会降低,检测能力也随之下降。
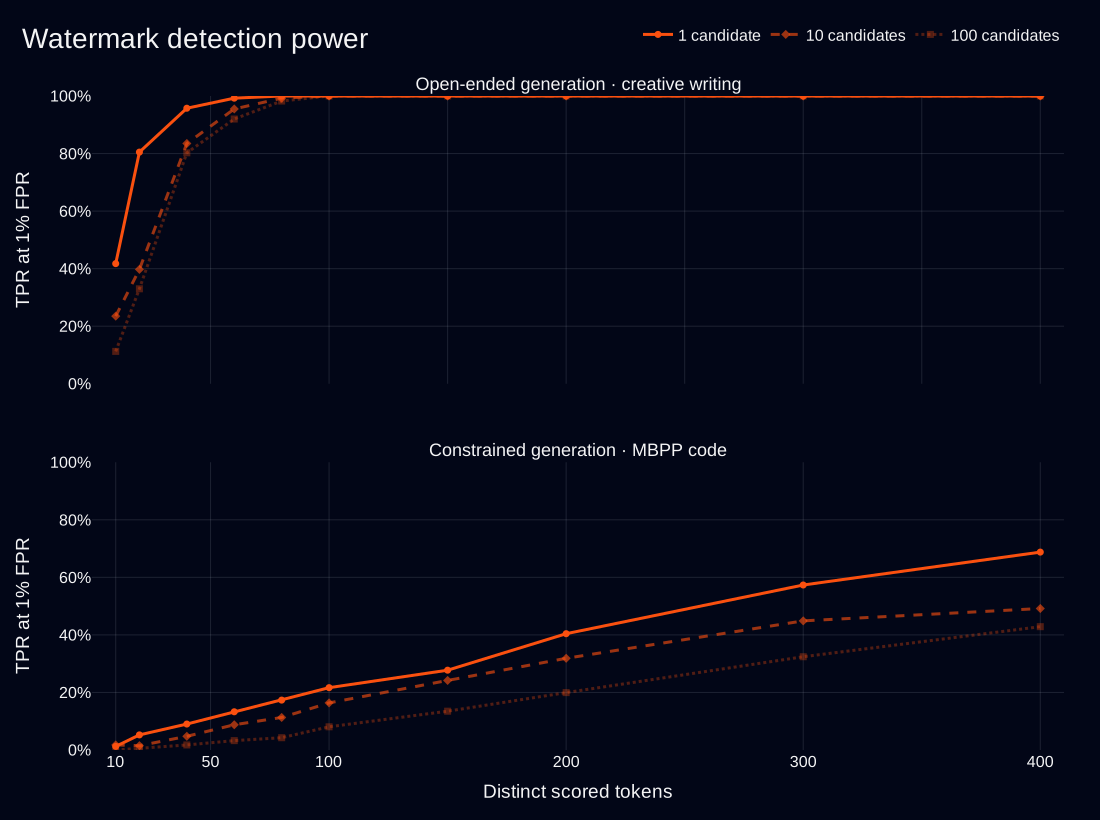
在 1% 假阳性率下,针对 1、10 和 100 次候选测试的水印检测能力与不同计分 token 数量的关系。创意写作类文本在约 100 个 token 时接近 100% 的真阳性率;MBPP 数据集上升较慢,在 400 个 token 时分别达到约 69%、49% 和 43%。
随着独立证据的积累,检测能力会增强:更长的输出提供了更多可供计分的 token,而高熵步骤则让水印有更多机会影响 token 的选择。因此,较短或可预测性较高的输出提供的信号较少。
由于信号编码在 token 选择本身之中,复制粘贴足够长的段落将保留其证据。修改文本会扰乱被修改 token 附近的分数,但一旦这些 token 不再处于后续 token 的近期上下文中,信号便会恢复完整。
vLLM 中的实现方式
该实现最初在 watermarking RFC 中提出,其中强调水印必须与最终 token 采样及推测解码(speculative decoding)集成。因此,我们将其直接集成到 Model Runner v2 的采样流水线中。初始实现(PR #54053) 将 GPUWatermarkSampler 连接到特定算法的 Watermarker,使得不同的方案可以共享相同的请求和批次处理逻辑。
朴素的实现方式会实例化一个 [batch, vocabulary] 形状的噪声张量,从而产生大量的临时存储和内存流量。vLLM 转而将伪随机数生成、Gumbel 变换以及 argmax 归约融合到单个 GPU 内核中。Philox 算法每次调用可生成四个值,使得该内核能够同时处理四个连续的 token ID。
通过逐行掩码(per-row mask),同一个融合采样器可以对带水印的请求使用密钥化噪声,而对不带水印的请求或重复上下文则使用普通随机性。
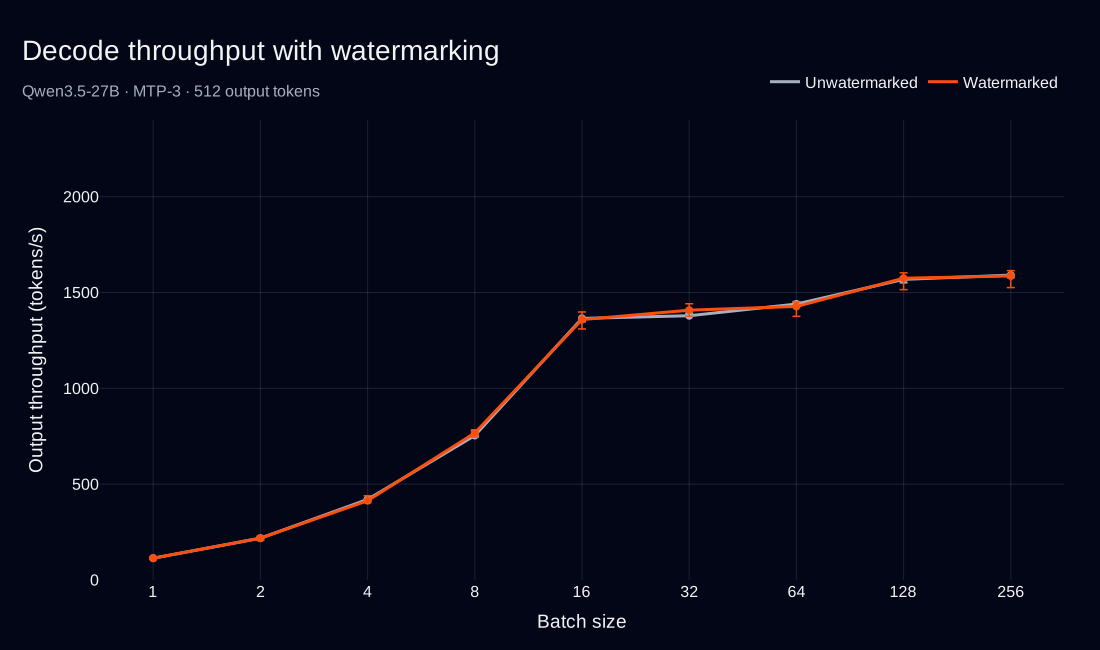
Qwen3.5-27B 模型在启用 MTP-3 的情况下,不同批量大小(1–256)下的解码吞吐量。在整个范围内,带水印与不带水印的曲线高度重合,表明没有一致的吞吐量变化。
在八个密钥下,匹配吞吐量的平均变化范围在 −1.1% 到 +2.0% 之间(涵盖不同批量大小),未出现显著的性能下降。
挑战
水印技术存在一些重大挑战,需要特别有趣的解决方案。我们将讨论其中两个最重要的问题:与推测解码(speculative decoding)的交互作用,以及输出多样性的降低。
推测解码
推测解码从草稿分布中提议 token,并依据目标分布对其进行接受。对两个分布应用相同的水印可以分别保持它们各自的特性,但可能会减少它们的交集并降低接受率。vLLM 转而采用 双密钥实现(PR #56122):使用一个密钥用于被接受的草稿 token,而另一个密钥用于目标残差和奖励 token。分离密钥保持了正常的接受率,并使目标采样独立于被拒绝的草稿提议。
最终文本将包含由其中一个或另一个密钥进行水印标记的 token,因此我们在评分时必须使用这两个密钥并组合它们的分数。不幸的是,这会稀释来自两个密钥的信号,导致检测信号减弱。
这种加权可以进行校准,以反映每个 token 的预期来源及其携带的信号强度。例如,当草稿 token “容易”且熵较低时,它们更可能被接受,这意味着它们携带的水印信号较少。
维持输出多样性
单 token 无失真仅保证每个生成步骤的分布不变,而非整个序列的分布。如果上下文重复出现,其对应的密钥噪声也会重复,从而导致本应由普通采样独立决定的 token 选择产生相关性(见下方示例)。单序列无失真则是一种更强的保证,确保完整序列上的分布同样保持不变。
例如,假设一个固定密钥使模型生成以下序列:
1 + 1 +       -> 1   context: (1, +, 1, +)
1 + 1 + 1     -> +   context: (+, 1, +, 1)
1 + 1 + 1 +   -> 1   context: (1, +, 1, +)
在再次生成 1 后,上下文 (1, +, 1, +) 发生了重复。因此,固定密钥会产生与之前相同的伪随机值,这些值此前倾向于生成 1。如果模型的概率分布也相似,或者偏置足够强,它很可能再次选择 1:在这种情况下,生成过程可能会陷入无限重复循环。
1 + 1 + 1 + 1 + 1 + (...)这是最坏的情况,但这种跨上下文的关联通常会导致序列内多样性降低、退化行为发生率增加、生成长度变长以及输出质量下降。
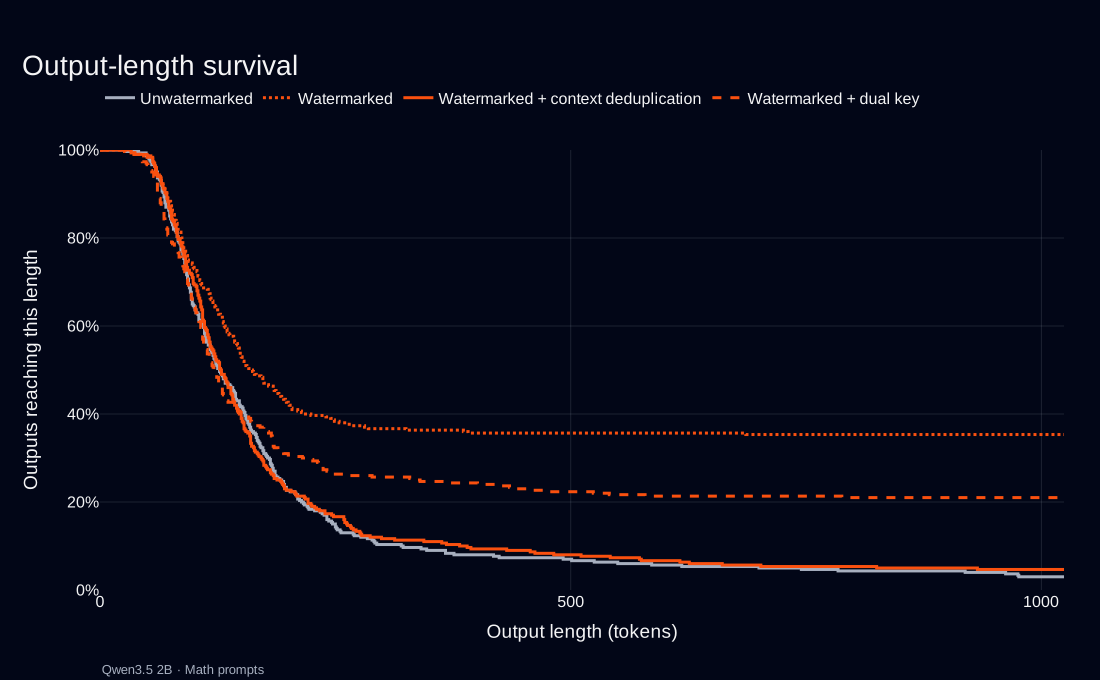
Qwen3.5-2B 数学提示词下的输出长度存活率:普通水印会产生许多被截断的长输出,双密钥减少了这种超额现象,而上下文去重则实现了与未加水印解码相匹配的效果。
vLLM 通过 生成时上下文去重(PR #56233) 解决了这一问题,该功能在上下文重复时跳过水印处理,从而保持单序列无失真。尽管它在每一步都检查之前的生成内容以发现重复上下文,但在 Qwen3.5-27B 上,端到端吞吐量最多仅降低了 0.19%。
我们还可以利用前文讨论过的双密钥水印方案,因为 token 是来自目标分布还是草稿分布的随机性可以缓解这种不良行为的影响,并提升序列之间的多样性。更一般地,我们可以在不使用推测解码的情况下采用双密钥路由 [5],通过在生成过程中随机选择使用哪个密钥来实现。
入门指南
你可以在启动 vLLM 服务器时启用 Gumbel-max 水印:
vllm serve mistralai/Mistral-7B-Instruct-v0.3 \
  --watermark-config '{"algorithm":"gumbel","key":42}'
vLLM 还提供了一个 最小化 HTTP 检测服务器示例,用于使用匹配的 tokenizer 和水印密钥检查文本。有关配置和检测示例,请参阅 水印文档。
结论
vLLM 现已支持使用 Gumbel-max 算法进行无失真水印,具备高效的 GPU 生成能力和推测解码支持。我们的评估显示,在保持输出质量和多样性的同时,性能开销极小。
致谢
感谢 Wassim Bouaziz、Andy Lo、Nicolò Lucchesi、Victor Paltz、Leila Saidi 和 Mickaël Seznec 对本文进行的细致审阅和反馈,以及 Lucas Wilkinson 在实现和审阅方面做出的贡献。
附录
吞吐量测量
测量使用 Qwen3.5-27B 模型,在单张 H100 GPU 上运行,采用 MTP-3 和 512 个输出 token。吞吐量值为八个带水印密钥的中位数,以及四个不带水印对照实验的中位数。
| Batch size | Unwatermarked median (tok/s) | Watermarked median (tok/s) | Mean matched change | 95% CI |
|---|---|---|---|---|
| 1 | 113.9 | 113.9 | −0.23% | [−1.00%, +0.53%] |
| 2 | 218.2 | 218.5 | −0.30% | [−2.87%, +1.08%] |
| 4 | 420.5 | 413.7 | −1.11% | [−2.36%, +0.14%] |
| 8 | 753.9 | 767.3 | +0.77% | [−0.99%, +2.72%] |
| 16 | 1364.8 | 1358.7 | +0.02% | [−1.06%, +1.61%] |
| 32 | 1378.8 | 1407.9 | +2.03% | [+0.59%, +3.46%] |
| 64 | 1439.9 | 1427.3 | −1.10% | [−2.59%, +0.77%] |
| 128 | 1568.5 | 1574.5 | +0.36% | [−1.14%, +2.04%] |
| 256 | 1590.7 | 1586.5 | −0.58% | [−1.92%, +0.77%] |
References
-
Ingemar J. Cox, Matthew L. Miller, Jeffrey A. Bloom, Jessica Fridrich, and Ton Kalker. “Digital Watermarking and Steganography.” 第 2 版,Morgan Kaufmann (2008)。
-
Sumanth Dathathri et al. “Scalable watermarking for identifying large language model outputs.” Nature 634, 818–823 (2024)。补充信息,§G.3。
-
John Kirchenbauer, Jonas Geiping, Yuxin Wen, Jonathan Katz, Ian Miers, and Tom Goldstein. “A Watermark for Large Language Models.” Proceedings of the 40th International Conference on Machine Learning (2023)。
-
Scott Aaronson and Hendrik Kirchner. “Watermarking GPT outputs,” 2023。
-
Tom Sander et al. “TextSeal: A Localized LLM Watermark for Provenance & Distillation Protection.” arXiv.12456 (2026)。