AI 重塑科研:从代码生成到实验导航
Anthropic 等机构正推动 AI 深入生物湿实验室,但更即时的变革在于利用 LLM 降低科研成本。文章提出“铸造厂”与“导航者”概念,指出 AI 在可验证的软件工程中已大幅提效,而在科学领域则通过优化实验设计与数据复现来加速发现。核心观点是 AI 并非直接替代科学家,而是作为基础设施降低探索门槛并提升研究的可重复性。
报道正文
本文目录4 个章节
在 AI 时代,科学的未来将呈现何种面貌?Anthropic 为科学设定了宏大的目标,甚至正在开设湿实验室。与此同时,一场静悄悄的变革1正在整个“AI x 科学”领域发生。
在这篇客座文章中,Adrian Sanborn 探讨了他在自己的公司 Endura Therapeutics 中观察到的那些不那么引人注目、但更为立竿见影的 AI 变革方式,这些变革正深刻影响着前线科学研究。
Adrian 在斯坦福大学完成了计算机科学博士学位,期间大部分时间都在实验台旁开展研究,这使他成为少数能够同时阐释 LLM 如何改变代码库以及如何改变湿实验室的人之一。请欣赏!
语言模型已经彻底改变了软件构建的方式。编写代码、处理数据以及架构系统如今的速度之快,是三年前难以想象的。
当产品是软件且结果可验证时,更廉价的编码直接转化为更多的软件和更多的开发者。2 但在科学领域,一切最终都受制于需要数天或数周才能验证结果的物理实验。围绕实验的知识工作已变得显著加速,而 AI 对实验本身吞吐量(throughput)的提升却微乎其微。思考变廉价了,但行动没有。
我们认为生物技术行业以两种方式进行了适应:
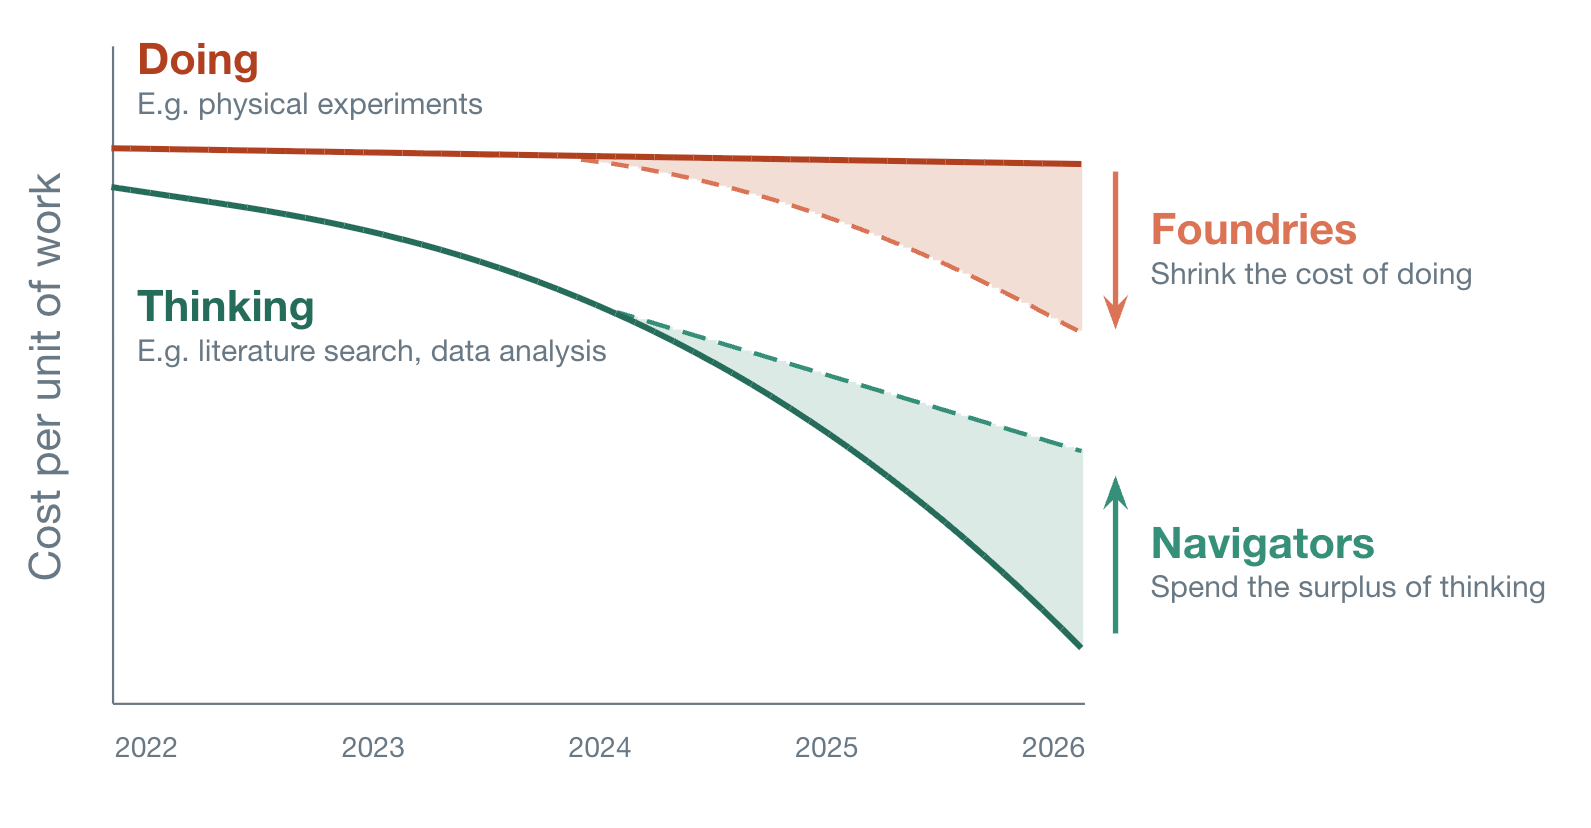
- Foundries(铸造厂)压缩了执行成本。 它们将测量过程工业化,利用新技术以比过去快一个数量级的速度生成数据。Xaira、NewLimit、Octant、Tahoe 和 Endura 通过下一代测序和多路复用技术实现这一点;Insitro、Eikon 和 Noetik 采用高通量显微镜;Lila 和 Periodic Labs 则依靠物理自动化——这仅仅是其中几个例子。AI 使这些数据变得可读且具有预测性,但真正的差异化资产是实验数据本身。
- Navigators(导航者)消耗思维盈余。 AI 模型嵌入公司的常规运营机制中,推动更优的决策和更快的流程。它们日益主导工作执行方式、工具构建方向以及哪些值得进行实验的问题。无需专有模型或海量数据集,只需愿意演进公司的工作方式即可。
建立 Foundry 是一项真正的战略承诺,需要资本、数年时间以及对特定技术的押注。Foundry 显而易见:其技术令人瞩目,与 AI 的联系直接明了,且总有新模型或数据集可供发布。相比之下,Navigator 往往隐形,因为其收益体现在运营层面,没人会为放弃某条路径而发布新闻稿。但“导航”能力对所有公司开放。显著的变革发生在少数几十家公司身上,而隐性的变革则正在所有公司中发生。
在早期初创公司中,“导航”跑得最快,因为它们没有历史包袱:没有遗留的软件合同、标准化流程、僵化的组织结构或合规体系。它们也面临着用极少资源快速行动的压力。当一种更好的工作方式出现时,它便自然而然地成为新常态。
这种影响无处不在。当分析耗时从一周缩短至一小时,实验迭代速度显著提升。原本需花费六位数授权费的软件类别,如今一天内即可自建完成。疾病项目可从 500 个候选方案中筛选,而在以往团队通常只能评估五个。以下是内部视角下的具体表现。
代码现在能跟上科学发展的步伐
实验科学中存在一种结构性的张力,这在软件工程中并没有真正的对应物。在工程领域,需求每隔几周就发生变化是规划不善的症状;而在研究中,这恰恰是目标所在。实验的目的是获取新知,而这种认知会改变下一个实验的方向3。如果一种方法在六个月内没有演进,那就意味着没有任何新发现。
一个新实验的方案在第一年内可能会演变十几次,而每一次变更都会传导至分析环节。每一项测量数据都需要通过紧密追踪实验进度的代码进行处理、归一化和解读。历史上,这种分析工作通常由第二个人完成,从而在“理解实验测量内容的人”与“理解代码逻辑的人”之间形成了一道隔阂。正是这种摩擦导致人们倾向于减少实验方案的变更以避免返工,进而使得许多潜在选项未被探索。
如今编写代码的速度极快,将分析流程适配到修改后的方案只需一下午的工作量,而非一个项目。实验不再受制于更改分析管线的沉重负担。 当灵活性变得廉价且问题易于修复时,实验就可以采用敏捷模式;换言之,科学界终于可以践行“快速行动,打破常规”(move fast and break things)的理念了。
同样的转变也向上延伸一层,影响到结果解读。现在构建一个交互式可视化仪表盘只需几分钟,而过去则需要数天。
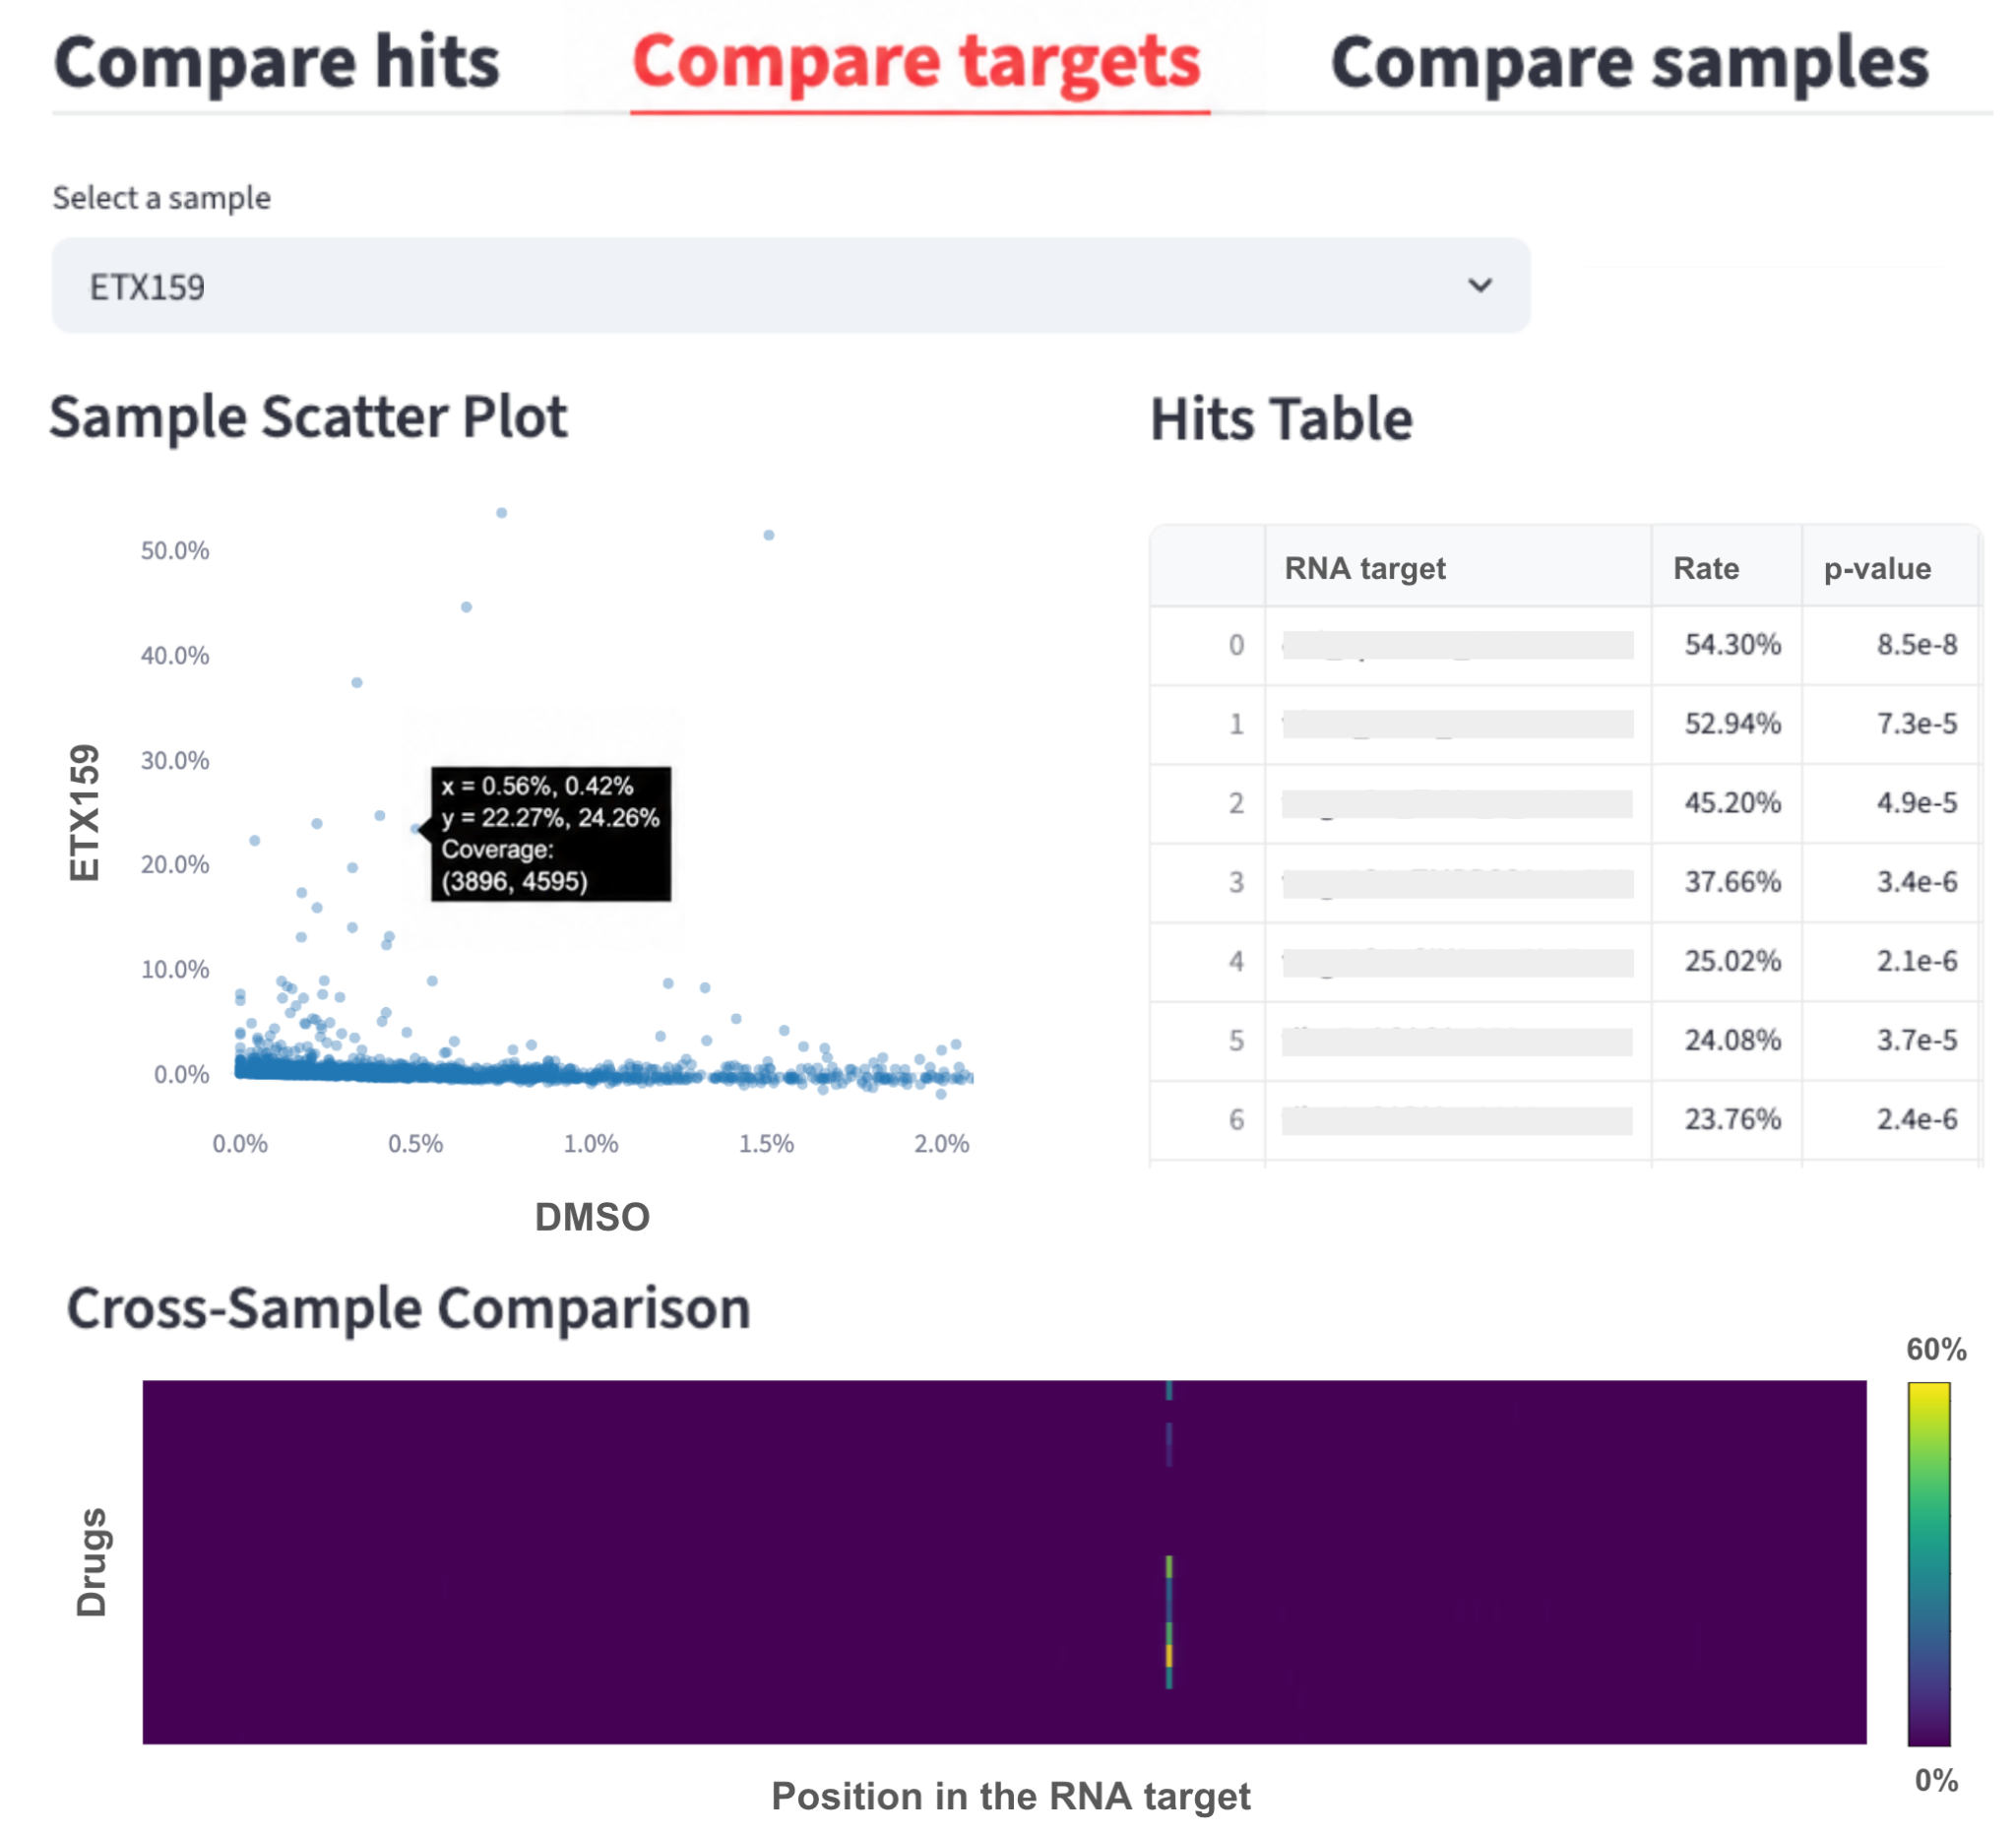 Endura Therapeutics 内部的一个仪表盘,仅用几小时便搭建完成。
最显而易见的后果是访问权限的变化。过去,由于每个实验都由计算人员进行分析,结果往往需要排队等待处理。现在,执行实验并掌握背景信息的科学家可以直接展示他们自己的结果。数据不再被锁在别人的 Python notebook 之后。
软件现在可以表达你的观点
每个软件界面都带有某种“观点”。数据系统决定了哪些对比分析只需一键即可获取,而哪些则需要费力搜寻。每个实验室都需要一个地方来存储和展示其数据,而嵌入在该系统中的这种“观点”,最终会塑造该实验室所关注的内容。
过去二十年里,这种“观点”由他人形成:少数几家构建作为记录系统(system of record)的实验室软件的供应商。这些供应商为成千上万个实验室构建同一套系统,因此必然朝着最小公分母进行设计。所有人都接受了这种近似方案,因为开发自有系统的成本超出了任何实验室所能证明其合理性的范围。
如今情况已不再如此。内部构建的数据门户能够容纳那些商业产品未曾预料到的数据特性,其复杂度恰好满足团队需求,并随着他们提出的问题而演进。浏览和探索变得简单且毫不费力,这改变了人们的行为方式。试想一下,如果查看下一条帖子需要切换标签页并复制粘贴,还有谁会在社交媒体上花费那么多时间?那些一直分散在不同幻灯片中的模式开始浮现出来。
实施仅需一天,但决定门户应具备什么功能可能需要数周。事实证明,这些设计讨论至关重要,因为决定哪些内容应呈现在单一屏幕上,迫使团队明确阐述哪些对比分析真正驱动了其决策。当你购买一个软件平台时,你外包的不仅是工程实现,更是关于如何达成目标这一问题的思考。
当然也有权衡取舍:内部门户往往不够精致,也没有可供呼叫的支持团队。对于拥有层层验证要求和合同义务的大型组织而言,效仿此路径仍将面临困难。但软件公司早已明白,最好的内部工具源自与使用者并肩工作的工程师。现在,每个研究团队都可以成为自己的前沿部署工程师(forward-deployed engineer)。
旧规则是“能买则不建”。新规则则是 构建那些塑造你思维方式的工具。
专家级深度现已具备可扩展性
选择攻克哪些疾病,是制药公司做出的最具决定性的决策。后续的一切工作都源于这一决策,并需适应特定疾病的生物学机制及其市场特征。该选择实际上不可逆转,因为单一成功项目大约需要十年时间和十亿美元投入,因此必须经过审慎的尽职调查。典型流程会召集一组内部及外部专家,花费一个月或更长时间收集、综合并辩论科学与市场证据。
我们构建了一个两阶段分诊系统,并部署了一支 LLM 研究智能体团队来处理它。第一轮筛选覆盖了约 500 个疾病靶点,为每个靶点生成了相当于三页报告的摘要,并基于基础问题进行过滤:疾病患病率是否足以证明我们的努力合理?现有药物是否已解决该问题?我们药物的靶点降低效应是否真能缓解疾病?第二轮针对剩余的大约 100 个疾病靶点,生成了每份相当于三十页的报告,深入剖析疾病生物学和竞争格局。我们将第二轮提示词设计为表现得像一位持怀疑态度的专家,而非简单的总结者:列出失败的项目、分析每个项目失败的原因,以及明确我们需要满足什么条件才能在他们失败的地方取得成功。这种细节程度至关重要,因为在任何市场中,明显优质的靶点往往竞争激烈。要确立一个可辩护的定位,意味着找到特定的疾病,并阐明我们的药物为何能做到现有方法无法做到的事情。

按照以往的速度,第一阶段大约需要一个人年的阅读量,而第二阶段则接近一个世纪的专家时间。第二轮结果仍会与一手资料进行核对,且选定的项目依然会接受完整的人工尽职调查。6 但如此广泛且深入的搜索,在一年前根本不可能实现。
在科研领域,代价高昂的错误往往是那些未知的错误。一个团队选定了一个方向,几个月后实验结果呈阴性时才发现走错了路。通常,一位专家只需一句话就能指出这一点:那条通路已经被尝试过,这个读数从未预测出任何结果,那家公司在那类患者群体上遭遇了挫折。这种规模化的专家级深度洞察之所以能改变游戏规则,正是因为尽早被告知“此路不通”在科研中极具价值。
这只是浅水区
上述所有情况都发生在 Endura——灵活动态的分析、一天内构建的内部工具、跨越 500 种疾病的搜索——而这仅仅是导航功能的入门版本。每一代语言模型的迭代都在消除我们曾视为理所当然的限制。很快,我们将完全无需构建分析流程或数据仪表盘。取而代之的是,科学家提出她真正关心的问题,而回答该问题所需的分析和界面将从零开始即时组装。软件不再是一种工作成果,而是围绕问题浮现出来的产物。7
这种规模的专家知识获取能力开启了以往无人敢尝试的工作。一个明确的例子是药物重定位(drug repurposing),即一种已被证明对人体安全的药物,被发现作用于此前无人关注的疾病机制。已发表的文献浩如烟海,其中某些有用的结论此刻正沉睡其中,未被发现,因为没有任何单个人阅读过正确的论文组合。但模型可以消化所有这些内容,并在恰当提示下建立关联。整个生态系统正在围绕这一赌注形成,制药公司和投资者也在运行他们自己的版本。8 尚待观察的是,这究竟会催生三种新药还是三百种。
这些“导航者”的存在证明,当前在科学领域加速最快的 AI 并非基于科学数据训练的模型,而是那些能帮助科学家或高管在每个周一上午厘清工作优先级的工具。
Adrian Sanborn 是 Endura Therapeutics 的首席执行官兼联合创始人。他曾是 Atomic AI 的创始成员,负责领导该技术平台的生物学部分并制定公司的治疗策略。他在斯坦福大学获得计算机科学博士学位,期间大部分时间都在 Roger Kornberg 的生物化学实验室中从事实验工作。他在 X 上的账号是 @AdrianSanborn。
衷心感谢 Brandon Anderson、swyx 和 Lauren Richardson 审阅本文草稿并提供关键反馈。
在本文打磨期间,这篇论文发布了,其中探讨了 AI 与科学交叉领域的早期洞察。我们很高兴看到,我们的许多观点得到了实证观察的支持!
这就是杰文斯悖论(Jevons paradox),得名于 1865 年的观察:更高效的蒸汽机反而增加了煤炭消耗,而非减少。软件行业的版本是:编写代码成本的每一次下降,随后都伴随着更多软件的诞生,而不是工程师数量的减少。
实际上,软件产品开发也有强调学习并借用“实验”一词的工作流程。产品团队运行 A/B 测试,通过功能标志(feature flags)发布功能,并将每次发布视为关于用户需求的一个假设。
大多数基因药物(如 CRISPR)是大分子,无法自行进入细胞。它们只能到达少数组织,而将其送达这些部位需要静脉输注、注射,或者对于大脑而言,需要将针头插入脊髓管。小分子药物以药片形式存在,可以自行在体内传输并可口服服用。当罗氏(Roche)推出一种治疗脊髓性肌萎缩症的口服药物时,家庭纷纷从已经有效的注射药物转向了这种口服药。
大多数公司有充分的理由首先确定治疗领域,这由其现有的科学专长、临床关系和业务优先级决定。我们的方法允许我们先广泛探索以找到最具生产力的方向,然后再在此基础上构建深度。
语言模型并不完美,在这个规模下,一些报告包含错误。这是可以容忍的,因为初筛中的错误仅意味着错失机会,而不是浪费时间追逐一个糟糕的想法。
按需生成的分析存在一个未解决的问题:可复现性。如果图表背后的代码是为某个特定问题临时组装的,其来源的可信度就弱于经过版本控制的流水线。
例如,Edison Scientific 就是基于这一前提构建的,Metsera 背后的团队也使用了其 AI Scientist 系统来生成新的公司创意。