OpenAI 发布 GPT-6.1 Terra 智能提升成本降至三分之一
OpenAI 推出新一代 Terra 级模型 GPT-6.1,在 Artificial Analysis 智能指数中较前代提升 6-13 分,但单次任务成本降至不足三分之一。该模型在低中强度推理下实现帕累托最优,并显著刷新编码代理基准测试成绩,确立了新的性价比标杆。
报道正文
Artificial Analysis (@ArtificialAnlys) · 2026-10-26 18
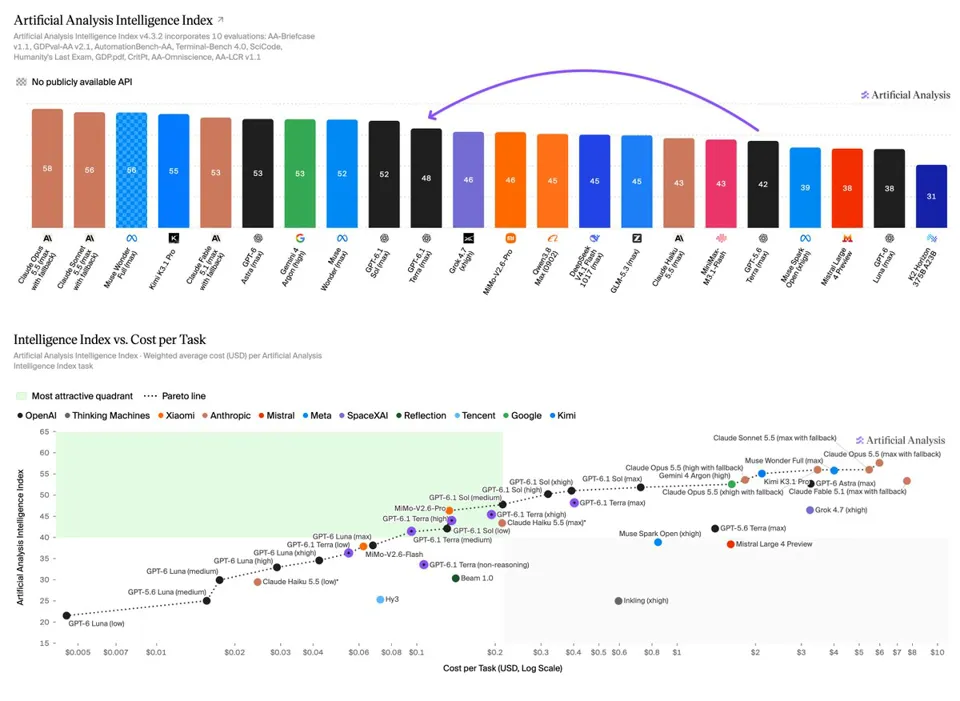
OpenAI 发布了 GPT-6.1 Terra,进一步拓展了成本效率的前沿。这是自 GPT-5.6 以来首个 Terra 级模型,其智能水平更高,而成本却不到前者的三分之一。
每 token 的定价仅为 GPT-5.6 Terra 的一半或更低——输入/输出每百万 token 分别为 5,而上一代模型为 12。缓存写入(Cache write)价格也减半,现为每百万 token $1.25。缓存输入(Cached input)价格降至四分之一,为每百万 token $0.05,而之前为 $0.20。
关键要点:
➤ 在低和中度努力级别下,实现智能与成本的帕累托最优: 在最大努力级别(max effort)下,GPT-6.1 Terra 在 Artificial Analysis Intelligence Index 中比 GPT-5.6 Terra 高出 6 分,而每项任务的成本不到后者的三分之一($0.40 vs $1.40)。在较低的努力级别下,得分提升更大,介于 7 到 13 分之间。低和中度努力级别在成本效率上实现了帕累托最优,而其他努力级别则位于前沿曲线之后。在最大努力级别下,该模型在 Intelligence Index 中的得分比 GPT-6.1 Sol 低 4 分,但比 GPT-6 Luna 高 10 分。
➤ 推动 Coding Agent Index 的成本效率前沿: 在新发布的 Artificial Analysis Coding Agent Index v2.0 中,该模型得分为 48 分,比 GPT-6.1 Sol(54 分)低 6 分,比 GPT-6 Luna(31 分)高 17 分。xhigh 和低努力设置位于 Coding Agent Index 成本效率的前沿曲线上,而其他努力级别则落后于前沿。
➤ 幻觉率下降 50 个百分点: 在我们的私有知识和幻觉基准测试 AA-Omniscience 中,当不知道问题答案时,GPT-6.1 Terra 猜测的比例为 38%。此前,GPT-5.6 Terra 的幻觉率为 88%。这一显著的幻觉率降低伴随着 AA-Omniscience 准确率提高 2 分——这意味着模型同时能正确回答更多问题。
➤ Terminal-Bench 4.0 得分跃升 20 分,大多数评估中有小幅改进: 该模型在基于终端的智能体基准测试 Terminal-Bench 4.0 中取得了显著进展,得分提升约 20 分,在最大努力级别下已可与 GPT-6.1 Sol 相媲美。在其他大多数评估中的提升幅度较小,例如在 GDP.pdf 中提升了 5 分。
祝贺 @OpenAI 和 @sama 发布新模型!