Rohan Paul (@rohanpaul_ai) · 2026/10/14 00:08:50
CMU 与微软发布 CRBugBench:Claude Opus 5 代码审查仅捕获 71.9% 已知 Bug,证实人类审核仍不可替代
卡内基梅隆大学与微软联合推出 CRBugBench 基准测试,专门评估 AI 在代码审查中识别真实 Bug 的能力。结果显示,表现最佳的 Claude Opus 5 在前 5 条评论中仅能捕获 71.9% 的已确认 Bug,且在私有仓库场景下性能下降高达 25.5%,表明当前 AI 尚无法完全替代人类进行代码审查。
报道全文原始报道全文
Rohan Paul (@rohanpaul_ai) · 2026-10-13 16
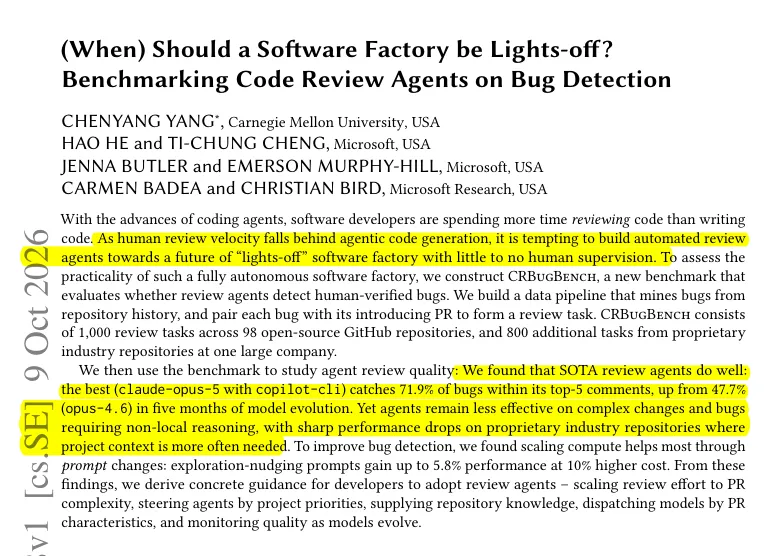
卡内基梅隆大学与微软的最新论文发现,表现最佳的 AI 代码审查器在其前 5 条评论中仅捕获了 71.9% 的已知 bug,这一比例仍然过低,不足以取代人类审查者。
如今 Agent 编写代码的速度快于人类审查的速度,这促使团队倾向于让 AI 也参与代码审查。然而,早期的审查基准测试将 AI 的表现与人类评论进行对比,而人类评论可能包含吹毛求疵的意见,或遗漏真正的 bug。
研究人员构建了 CRBugBench,包含 1,800 个代码审查任务,其中每个 Pull Request 都引入了一个经人类确认并修复的 bug。Agent 在沙箱环境中审查原始变更,随后由 AI 裁判检查其前几项主要发现是否准确指出了该 bug。
表现最佳的 Agent——claude-opus-5,在其前 5 条评论中捕获了 71.9% 的 bug,相比 5 个月前 opus-4.6 的 47.7% 有显著提升。但在某公司的私有仓库上,性能下降了高达 25.5%,因为这些仓库中的 bug 往往更依赖项目上下文信息。
建议将审查 Agent 与人类审查者配合使用,并为其提供仓库自身的领域知识,特别是在处理大型或上下文密集型变更时。