DeepSeek-V4.1-Flash 在 Rubin NVL72 实现 58 倍吞吐提升
vLLM 团队将 DeepSeek-V4.1-Flash 部署到单台 NVIDIA Vera Rubin NVL72 机架,实现每 GPU 170 万 tokens/s 吞吐、单用户 387 tokens/s,较 GB300 NVL72 提升 58 倍,峰值吞吐达 252 万 tokens/s。性能跃升主要来自针对 Rubin 分离式内存与 FP4 张量核调优的算子、低延迟专用解码内核,以及通过 NVLink 跨机架共享的 KV 缓存与 Engram 表。
报道正文
本文目录12 个章节
DeepSeek-V4.1-Flash 在 Vera Rubin NVL72 上:387 tokens/s 下吞吐量达 GB300 NVL72 的 58 倍
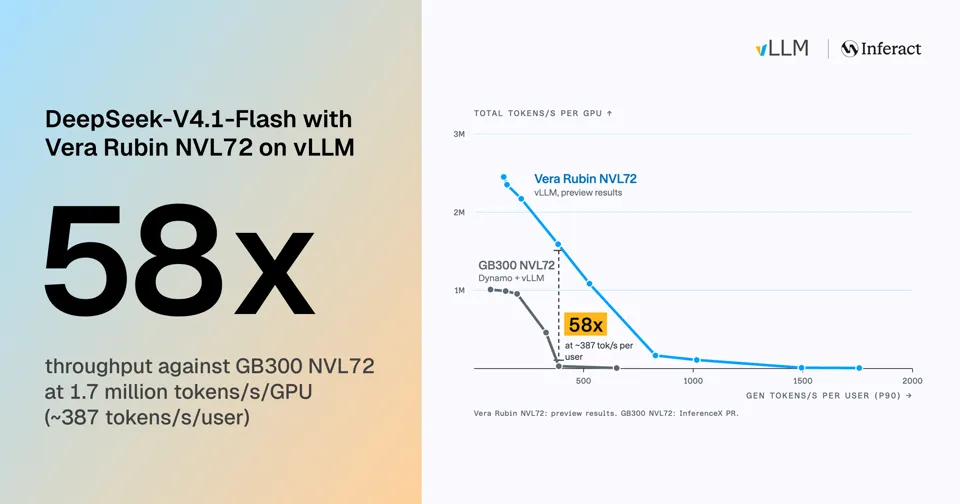
TL;DR: 在一台 NVIDIA Vera Rubin NVL72 机架上,vLLM 以每 GPU 1.7M tokens/s 的吞吐量服务 DeepSeek-V4.1-Flash,同时每位用户可获得 387 tokens/s,达到 GB300 NVL72 的 58 倍;峰值吞吐量达 2.52M,单用户可达 1,810 tokens/s。这些提升源于充分利用 Rubin 的新特性:针对其分离式内存和 FP4 张量核心调优的 kernel、面向低延迟的专用 decode kernel,以及通过 NVLink 共享的机架级 KV cache 和 Engram 表。
这是 DeepSeek-V4.1-Flash 系列的第三篇文章。第一篇介绍了 day-0 启动与 kernel 融合。第二篇通过 P/D 分离和 Wide-EP 将模型扩展到 GB300 NVL72 机架。本文则将同一套栈迁移到 Vera Rubin NVL72,我们上个月刚介绍过该平台。
Rubin 开辟了新的优化空间。我们先介绍塑造了这项工作的硬件事实,然后依次讲解四组优化:
- 面向 DEP prefill 和 decode 的 Rubin 优化 kernel。1 我们针对 Rubin 重构了 MoE、attention、GEMM、mHC 和 indexer kernel:受带宽约束的数据保留在每个 SM 各自的内存域中,SM107 更宽的 MMA 指令每次发射能完成更多工作,kernel 会在等待之前就发起加载及其依赖项。DEP2 prefill 步骤约快 28%,DEP decode 步骤约快 25%。
- 面向最低延迟的专用 TP decode 路径。 我们进行跨算子融合、计算与通信重叠以及调优,然后将模型以 TP8 分布到两个托盘上,在 batch size 为 1 时实现 1,810 tokens/s(P90)。
- 基于机架级内存池的 Dynamo 工作负载感知路由。 Rubin 的速度带来高得多的并发量,因此我们将机架内存池化:Mooncake KV 池从 DRAM 扩展到空闲 HBM,Engram 表则分片存放在各 GPU HBM 上。即使在极高并发下,前缀命中率仍保持在 96.5–97%,仅靠路由就能平衡各 rank。
性能概览
图 1:SemiAnalysis AgentX 在 NVIDIA Vera Rubin NVL72(vLLM,P/D 分离,Wide-EP)与 GB300 NVL72 上的对比。吞吐量统计包含缓存输入、未缓存输入和输出 token(GB300 来源)。
我们使用 SemiAnalysis AgentX 基准来测量性能,将其作为具有代表性的智能体服务负载,这与我们此前的文章保持一致。图 1 在两个标签页中分别比较了两个机架的原始吞吐量(每 GPU 每秒的总 token 数,包括输入、缓存和输出)以及功率归一化吞吐量。
我们如何测量
我们采用与此前 GB300 文章相同的方法。对于内核和模型前向性能分析,vllm bench forward 通过真实的 execute_model 路径,使用真实权重和真实 AgentX token 对精确的 prefill 和 decode 批次进行计时。我们在持续数秒的循环中对 prefill 内核进行 A/B 测试,并在结果存在差异时报告持续稳定后的数值。
从 DeepSeek-V4.1-Flash 看 Rubin
Vera Rubin NVL72 的三个特性主导了下文的大部分决策。当某项优化是 Rubin 特有的时,我们会说明它依赖其中哪个特性。
- 每个 GPU 拥有两个内存域。 SM 读取自身内存域的速度远快于交错内存,而从另一个内存域读取则更慢。正如 Rubin 预览所展示的,这对带宽受限的数据很重要:MoE 权重、LM head、MegaMoE 的 combine 缓冲区以及 mHC 残差流。
- SM107 新增了更宽的块缩放 MMA 指令。 我们在 MegaMoE 和低延迟路由 GEMM 中使用了新的 K64 混合精度(FP8×FP4)MMA,每条指令完成的工作量翻倍:MegaMoE 在每 rank 8K+ token 时吞吐量提升 8–11%,低批量大小的路由 GEMM 运行速度提升 12%。在 indexer 中,新的 K128 FP4 MMA 配合六 token 查询 tile,使 decode MQA-logits 内核提速 15–22%。
- 72 个 GPU 共享一个 NVLink 域。 TP8 可以跨两个计算托盘,而几乎不增加额外的 all-reduce 开销。Prefill 实例可以高效读取彼此的 HBM,因此大表不再需要复制到每个实例。
图 2:在一个 SM 的共享内存中,routed-expert GEMM 的权重分阶段布局,分别展示 SM100 MXFP8×MXFP4 MMA 与 SM107 在 packed FP4 上的 K64 MXFP8×MXFP4 MMA。
深入优化
内核
我们保留了 GB300 的三种引擎形态:DEP2 prefill、Wide-EP decode(DEP16 或 DEP32),以及用于最低延迟的 TP decode 路径(见下一节)。我们也保留了 DeepSeek 的内核集合(MegaMoE、MegaAttn、Mega-mHC、MegaGate、DeepSelect),并针对 SM107 重建了其中大部分内容。
DEP prefill:每步耗时减少约 28%
在每个 rank 32K token 的情况下,一个 prefill 步骤主要由 expert GEMM 占据;其余大部分时间用于将残差和 attention 的工作集通过 HBM 流式传输。因此,这一轮优化集中在 GEMM 周围的内核以及 Rubin 的两个内存域上:Mega-mHC 将残差保留在 die-local,MegaAttn 让其 tensor core 持续发射而不是等待加载,MegaGate 只对仍有可能进入 top 6 的 expert 打分。这些改进合计将一个 32K token 的 DEP2 prefill 步骤耗时减少了 28%。
图 3:prefill 内核的三项改动:Mega-mHC 的 die-local 残差、MegaAttn 的流水线与 MegaGate 的候选过滤器,以及它们累计带来的步骤耗时变化。
Prefill 优化细节
-
MegaMoE:为最繁忙的 rank 调整 tile 大小。 vLLM 在 eager prefill 中不会对 DP 批次进行填充,因此在 86% 的真实 DEP2 prefill 步骤中,空闲 rank 会按照自身极少的 token 数量来设置 MegaMoE 的 tile 大小,而它的专家却在为繁忙 rank 的 token 提供服务。现在,tile 大小会依据本地 token 数与 DP 平均 token 数中的较大者来确定。在 40 步回放中,MegaMoE 耗时下降 55%;在空闲 rank 旁执行单请求时,TTFT 在 8K 到 32K token 范围内下降 13–39%。
-
Mega-mHC:驻留于 die-local 内存的残差流。 在 prefill 规模下,Mega-mHC 受 HBM 带宽限制,每个 token 需要流式传输约 100 KB 的四路残差。现在,残差存放在一个跨两个内存域条带化分布的池中,Mega-mHC 为每个内存域维护一个任务计数器,因此每个 SM 会先排空自己所属内存域的任务,再去帮助另一个内存域。这导致大型 grid 受指令缓存限制,因此它们现在改为循环执行 Post 主体的一份副本,而不是四份。在 32K token 时,Mega-mHC 每次调用从 354 µs 降至 317 µs;5K+ token 的 DEP2 步骤提速 0.6–1.3%。
-
SM107 K64 块缩放 MMA 上的 Query 上投影。 MegaAttn 的 [tokens × 1,280] × [1,280 × 32,768] query GEMM 从 cuDNN 的 SM100 kernel 迁移到了基于 SM107 K64 MMA 的 FlashInfer CuTe DSL GEMM:在 4K 到 32K 行范围内提速 13–18%,在 16K–32K 的 DEP2 步骤上节省 1.1–1.7%。
-
MegaAttn:让 tensor core 持续满载。 在每个 rank 16K–32K token 时,稀疏注意力受限于发射和加载延迟。现在由一个空闲 warp 发射 SV,因此 QK 不再需要等待它们;KV 生产者会在等待槽位之前加载下一个块的 top-k 索引;cluster-launch-control warp 会将下一个作业的索引行预取到 L2;下一个作业的 query 会在当前作业最后一个 QK 之前加载。每个 TMEM lane 组现在会完整地为自己负责的 key 打分,因此 softmax 不再通过共享内存交换部分和。该 kernel 在 16K–32K token 时提速 15%,在 4K 时提速 23%,DEP2 步骤提速 0.9–2.1%。
-
Mega-mHC:带票据的任务环。 在长提示下,固定的任务步幅使 RMSNorm worker 远远落后于 Post,导致它们对 Post 输出的重读未命中 L2。大型 grid 现在从原子票据计数器领取任务(32K 时提升 18%)。Norm 任务还会预先发射所有加载,下一个任务的系数会提前到达,并且两个 Post warpgroup 共享同一份代码副本以减轻指令缓存压力:在 4K 到 32K token 范围内,每次调用再提速 13–22%。
-
MegaGate:每个 token 只读取一次,仅对候选专家打分。 对于长提示,一对 CTA 通过一次共享内存阶段(M=256 和 M=128 的 UMMA)计算一个 token 块的全部 384 个专家,而不是按每 128 个专家一组重新读取 token。路由器仅对仍有可能进入前 6 名的专家计算精确的 sqrt-softplus:利用第六大得分的上界以及该函数的斜率,为每个专家给出一个阈值,384 个专家中约有 7 个通过。该内核从 4K token 起提速 3–13%(32K 时从 77 µs 降至 68 µs)。
DEP 解码:每步耗时减少约 25%
与 GB300 上一样,解码受 MoE 制约。相比我们首个 Rubin 构建(该构建已包含 die-local 权重、Wide-EP dispatch 改动和 MQA logits 改动),这些优化将 DEP32 解码步骤的目标前向耗时(每 rank 20 个请求 × 6 个 token,DSpark k=5,在单个 4-GPU 节点上模拟)减少了约 25%。
图 4:Wide-EP 解码改动中的四项:die-local 专家权重、每个被 dispatch 的 token 一次 NVLink 往返、等待数据的 combine,以及跨 SM107 集群的 split-K 投影。
解码优化细节
-
Die-local MegaMoE 权重。 解码 MoE 受限于权重读取,而一个 SM 流式访问自身内存域的速度远快于交错内存。vLLM 按输出列将专家权重拆分到各个域,MegaMoE 只向每个域的 SM 提供本地 tile。DEP2 解码前向在 batch size 32 时提速 10.1%,在 168 时提速 5.5%。
-
Wide-EP dispatch:每个 token 一次 NVLink 往返。 在 DEP8 解码时,NVLink 仅以峰值的 39% 运行。现在每个拉取的 token 会在任何本地存储之前发出所有远程加载,只需一次往返而非两到三次。Warp 通过一次 fence 和一次选出的 release 来发布拉取,专家计数以不返回的
red原子操作发出,因此第一个 SM 的 392 次远程更新不再串行化。MegaMoE 在 DEP8 下提速 17%(192 → 160 µs)。 -
MegaMoE:等待数据而非屏障的 combine。 combine 缓冲区在每次启动时都填充一个任何输出都无法取用的哨兵值,因此 CTA 在自身 GEMM 任务完成后立即进行 combine,仅重新读取仍持有哨兵值的 16 字节组,然后恢复哨兵值。跨 rank 的尾部屏障在本次启动结束时发出信号,并在下一次启动开始时等待。在本地专家较少时,所有第一次 GEMM 任务都会在任何第二次 GEMM 任务之前被认领,从而保持权重持续流式传输。MegaMoE 在解码规模下提速 3.5–10.8%。
-
SM107 集群上的 Split-K GEMM。 每个 rank 只有几十行时,注意力输入和输出投影启动的 CTA 太少,无法以全带宽流式传输权重。Split-K GEMM 将 K 分散到一个 SM107 集群上,并通过分布式共享内存归约部分和,或者当 CTA 的对等切片超过 28 KB 时通过 L2 从寄存器归约。GEMM 提速 10–38%,解码前向在每个 rank ≤16 个请求时提速 3.1%,在 17–24 个请求时提速 1.9%。
-
MQA logits:六 token tile 与 SM107 的 K=128 MMA。 DSpark 验证每个请求向 indexer 发送 5–6 个查询行。该内核现在将它们打包成一个 192 宽的 tile,运行在两个 warpgroup 上,而不是两个 4-token tile 运行在三个 warpgroup 上;将每个 128 维 head 作为一次 SM107 K=128 MMA 发出,而不是两次 K=64;并以立即数偏移存储,无需按拆分进行 64 位地址运算:在每个请求 5–6 个 token 时提速 15–22%。
-
拆分 Mega-mHC:关键路径上只保留下一层所需的部分。 下一层需要 Mega-mHC 的 Post、route collapse 和 RMSNorm,但不需要它的 next mixes。现在由一个小内核只执行这三项操作,而 mixes 则在旁路流上运行,并在下一个边界处汇合。它以合并的 16 字节块搬运每条 route,每个 CTA 最多处理三个 token,因此在 212 个 SM 上,636 个 token 可在一波内完成。在每 rank 20–30 个请求时,decode 前向速度提升 2.0–4.8%;合并重写使该内核在 18–192 个 token 时再快 30–58%。
-
MegaAttn decode:更深的流水线。 Decode attention 每个 CTA 运行一到两个 token,形成一条由索引加载、KV 收集与解包,再到逐块 QK、softmax 和 SV 组成的延迟链。现在有三块索引加载和四批收集保持并行执行,当每个 SM 只有一个任务时,空闲的 query warpgroup 负责解包 KV,并且该内核在自身依赖等待结束后立即触发依赖项,从而将输出投影的序言与 attention 重叠。该内核在 6–424 行时速度提升 7–10%。
低延迟:采用 TP 的专用解码路径
为实现最低延迟,我们采用了一条专用解码路径。我们将其从 GB300 文章中移植过来,并针对 Rubin 进行了大幅重构,同时通过 TP8 将其分布在两个计算托盘上。在并发度为 1 的真实 AgentX 会话中,在 DSpark 接受度固定为每步 3.51 个 token 的情况下,P50 下每用户吞吐量从 1,117 tokens/s 提升至 1,844 tokens/s。除第一个专家 GEMM 外,一步解码由一串接近其延迟下限的小内核组成。
图 5:专用 TP8 解码路径的一步:引擎分布在两个计算托盘上,以及逐层内核链及其融合后的边界。
低延迟优化细节
- 跨两个托盘、基于 NVL72 的 TP8。 每个 rank 持有每个专家的 288 列切片和 8 个注意力头。跨托盘 all-reduce 仅比托盘内 all-reduce 多花 0.3 µs,因此 TP8 几乎不付出额外代价就将每 GPU 的权重读取量减半。借助路由 GEMM 和稀疏 MLA 的原生 TP8 形状,单步速度提升了 35%。
- SM107 上的打包 FP4 权重阶段。 第一个专家 GEMM 受限于每个 SM 在飞行中保留的权重字节数。UMMA 描述符只能寻址 256 KB 的共享内存,在 SM100 的一字节 FP4 布局下可容纳 7 个阶段。SM107 的 K64 MMA 读取打包 FP4,因此同样的空间可容纳 11 个阶段(图 2),每步节省 57 µs。
- 裸片本地 LM head。 LM head 读取其权重的一份副本,该副本拆分在两个内存域中。每个 SM 只流式读取自己那一半,接近域本地上限。
- all-reduce 与 mHC 合并为一次处理。 两个 all-reduce 都通过 NVLink 多播存储,从各自的 GEMM epilogue 直接发布到 Lamport 邮箱。接收内核对各 rank 求和,应用 mHC Post,折叠四条路由并计算 RMSNorm;在 MoE 边界处,它还会在网格等待之前运行 router GEMM(每步约 −30 µs)。下一层的 mHC pre-norm 在侧流上运行,拆分为 64 路(5.8 → 3.7 µs),路由 GEMM 为它留出 Rubin 212 个 SM 中的 16 个(−4 至 −10 µs)。
- 稀疏 MLA。 在 TP8 下,每个 rank 运行一个 8 头稀疏 MLA 内核。当前一个内核仍在运行时,它会收集除本步新增行之外的所有 KV 行,每个 PV 块在其 MMA 完成后立即将部分结果发送给所有者(−16 至 −21 µs)。Query RoPE 和 KV-cache 插入被融合进注意力周围的内核中,这也让注意力的序言更早启动(再节省 −36 µs)。
- 共享专家置于路由 GEMM 内部。 在 80% 的层中,共享专家是 MoE 子层的尾部。当行数低于 16 时,它现在在路由 GEMM 内部运行,每步节省 220 µs。
- 提前启动下一个内核。 all-reduce 终结器在其自身网格等待后立即启动其依赖项(−16 µs),索引器的 MQA logits 在其网格同步之前加载 KV(−24 µs)。
- Engram all-gather 在该层的流上运行。 在 TP8 下,NCCL all-gather 在 Engram 的关键路径上增加了 22 µs。融合的入口内核和该层自身流上的 Lamport all-gather 每步节省约 40 µs。
Dynamo 工作负载感知路由 + 机架级共享内存池
Rubin 计算速度快,因此一个机架能维持远高于 GB300 的并发量,而这些 agentic 会话的活跃前缀也超出了任何单 rank 缓存的容量。在 GB300 上,我们把前缀放在每个 rank 各自的 CPU 层,并将每个会话固定到某个 rank;在 Rubin 的并发水平下,这一层太小,而固定会话又会导致部分 rank 空闲、其他 rank 排队。我们通过在整个机架范围内池化内存来把内存推到极限:KV 放在 DRAM 和空闲 HBM 中,通过 RDMA 加载;Engram 表放在 HBM 中,通过 NVL72 的 NVLink 读取。即使在非常高的并发下,前缀命中率仍保持在 96.5–97%,接近理论命中率。由于没有会话绑定到某个 rank,仅靠工作负载感知路由就能让各 rank 保持均衡。
图 6:每个 prefill rank 都通过机架的 DRAM 和空闲 HBM(RDMA)从同一个 Mooncake 池加载 KV,并从对等节点的 HBM(NVLink)读取 Engram 表,因此 Dynamo 路由器可以把每个请求发送到负载最低的 rank。
Mooncake 池。 一个横跨每个 prefill 和 decode 托盘 DRAM 的 Mooncake store 取代了每 rank 的 CPU 层,因此任何 rank 都可以通过 RDMA 加载任何前缀,被迁移的请求只需付出一次 KV 加载的代价,而不是重新计算。我们优化了 prefill 调度器等待该池的方式:查找在进程外异步运行,已在本地 HBM 中命中的请求会跳过查找但仍刷新其租约,KV 加载在查找返回后立即开始,而不是等到下一步。因等待查找而未被充分利用的 prefill 步骤从步骤时间的 6–14% 降至 0.5% 以下,因等待 KV 加载而未被充分利用的步骤从 13.5% 降至 1%。
HBM 池。 DeepSeek-V4.1-Flash 模型很小,其每 token 的 KV 缓存也很小,因此服务一个请求只用到 prefill 和 decode GPU 的 HBM 的一小部分。一旦 Mooncake 持有这些前缀,其余部分就会闲置。现在每个 prefill rank 只保留足够一个最大长度请求使用的 KV 缓存,并把其余 KV 预算作为 HBM 段交给 Mooncake,其大小自动确定,从而将池从 DRAM 扩展到每个 prefill GPU 的空闲 HBM;这些段通过相同的 RDMA 路径读取。HBM 池仍处于实验阶段。
Engram 池。 现在,两种角色都将 Engram 的两张 94.4 GiB 哈希 n-gram 表保存在 HBM 中。Decode 已经将这些表拆分到其各个 DP rank 上(vllm#54371),但每个 DEP2 prefill 实例仍在主机内存中保留自己的一份副本,每个 tray 约 378 GiB。在 NVL72 上,prefill 引擎现在组成一个对等组来拆分这些表,18 个 GPU 上各放 10.5 GiB,其余部分通过 NVL72 的 NVLink(而非 RDMA)从对等节点的 HBM 读取(vllm#66552,图 7)。查找速度比从主机内存读取时更快,而释放出的主机内存可容纳约 1,500 个额外会话的活跃前缀。
图 7:每个实例的 Engram 表在主机 DRAM 中(之前)与在对等组 HBM 中拆分(之后)的对比。
工作负载感知路由。 由于所有前缀都位于共享池中,会话不再需要固定在一个 rank 上,这消除了会话亲和性导致的 DP 不均衡。Dynamo 将每个请求放置到未缓存工作量最少的(worker, DP rank)上,这仅是配置变更。在三个 DEP2 实例、并发度为 4,800 时,池加上路由使服务的请求数增加 68%,将 TTFT P50 从 29.8 s 降至 4.2 s,并将命中率从 91.8% 提升至 96.1%(图 8)。在 12 × DEP2 模拟中,某个 rank 空闲而另一个 rank 排队的时间占比从 10.3% 降至 1.3%,TTFT P90 从 0.98 s 降至 0.38 s。
图 8:三个 DEP2 prefill 实例在并发度 4,800 时的请求数/秒、TTFT P50 和命中率。
致谢
我们感谢 DeepSeek 开源 DeepSeek-V4.1-Flash 及其内核,感谢 NVIDIA 提供 Vera Rubin NVL72 的早期访问。我们特别感谢来自 NVIDIA 的 Hanjie Qiu、Lisa Wang、Jie Hao、Yaoyao Ding、Pei Li、Xin Li 和 Pen Chung Li,感谢他们在性能优化方面的紧密合作以及对 vLLM 和 Dynamo 的持续支持。我们还感谢 Mooncake 团队提供的 KV cache 存储,以及 SemiAnalysis 开发的 AgentX 基准测试。
本工作由 Inferact 主导。