OpenAI 发布 GPT-6.2 双版本 智能指数升至第二
OpenAI 推出 GPT-6.2 Astra 与 GPT-6.2 Sol 两款模型,在 Artificial Analysis 智能指数 v5 上分别升至 62 分与 57 分,仅次于 Anthropic 的 Claude Fable 5.2。Astra 定价下调 20% 至每百万 token 输入 8 美元、输出 40 美元,缓存输入降至 0.40 美元,Sol 价格与上代持平。OpenAI 借此占据单位任务成本帕累托前沿的大部分区间,与 Anthropic、Meta 共同构成前沿格局。
报道正文
OpenAI 发布 GPT-6.2 Astra 与 GPT-6.2 Sol,在 Artificial Analysis 智能指数中位列第二,并占据单位任务成本帕累托前沿的大部分
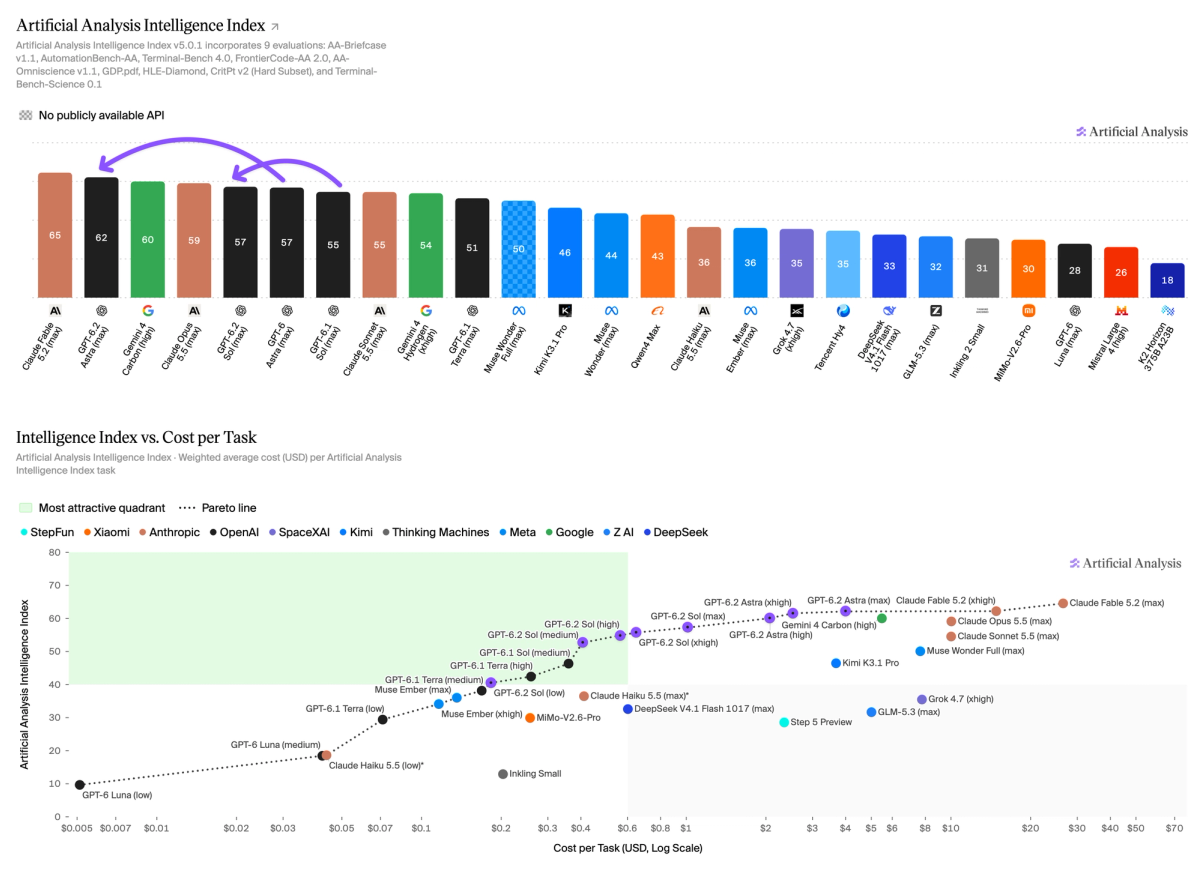
GPT-6.2 Astra 的定价为每百万 token 输入/输出 40,比 GPT-6 Astra 低 20%,缓存输入价格从每百万 token $1.00 降至 $0.40。GPT-6.2 Sol 的定价与 GPT-6.1 Sol 保持不变,为每百万输入/输出 token 10。
核心要点:
➤ 智能指数排名第二: 在 Artificial Analysis 智能指数中,OpenAI 目前仅次于 Anthropic 的 Claude Fable 5.2。GPT-6.2 Astra 较 GPT-6 Astra 提升 5 分,在各自的最高推理强度设置下超越了 Gemini 4 Carbon(60 分)和 Claude Opus 5.5(59 分)。GPT-6.2 Sol 提升 2 分至 57 分,与 GPT-6 Astra 持平,而单位任务成本仅约为后者的 15%。
➤ 占据大部分成本与输出 token 前沿: OpenAI 模型目前占据了单位任务成本帕累托前沿的大部分,仅与 Anthropic 和 Meta 共享该前沿。OpenAI 同样主导了单位任务输出 token 帕累托前沿,Claude Fable 5.2 是唯一出现在该前沿上的非 OpenAI 实验室模型。
➤ 在科学与知识方面表现强劲: OpenAI 在我们两项重点科学评测中均表现优异,在涵盖智能体科学研究工作流的 Terminal-Bench-Science 0.1 中位居第一,在涵盖物理推理的 CritPt v2(困难子集)中仅次于 Claude Fable 5.2 位列第二。在由 AA-Omniscience v1.1 Accuracy 衡量的事实知识以及推理与知识基准 HLE-Diamond 中,GPT-6.2 Astra 的成绩也仅低于 Claude Fable 5.2。
➤ 在 3D 与机器人领域领先: GPT-6.2 Astra 以 1318 分领跑 AA-3D,Claude Fable 5.2 为 1271 分,GPT-6.2 Sol 为 1259 分。该基准衡量模型构建交互式 3D 体验的能力,由人工评分员评定。GPT-6.2 还在 AA-Robotics v0.1 中领先,这是我们的一项研究预览,用于衡量语言模型在现实世界中理解、规划和行动的能力。GPT-6.2 Astra 和 GPT-6.2 Sol 分别得分 79 和 78,领先于 Claude Fable 5.2 的 75 分。我们的团队正在加紧添加更困难的任务,因为 OpenAI 和 Anthropic 的模型目前已能完成这一初步研究预览中的大多数基础任务。
➤ 编码智能体指数未见提升: 在 Artificial Analysis 编码智能体指数(Codex 测试框架,最大努力档位)中,GPT-6.2 Astra 与 GPT-6 Astra 持平,而 GPT-6.2 Sol 相较 GPT-6.1 Sol 下降了 3 分。对 Sol 而言,这一下降主要源于 SWE-Atlas-QnA-AA 上 14 分的跌幅——相比前代模型,该模型在回答中更容易遗漏关键事实。不过,从成本效率来看,GPT-6.2 Astra 和 Sol 的多个努力档位确实位于“每任务成本”的帕累托前沿上。
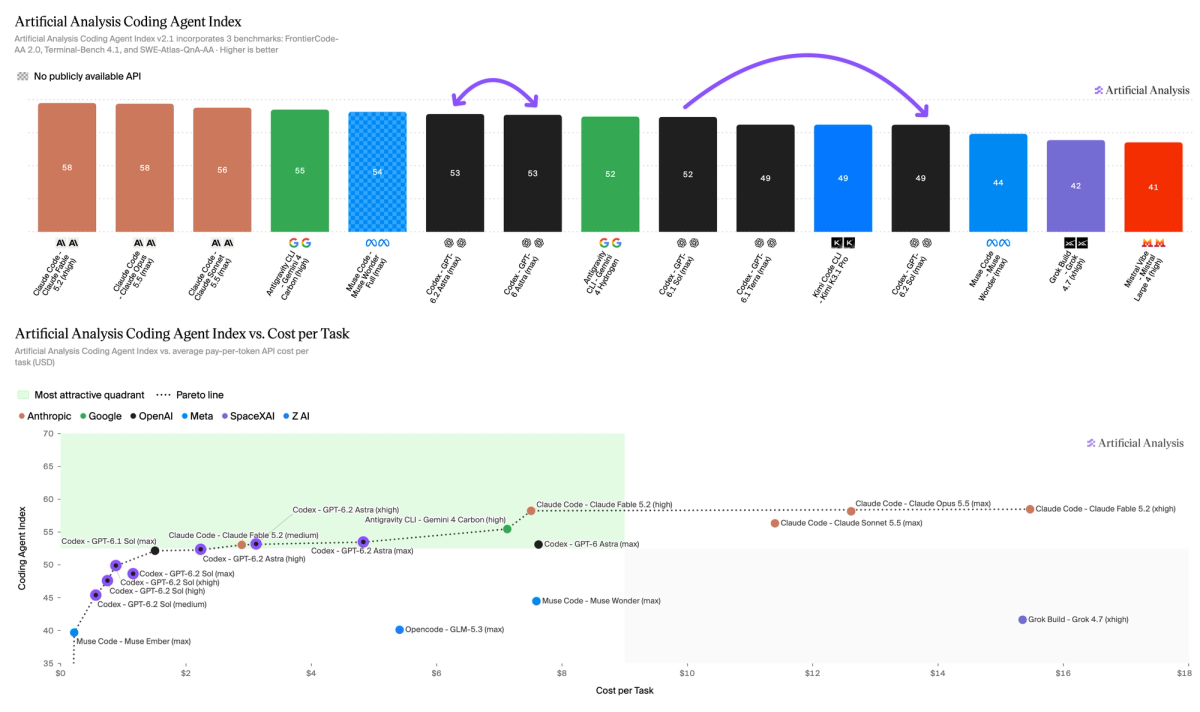
在 Artificial Analysis 编码智能体指数(Codex 测试框架,最大努力档位)中,GPT-6.2 Astra 与 GPT-6 Astra 持平,而 GPT-6.2 Sol 相较 GPT-6.1 Sol 下降了 3 分。对 Sol 而言,这一下降主要源于 SWE-Atlas-QnA-AA 上 14 分的跌幅——相比前代模型,该模型在回答中更容易遗漏关键事实。
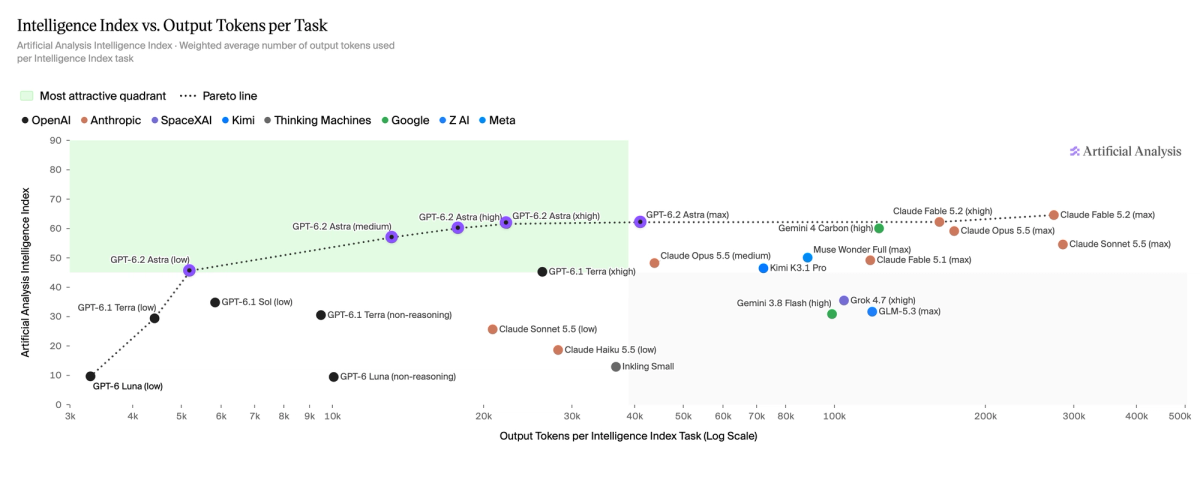
OpenAI 在“每任务输出 Token”帕累托前沿上占据主导地位,Claude Fable 5.2 是唯一出现在该前沿上的非 OpenAI 实验室模型。
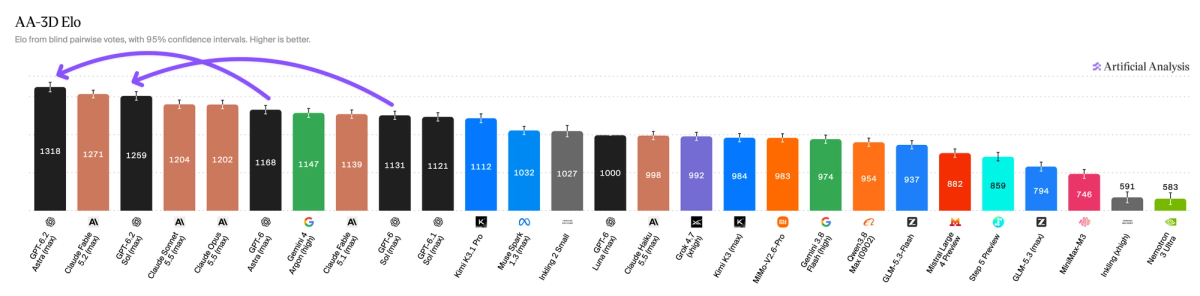
GPT-6.2 Astra 以 1318 分领跑 AA-3D,Claude Fable 5.2 以 1271 分位居其后,GPT-6.2 Sol 为 1259 分。该基准衡量模型构建交互式 3D 体验的能力,由人工评分员进行评定。
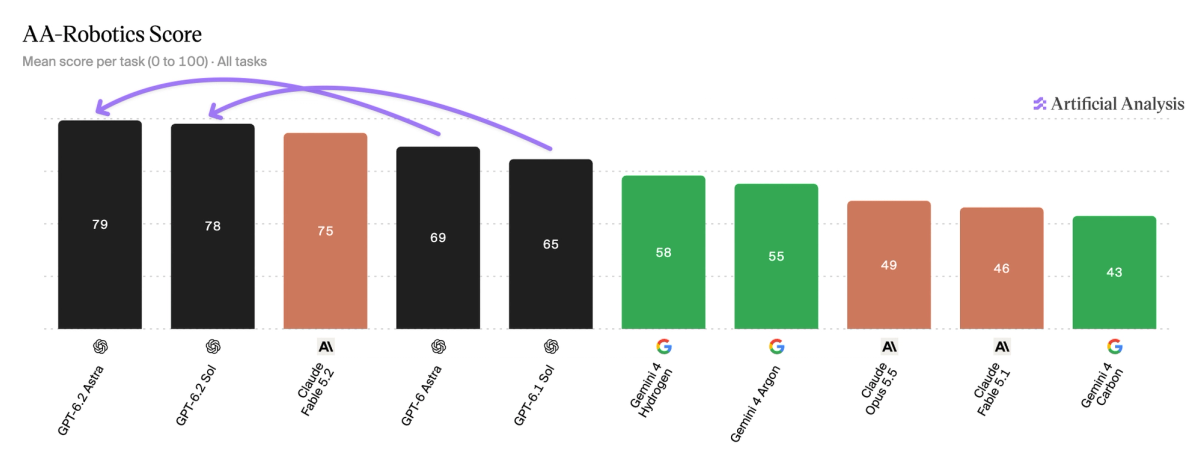
GPT-6.2 还在 AA-Robotics v0.1 中领先。该基准是我们的研究预览版,用于衡量语言模型在现实世界中理解、规划和行动的能力。
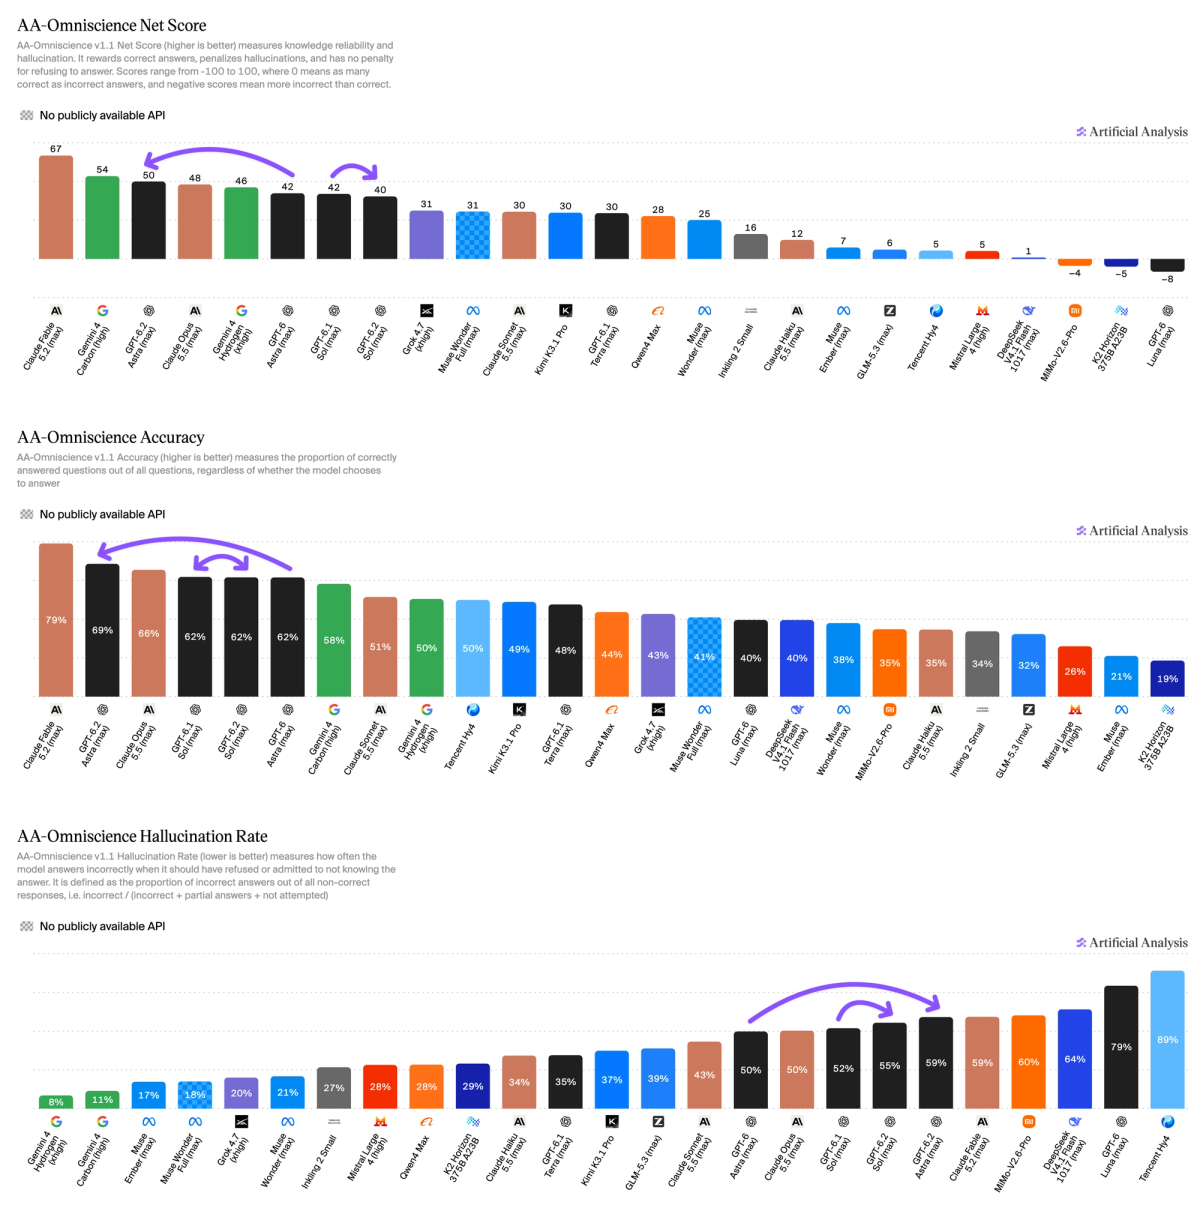
根据 AA-Omniscience 幻觉率衡量,GPT-6.2 Astra 和 GPT-6.2 Sol 在最大努力档位下的幻觉率分别为 59% 和 55%。该指标衡量模型在广泛主题的事实性问题中不知道正确答案时进行猜测的倾向。
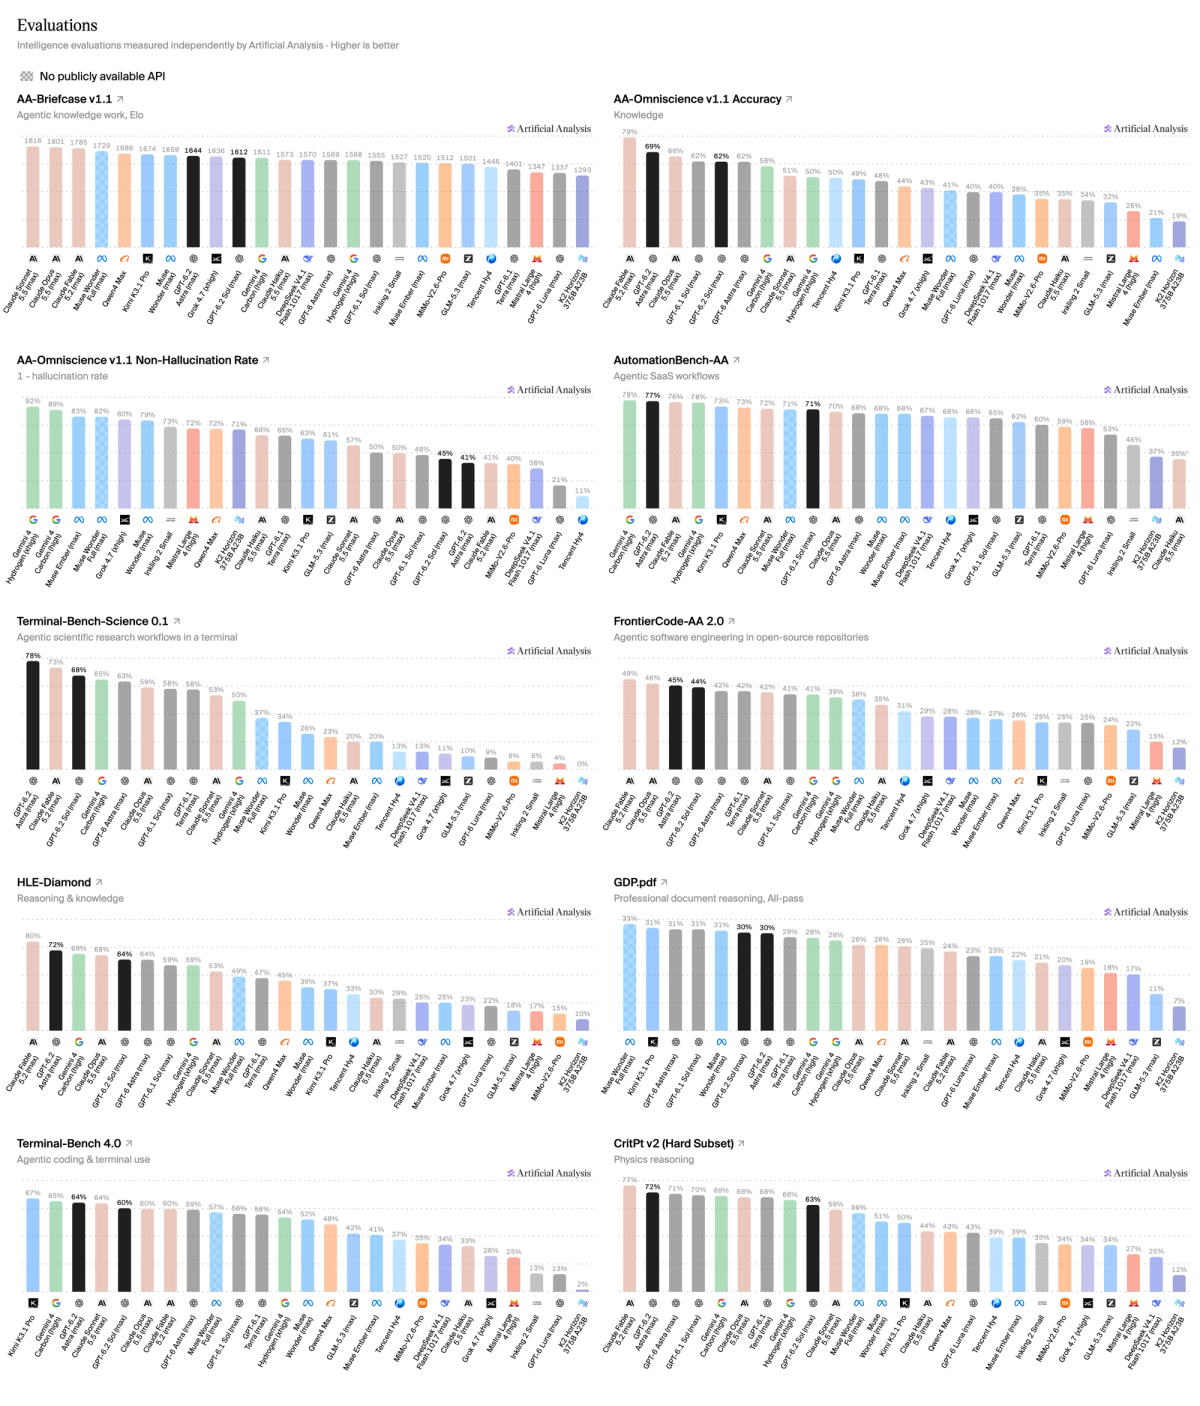
Artificial Analysis 智能指数 v5 中各项独立评估的细分结果
在以下网址将 GPT-6.2 与其他领先模型进行比较:https://artificialanalysis.ai