vLLM 官方博客 · 2026/10/16 08:00:00
vLLM 原生支持 Reflection Beam 501B MoE 模型,推理速度提升显著
vLLM 宣布从第一天起原生支持 Reflection 推出的 501B 参数混合专家(MoE)模型 Beam。通过引入 DFlash2 推测解码与自适应验证技术,单请求生成速度可达 708 tokens/s,且高并发下吞吐量额外提升 10%。此外,利用编码智能体自主优化内核,使批量解码和预填充性能分别提升 2.71 倍和 1.87 倍。
报道全文原始报道全文
本文目录10 个章节
TL;DR: Reflection 的 Beam 是一个拥有 501B 参数的 MoE 模型,每个 token 激活 23B 参数。vLLM 从第一天起就支持该模型,并在 NVIDIA Blackwell 架构上对其进行了优化:
- 完整的功能支持。 推理、工具调用和结构化输出开箱即用,并且你可以使用张量并行、数据并行或专家并行来运行该模型。
- Agent 驱动的优化。 编码 Agent 自主对模型进行了优化,使得 batch-1 解码速度比我们的初始实现快 2.71 倍,预填充速度快 1.87 倍。
- 带有自适应验证的 DFlash2。 配合 Beam 的 DFlash2 草稿模型,单个请求在 TP8 配置下可达 708 tokens/s,接受长度为 3.7。自适应验证机制会在每一步决定值得验证的草稿 token 数量,在高并发场景下可额外提升 10% 的吞吐量。
要试用它,请使用我们的 Docker 镜像 vllm/vllm-openai:reflection-beam:
docker run --gpus all --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai:reflection-beam \
  reflection/Beam-1.0-501B-A23B-NVFP4 \
  -tp 4 \
  --max-num-seqs 128 \
  --reasoning-parser beam \
  --tool-call-parser beam --enable-auto-tool-choice \
  --kv-cache-dtype fp8 \
  --attention-config '{"backend":"FLASHINFER"}' \
  --kernel-config '{"enable_flashinfer_autotune":false}' \
  --speculative-config '{
    "method": "dflash",
    "model": "reflection/Beam-1.0-501B-A23B-DFlash2",
    "num_speculative_tokens": 7,
    "attention_backend": "FLASH_ATTN"
  }'
模型架构
Beam 是一个 52 层的 MoE 解码器,隐藏层大小为 5120。MoE 路由遵循 DeepSeek-V3 的设计。主要区别在于注意力层以及残差流的归一化方式。
图 1:Beam 的层堆栈和一个稀疏解码器层。金色标记了与标准 pre-norm MoE 不同的部分。全屏查看。
注意力
-
混合滑动窗口与 NoPE 层。 43 层使用基于 RoPE 的滑动窗口注意力机制,仅关注最近 512 个 token。其余 9 层(每隔六层一层,加上最后一层)在完整上下文上进行注意力计算,且不使用位置编码(NoPE)。
-
NoPE 层上的 SSMax。 在没有 RoPE 的情况下,随着键(keys)数量的增加,注意力分布会趋于平坦。SSMax 将每个查询(query)缩放
(1 + p/2048)^0.1倍,其中p为从 1 开始的位置索引,从而使 softmax 随着上下文的扩展而变得更加尖锐。 -
带有逐头 Q/K 归一化的 GQA。 包含 48 个查询头、8 个 KV 头,头维度为 128。在执行 RoPE 或 SSMax 之前,Q 和 K 均按头进行 RMS 归一化。
-
Sigmoid 输出门控。 在
o_proj之前,每个头的输出乘以 σ(gate + bias),其中 gate 来自其自身的全宽投影并带有可学习的逐头偏置。这使得模型可以逐个 token 地调低或关闭某个头。 -
较小的 KV 缓存。 只有这 9 个全注意力层需要为整个序列保留 KV:
-
每个 token 存储 9 × 2 × 8 × 128 个值,即 BF16 下为 36 KiB,FP8 下为 18 KiB。
-
对于完整的 1M token 上下文,分片前的 FP8 KV 缓存约为 18 GiB。
MoE 与残差流
- DeepSeek-V3 风格的 MoE。 包含 256 个路由专家(d_ff 2,560,NVFP4),路由方式与 DeepSeek-V3 相同:通过 sigmoid 分数加上校正偏置,从 8 个专家组中选出最佳的 4 组,再从中选出 top 8 专家,并将重归一化后的权重缩放 2.5 倍。与 DeepSeek-V3 不同,这里没有共享专家。第 0–2 层使用稠密的 SwiGLU MLP(d_ff 20,480)代替。
- FP32 路由器。 5120 × 256 的路由器权重、累加过程以及 logits 全部采用 FP32 精度。
- 三明治归一化(Sandwich norm)。 每个子层前后各有一个 RMSNorm。
- 深度缩放残差。 第 n 次残差加法计算
h ← √((n−1)/n)·h + x/√n,而不是简单的h + x。在子层输出方差为单位方差的前提下,这种设计使残差流在每个深度都保持单位方差,而不随深度增长。
Agent 驱动的优化
我们最初的实现版本是一个未经优化的、几乎纯 PyTorch 编写的模型版本。随后,我们通过编程智能体(coding agents)对其进行了自主优化:它们对模型进行性能分析(profile)、编写内核(kernels)并对每项更改进行基准测试。在 TP8 配置下,以下七项更改将 batch-1 解码速度从每步 8.95 ms 提升至 3.30 ms,并将 8 × 2K 预填充(prefill)时间从 328 ms 缩短至 176 ms。
图 2:GB200 上 TP8 模型前向延迟在每次优化后的变化,针对 batch-1 解码和约 100K 上下文下的 8 × 2,048 token 预填充。两个面板使用不同的刻度。查看表格以获取精确数值,或全屏打开。
- 融合 Norm → Residual → Norm(解码延迟降低 40%)。每个 104 个子层边界处的 post-norm、缩放残差加法以及下一个 pre-norm 现在作为一个 Triton kernel 运行,采用 FP32 计算并保留参考实现中的 BF16 舍入点。
- 融合 Q/K Norm、RoPE/SSMax 和输出门控。 每头 Q/K RMSNorm 和 RoPE(或 SSMax)作为一个 kernel 运行,sigmoid 门控作为另一个 kernel。
- 将 All-reduce 融合进 Norm 中。 每一层中的两个 TP all-reduce 都在 norm kernel 内部执行,基于 FlashInfer 的 multicast all-reduce。在 MoE 之后,同一个 kernel 还负责合并 top-8 专家的输出。
- 为 FP32 Router 定制 GEMM kernel。 Router 之前回退到通用路径。vLLM 的小批量 FP32 router kernel 现在支持 Beam 的 5120 × 256 形状,保持 FP32 权重、累加和 logits。
- 合并 QKV + Gate 投影并使用低延迟 GEMM。 Q、K、V 和 gate 权重在加载时打包成一个矩阵,因此四个投影作为一个 GEMM 运行。对于小批量,它使用低延迟 CuTe DSL GEMM 或 FlashInfer 的 TinyGEMM。
- 融合 KV-cache 更新。 Q/K norm 和 RoPE kernel 现在也将 K 和 V 写入 KV cache,从而无需单独的 cache-write kernel。
- 稠密 MLP 激活在一个 kernel 中完成,适用于三个稠密层。
融合计算图
经过这些更改后,一个 MoE 层在 TP8 的 batch-1 解码中作为 13 个 kernels 运行。
图 3:单个 MoE 层的 kernel 启动顺序,来自 batch-1 TP8 解码的 rank-0 trace。金色 kernel 是为 Beam 编写、融合或扩展的。每个 kernel 列出了其计算的运算。全屏打开。
- 6 个 kernel 是为 Beam 编写、融合或扩展的。 所有小的 Beam 特定操作都合并到了相邻操作中,且两个 all-reduce 都位于 norm kernel 内部。
- 7 个 kernel 来自库: TRTLLM-gen attention、cuBLAS 输出投影以及 TRTLLM NVFP4 MoE 路径(量化、两个路由 kernel、两个分组 GEMM)。大部分剩余时间消耗在这里,因此它们是下一步优化的重点。
Attention DP + MegaMoE
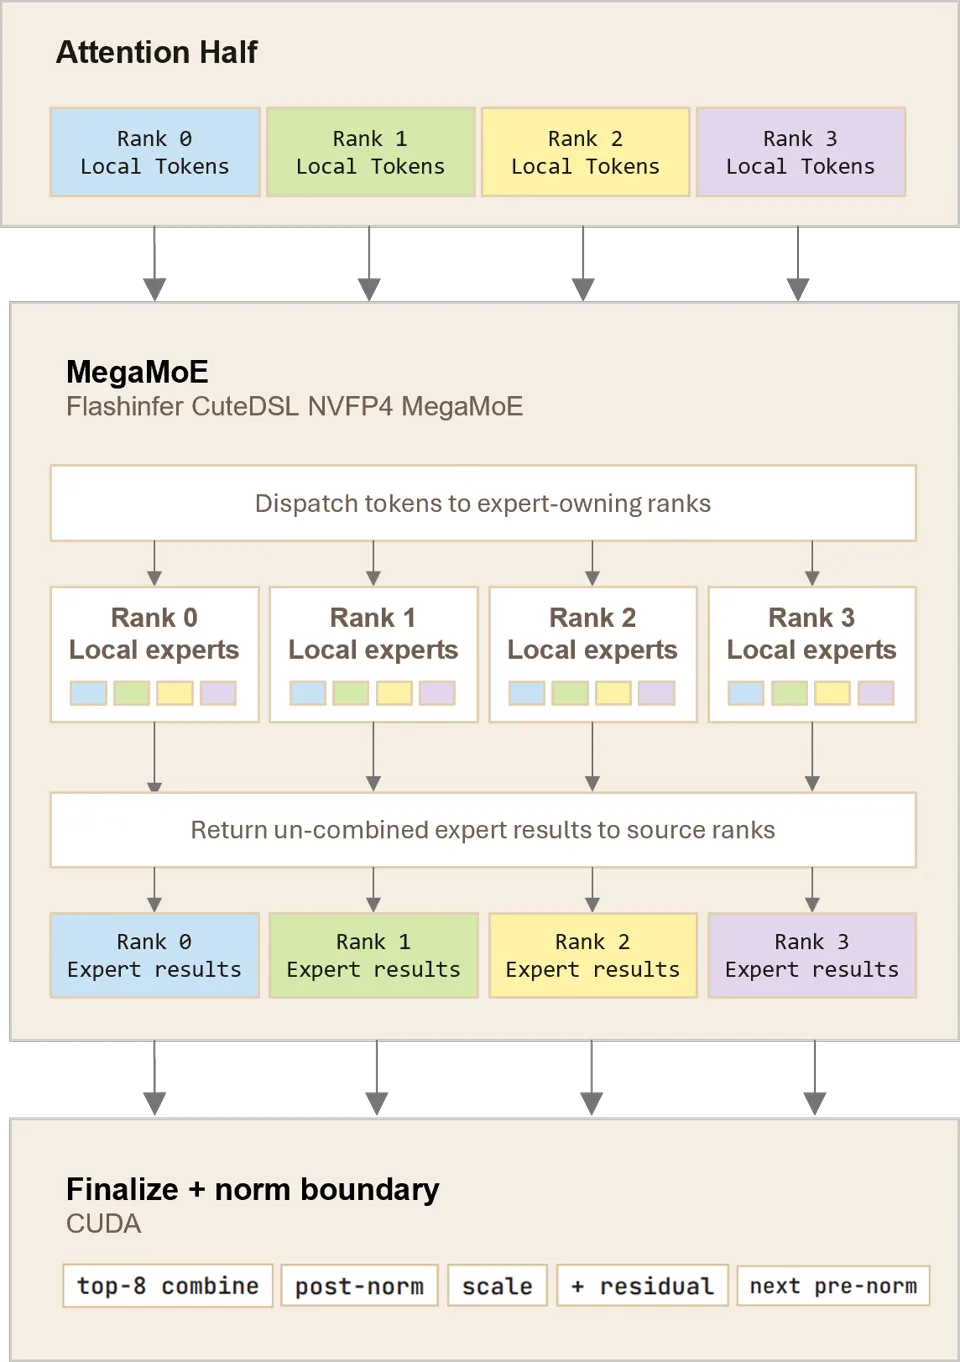
图 4:FlashInfer CuteDSL NVFP4 MegaMoE 可将通信与专家计算进行融合。
在高并发场景下,结合 Attention DP 与 MegaMoE(由 FlashInfer 的 CuTe DSL NVFP4 MegaMoE 内核提供支持),可进一步提升 Beam 的性能。Finalize + norm 边界融合技术依然适用。
| 配置 | 峰值输入 token 吞吐量 |
|---|---|
| Attention DP + MegaMoE | 168.8K tokens / 秒 |
TP (flashinfer_trtllm, flashinfer_nvlink_one_sided) | 98.7K tokens / 秒 |
Attention DP 配合 MegaMoE 实现了比 TP4 高 1.71× 的峰值预填充(prefill)吞吐量。基准测试设置:4×GB300,输入序列长度为 32K tokens,输出序列长度为 1 token,以隔离评估预填充性能。
要启用 Attention DP + MegaMoE,请将 MoE 和并行设置替换为:
  --moe-backend flashinfer_moe_ep_cutedsl \
  --data-parallel-size 4 \
  --enable-expert-parallel
DFlash2 推测解码
Beam 内置了 DFlash2 草稿头(draft head),vLLM 从第一天起就对其提供支持。它不再逐个生成 token,而是基于目标模型的隐藏状态,在单次前向传播中预测整个 token 块。
- 草稿器(Drafter)。 包含 5 层滑动窗口层,读取来自 5 个目标层的隐藏状态,并共享目标模型的 embedding 和 LM head。通过分组卷积和一个小型候选选择器,恢复了并行草稿器所丢失的部分从左到右的依赖关系。
- 自适应验证。 当设置
"enable_adaptive_verification": true时,vLLM 会预测每个草稿 token 被接受的概率,仅验证那些值得付出代价的 token,而不是每步固定验证一定数量。由于 DFlash2 没有置信度头,接受率估计值来源于草稿器自身的 logits(参见我们关于自适应验证的最新文章)。 - 内核(Kernels)。 草稿器的卷积、norm 和 KV 写入操作均进行了融合,且整个草稿步骤在 CUDA graph 中运行。FP8 KV cache 同样适用于草稿器,且不会改变接受率。
在 TP8 上的服务结果(分别启用和禁用自适应验证),针对 SPEED-Bench 的 throughput_1k 数据集中的低熵类别进行测试:约 1K token 的提示词,主要为代码补全和文本排序任务,采用贪心解码,输出 token 数最多为 4K。低熵文本更容易预测,因此在开放式聊天场景中,预期接受率会更低。
| 并发数 | 固定草稿 (tok/s) | 自适应 (tok/s) | 变化 | 接受长度 |
|---|---|---|---|---|
| 1 | 708 | 707 | −0.1% | 3.71 → 3.61 |
| 8 | 3,232 | 3,221 | −0.3% | 3.67 → 3.57 |
| 32 | 7,744 | 8,275 | +6.9% | 3.68 → 3.29 |
| 128 | 15,012 | 16,632 | +10.8% | 3.68 → 3.23 |
在高负载下,自适应验证的优势得以体现。在并发数为 128 时,它将输出吞吐量提升了 10.8%,并将 p99 TPOT(每个输出 token 的时间)降低了 9%。虽然每步验证的草稿 token 数量减少导致接受长度略有下降,但节省的计算量超过了损失。在低并发场景下,额外的草稿 token 几乎不增加开销,因此自适应验证的表现是中性的。
入门指南
本文开头提供的命令是一个不错的默认配置:在单个 GB300 节点上使用 TP4,配合 DFlash2 和 FP8 KV cache。要启用自适应验证,请在 --speculative-config 中添加 "enable_adaptive_verification": true。上述其他优化项默认已开启。
-
选择并行设置。
-
若追求最低延迟,请使用 TP4 或 TP8。
-
若追求更高吞吐量,请结合数据并行注意力机制与专家并行,例如使用
-dp 4 --enable-expert-parallel。 -
推理与工具调用。
beam解析器会读取随检查点一同发布的响应模板。默认情况下,vLLM 还会将每个响应约束在该模板内,从而确保工具调用始终能够解析并匹配各工具的 JSON schema。response_format和thinking_token_budget照常工作。若要关闭默认的约束功能,请设置VLLM_BEAM_ALWAYS_CONSTRAIN_OUTPUT=0。
SkyRL 对 RL 的 Day 0 支持
我们还与 SkyRL 团队合作,实现了 Beam 模型上强化学习(RL)的 Day 0 支持。开箱即用地支持 LoRA、BF16 全量微调以及 MXFP8 RL,并为 500B 规模提供了升级版的 RL 技术栈。
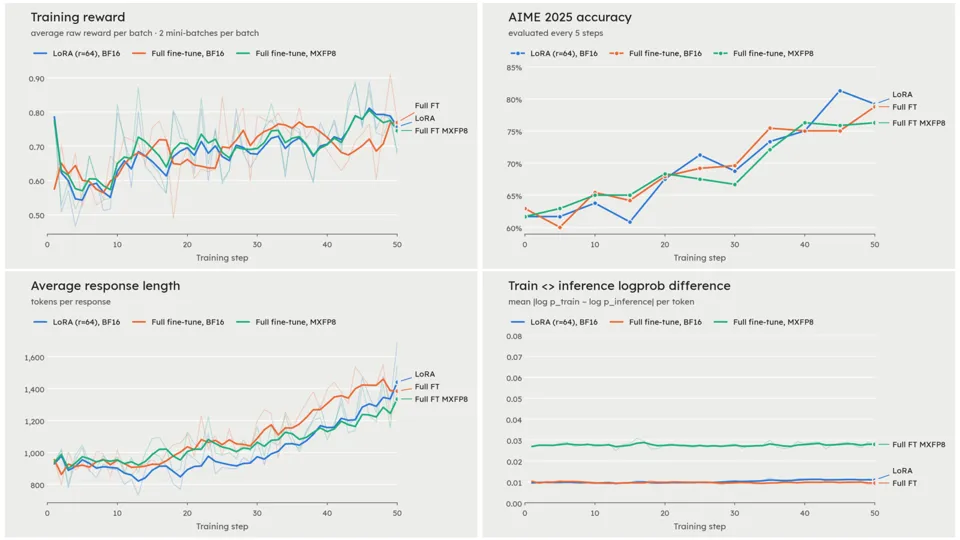
SkyRL 团队使用 vLLM 进行推理、Megatron 进行训练,基于 DAPO 配方对 Beam 模型进行了后训练。LoRA、全量微调和 MXFP8 RL 在 50 个训练步骤(即 100 次优化器更新,推理模式为 minimal)内均取得了相似的性能提升,AIME25 上的平均准确率(avg@8)从约 61% 跃升至约 79%。在启用 Rollout Routing Replay (R3) 的情况下,LoRA 和 BF16 全量微调中 Megatron 与 vLLM 之间的平均绝对 log-probability 差异保持在 0.01 以下,而 MXFP8 RL 则保持在 0.03 以下。
更多细节请查阅 SkyRL 博客!
致谢
这项工作由 Inferact、Reflection 和 Nvidia 团队紧密协作完成:
- Inferact: Woosuk Kwon、Ziqi Zhao、Ao Shen、Tiezhen Wang
- Reflection: Kaixing Wu、Yoni Gozlan、Neil Gollapudi、Thibaut Barroyer、Aymen Kallala、Matthias Reso、Florent Gbelidji
- Nvidia: Siyuan Fu