LangChain 提出智能体可观测性新范式:从调试工具转向驱动系统级学习闭环
LangChain 创始人 Harrison Chase 指出,传统将智能体可观测性仅视为调试工具的观点过于狭隘。文章主张通过结合执行轨迹与多维反馈信号(如接受度、风险性),构建涵盖模型、框架及上下文的全系统学习闭环,以优化智能体的长期行为表现。
报道正文
本文目录7 个章节
Harrison ChaseMay 5, 20268min返回博客创建智能体创建智能体
大多数团队最初将智能体可观测性视为一种调试工具。当出现问题时,你打开 trace(追踪记录),检查各个步骤,找出智能体在哪里做出了错误决策。
这很有用,但视野过于狭窄。
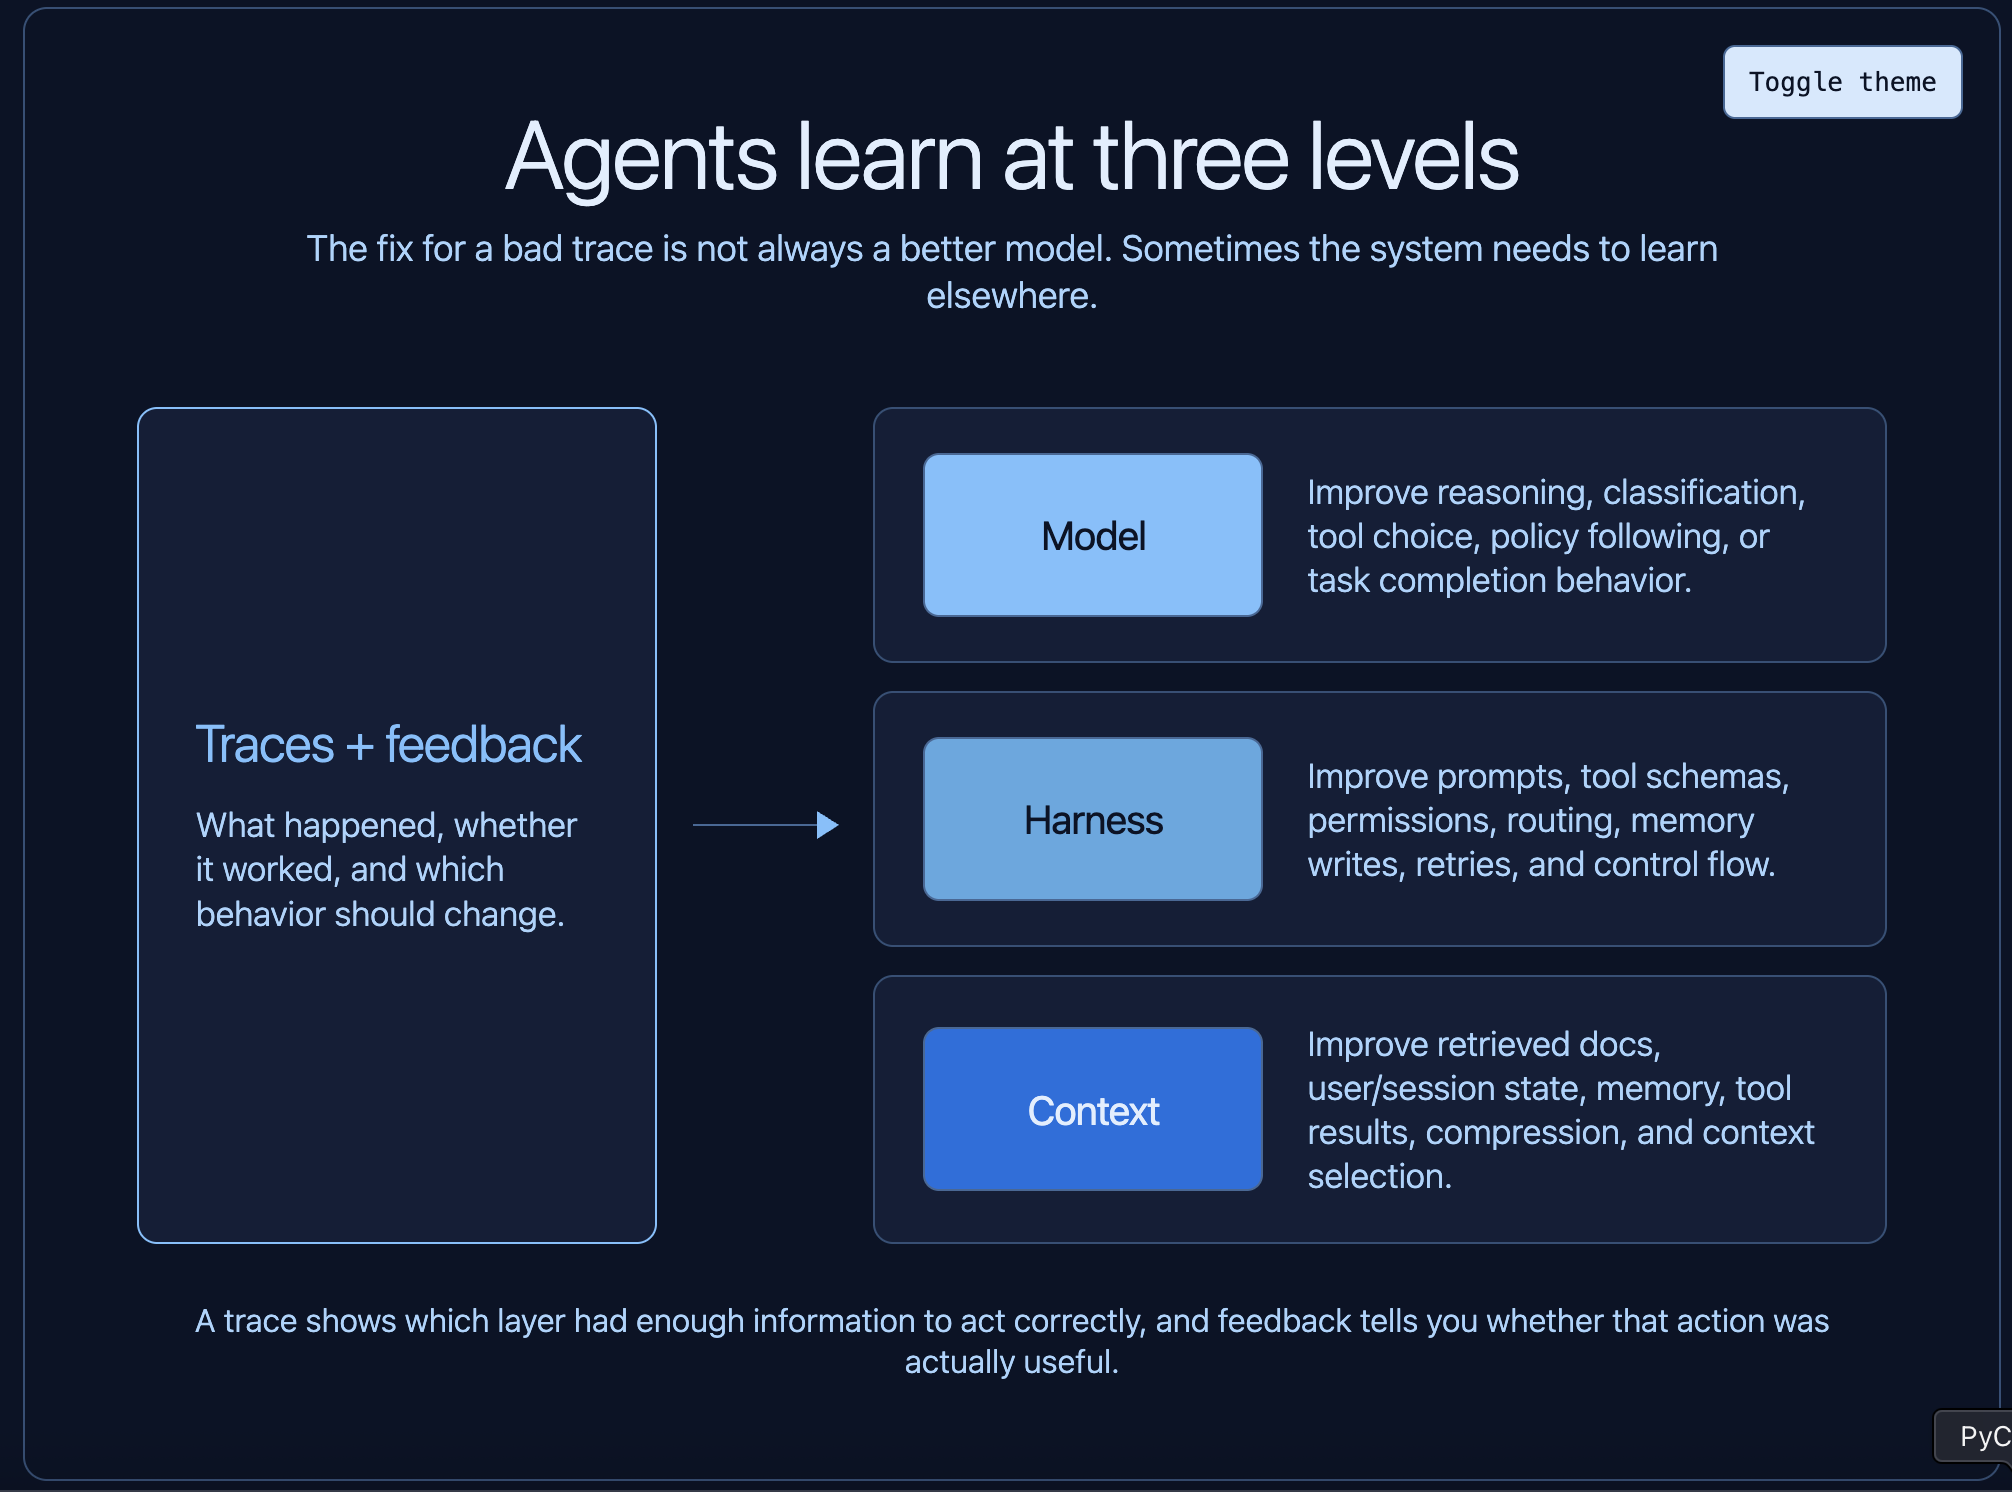
智能体可观测性的深层作用是驱动学习。然而,仅靠 trace 无法形成这一闭环。你还需要反馈:即那些能够表明智能体行为是否有用、是否被接受、是否被拒绝、是否低效、是否存在风险或错误的信号。
这种学习不仅限于模型训练层面,而是贯穿整个智能体系统:包括模型应该做什么、harness(执行框架)如何引导它、需要什么样的上下文、哪些故障模式反复出现,以及哪些行为真正对用户有效。
Trace 不仅仅是发生事件的记录,反馈也不仅仅是最终的评分。两者结合,构成了改进系统的原始素材。
学习发生在多个层级
智能体系统可以通过多种方式实现“学习”并随时间推移不断改进。我们在以下文章中对此进行了探讨:
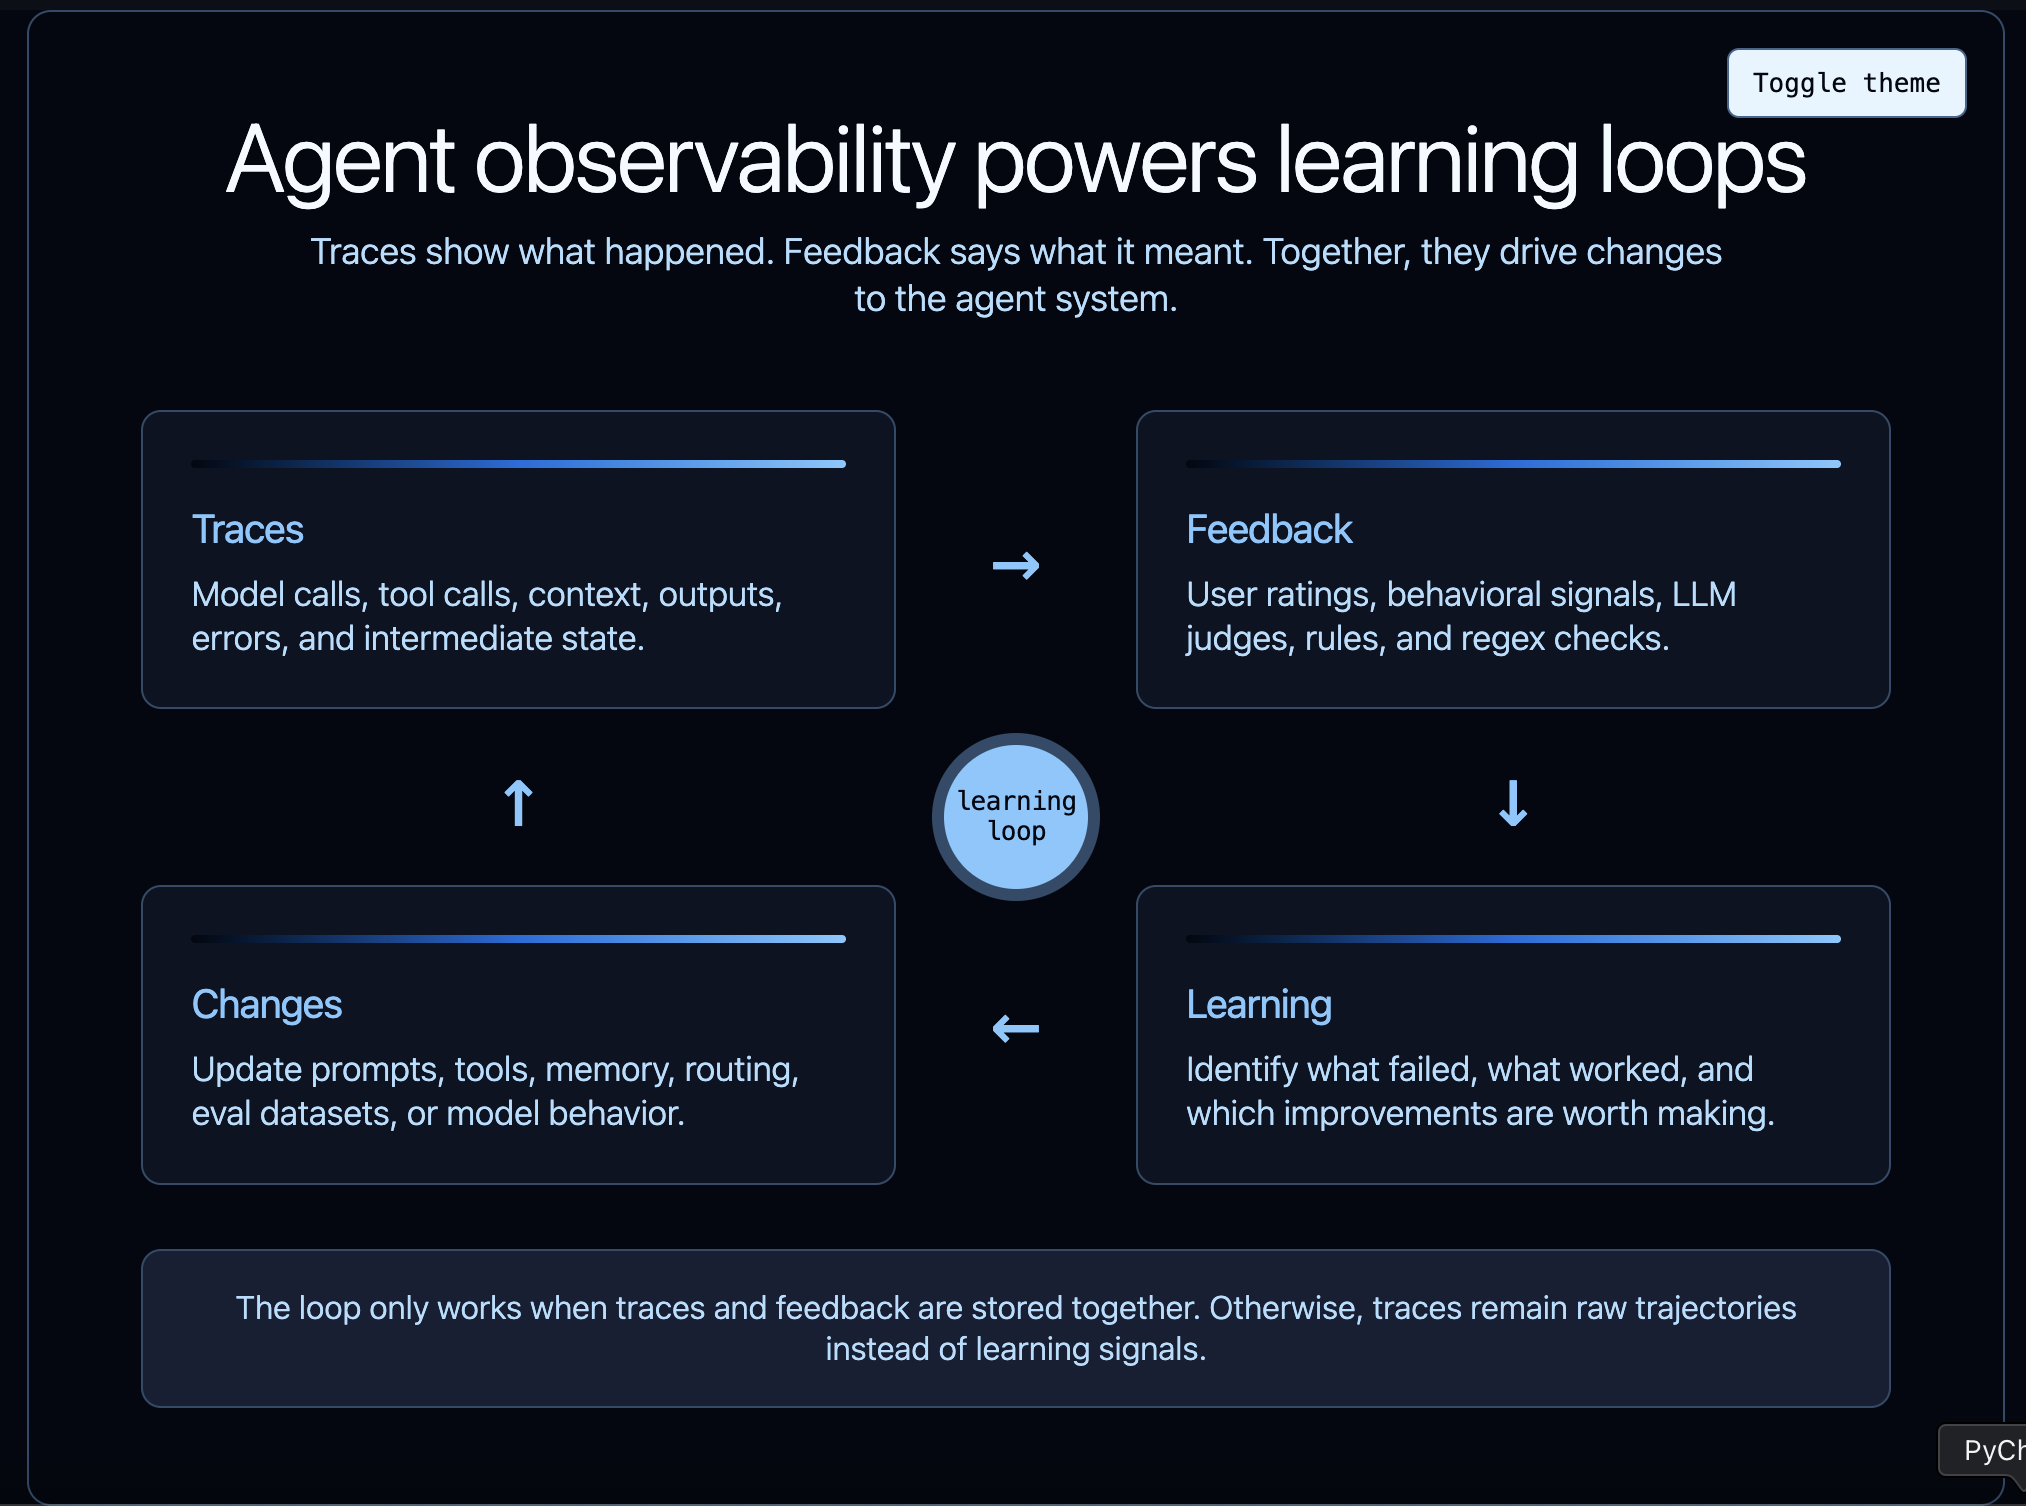
学习可以发生在模型层级。你可能会发现一些示例,其中模型持续错误分类请求、选择错误的工具或未能遵循策略。这些 trace 可用于通过 SFT(监督微调)或 RL(强化学习)来更新模型权重本身。
学习可以发生在 harness 层级。Harness 是指围绕模型的一切组件:提示词、工具 schema、权限检查、控制流、记忆更新逻辑、路由、重试机制和护栏。某条 trace 可能显示智能体具备正确的模型能力,但缺乏合适的脚手架支持。也许工具描述存在歧义,也许智能体需要“先读后写”的约束条件,也许系统提示词在权衡取舍上出现了偏差。
学习也可以发生在上下文层面。Agent 对所提供的信息极为敏感:检索到的文档、记忆、用户偏好、工具结果、历史对话轮次以及环境状态。一条 trace 可以表明,模型在给定糟糕或缺失的上下文时做出了合理的决策。在这种情况下,学习循环应当优化上下文的检索、存储、压缩或丢弃方式。这通常被称为“记忆”(memory)。
关键在于,所有这些学习循环都由 traces 驱动。如果你不知道 agent 看到了什么、做了什么以及接下来发生了什么,你就无法可靠地知道该改进什么。
这就是为什么 agent 可观测性赋能 agent 评估。Trace 是 agent 行为变得可见的地方。
学习可以是自动化的,也可以是人工驱动的
有些学习是人工驱动的。开发人员查看一条 trace,发现 agent 调用了错误的工具,然后更新 prompt 或工具 schema。产品经理审查一系列失败的对话,意识到产品需要一个新的工作流。标注人员为 traces 打标签,以便团队构建更好的 eval 数据集。
这仍然是学习。只是其中有人类参与(human in the loop)。
其他学习则是自动化的。系统可以采样生产环境的 traces,运行在线评估,检测已知的失败模式,向数据集中添加示例,或在出现异常时触发审核队列。Agent 不需要自动自我改进,学习循环就可以实现自动化。自动化可能仅仅是识别出哪些 traces 值得关注,并将它们转化为结构化的反馈。
无论哪种方式,这个过程都由 traces 驱动。
对于单个 agent 且流量较低的情况,人工审查可能就足够了。但对于多个 agent 或高流量的生产环境,这就变成了一个基础设施问题。你需要捕获 traces,对其进行过滤、评分、路由,并保留那些重要的部分。
Traces 是必要的,但还不够充分
Trace 告诉你发生了什么。但它本身并不能告诉你所发生的事情是好是坏。
这种区别至关重要。Agent 可能通过 40 个步骤完成一项任务,但也许同样的任务本应在 6 步内完成。它可能给出一个自信的最终答案,但用户却拒绝了它。它可能避免了抛出错误,但仍然未能满足用户的意图。它可能调用了正确的工具,但传入的参数却存在细微的错误。
要从轨迹(traces)中学习,你需要将反馈附加到这些轨迹上。
反馈是将可观测性从被动记录转化为训练信号、调试信号、产品信号或评估信号的关键。没有反馈,你拥有的只是一大堆轨迹数据。有了反馈,你就可以开始提出有价值的问题:
这是核心要求:在 Agent 的可观测性数据中存储反馈。
反馈可以来自多个渠道
反馈不一定意味着人工对每条轨迹进行手动评分。在实践中,有用的反馈以多种形式存在。

最明显的是直接的用户反馈:点赞、点踩、星级评分或书面纠正。这种信号易于理解,但通常非常稀疏。大多数用户不会留下显式反馈。
其次是间接用户反馈。对于编码 Agent,这可能包括被接受的代码行数、被撤销的差异(diffs)、编辑后通过的测试,或者用户是否保留了生成的更改。对于支持类 Agent,这可能取决于用户是否重新打开了工单。对于研究类 Agent,这可能取决于用户是否复制了答案或再次提出了相同的问题。这些信号比显式评分更具噪声,但往往数量更多。
你还可以使用 LLM-as-a-judge 来生成反馈。评判者可以对答案是否有帮助、Agent 是否遵循策略,或轨迹是否可疑进行评分。这很有用,因为它可以大规模运行,特别是作为生产环境轨迹的在线评估器。它并不完美,需要进行校准,但它为团队提供了一种方法,可以在人工审查速度过慢的情况下创建结构化反馈。
最后,反馈可以是确定性的。规则和正则表达式常被低估。如果你知道某种失败模式,就将其编码下来。如果 Agent 绝不应在未获批准的情况下调用破坏性命令,请对此进行检查。如果响应应包含引用,请对其进行验证。如果编程 Agent 表现出用户沮丧的迹象,请检测出来。
Claude Code 泄露事件让这一点变得具体可见。多方报告发现,Claude Code 在 userPromptKeywords.ts 中使用正则表达式来检测用户提示中的沮丧词汇和短语。PCWorld 报道称,该正则表达式查找诸如 “wtf”、“horrible”、“awful” 和 “this sucks” 等术语。Slashdot 的摘要包含了相同的模式,而 Blake Crosley 的分析将此描述为基于正则表达式的沮丧检测,而非 LLM 推理。
从工程角度来看,这一模式具有启发意义。并非每个反馈信号都需要模型调用。如果一个廉价的规则能够捕捉到有用的信号,那就使用这个廉价规则——并明确说明该信号如何存储和使用。
你的可观测性平台需要什么
如果可观测性要驱动学习,平台需要具备三样东西。

首先,它需要存储追踪(traces)。这是基础层。你需要记录 Agent 行为的完整轨迹:模型调用、工具调用、输入、输出、元数据、时间耗时、错误以及中间状态。理想情况下,你可以从所使用的任何技术栈中摄取追踪数据,而不仅限于某一个框架。LangSmith 支持来自 30 多个不同框架的追踪,并且可以通过 OpenTelemetry tracing 从兼容 OpenTelemetry 的应用程序中摄取追踪数据。
其次,它需要存储反馈。反馈不应存在于与追踪脱节的独立电子表格或分析系统中。它应该直接附加到其所评估的运行(run)、追踪或线程上。这让你能够按反馈进行筛选,比较良好和糟糕的轨迹,从真实失败案例中构建数据集,并跟踪变更是否改善了关键行为。LangSmith 支持捕获反馈并将其与追踪关联。
第三,它需要生成反馈。部分反馈来自用户,但大量有价值的反馈应由系统自身产生。这包括规则、评估器、采样、标注队列、告警以及对历史追踪数据的回填。LangSmith 支持自动化规则和在线评估,其中包括在 production traces 上运行的 LLM-as-judge 评估器。
这就是 agent 团队所需的产品形态:存储 traces,存储 feedback,生成 feedback。
学习闭环依赖于 traces 加上 feedback
可观测性的目的不仅仅是查看 traces,而是从中学习。
Traces 告诉你发生了什么,feedback 告诉你这意味着什么。两者结合,让你能够改进模型、harness 和 context。它们支持人工调试和自动化评估,并将生产环境中的行为转化为数据集、规则、告警和回归测试。
没有 feedback 的 agent 可观测性是不完整的。你可以检查行为,但无法系统地从中学习。
要充分发挥 agent 可观测性的价值,请将 feedback 与你的 traces 一起存储。这正是将 agent traces 从日志转变为学习系统的关键。

了解你的 agent 实际在做什么
LangSmith 是我们的 agent 工程平台,帮助开发者调试每一个 agent 决策、评估变更并一键部署。