Anthropic 称 AI 将 AMD 芯片迁移周期从数月压缩至 3 天
Anthropic 联合创始人 Tom Brown 称,公司已通过多芯片战略摆脱对英伟达的单一依赖,将 Claude 的训练与推理分散在四大芯片家族上,并视为统一可互换的算力池。其前沿模型 Mythos 在迁移至 AMD GPU 时几乎自主完成近 100% 的算子内核编写与移植,耗时仅 3 天,而传统流程需 6 至 12 个月。此举直接冲击英伟达 CUDA 生态的核心护城河,Anthropic 还计划部署最高 2 吉瓦的 AMD Instinct MI455X 算力。
报道正文
本文目录4 个章节
Anthropic 称 AI 正在削弱 Nvidia 的 CUDA 优势,将 AMD 芯片切换时间从数月缩短至三天
[Matthias Bastian](https://the-decoder.com/author/matthias-bastian/) [查看 Matthias Bastian 的 LinkedIn 个人资料](https://www.linkedin.com/in/matthias-bastian-128b71b1/) 2026年11月11日 
由 THE DECODER 提示 Nano Banana Pro 生成
要点
-
Anthropic 声称已通过多芯片策略摆脱了对 Nvidia 的依赖。
-
据联合创始人 Tom Brown 称,该公司现在在全部四大芯片系列上训练和运行 Claude,并将它们视为一个单一、可互换的计算资源池。
-
在移植到 AMD GPU 时,Anthropic 自家的前沿模型 Mythos 自行编写或移植了近 100% 的内核,据报道仅用了三天,而非通常的六到十二个月。
文本 询问关于本文的问题…… 搜索
Anthropic 声称已通过多芯片策略摆脱了对 Nvidia 的依赖。该公司表示,它仅用三天就将自家 AI 模型 Claude 移植到了 AMD GPU 上,几乎无需人工干预。
Nvidia 最大的竞争优势在于硬件与软件的结合,尤其是 CUDA——这个将开发者锁定在 Nvidia 芯片上的软件生态。将 AI 模型移植到其他芯片架构需要付出巨大努力,以至于许多公司甚至不愿尝试。Anthropic 现在在一份投资者演示中声称,它已利用 AI 本身解决了这一问题。
据 Anthropic 联合创始人兼首席计算官 Tom Brown 称,该公司现在在全部四大芯片系列上训练和运行 Claude。Anthropic 早在大多数业内人士认为这种努力不值得的时候就做出了“非常规押注”,押注多芯片策略。每种芯片都需要自己的定制软件和推理栈,这既昂贵又耗时。但 Brown 表示,Anthropic 多年来一直在这项工作上投入,并且已经变得“极其擅长”。
Anthropic 利用 AI 将 Claude 移植到 AMD
该公司最具体的测试来自 AMD GPU。到目前为止,搭建一个新的芯片平台需要数十名工程师忙碌数月。今年,Anthropic 首次使用 AMD GPU,并让其自家的前沿模型 Mythos 来完成这项工作。据 Anthropic 称,Claude 仅用三天就在 AMD 上运行起来,几乎无需人工干预。该模型自行移植或编写了近 100% 的内核。
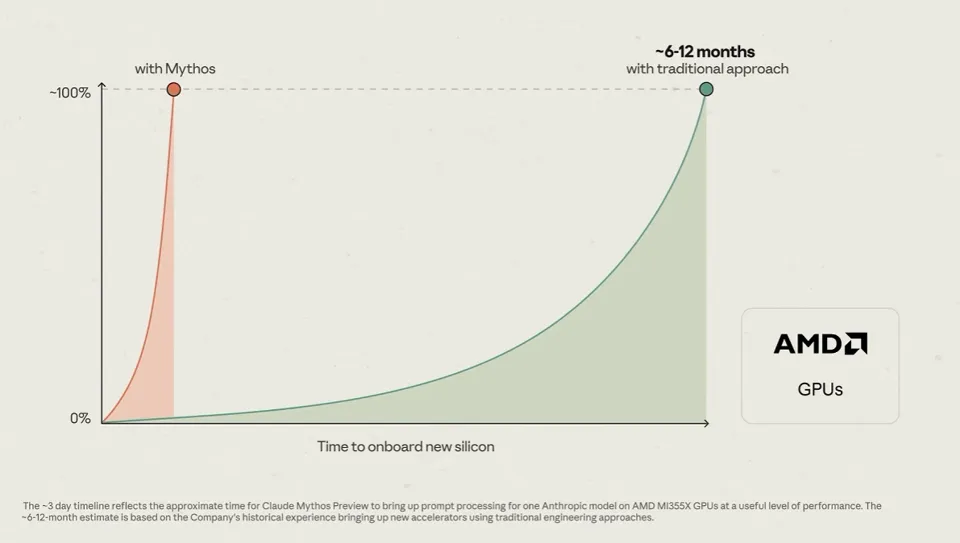
借助 Mythos,Anthropic 能在约三天内将新硬件提升到可用的性能水平,而传统工程方法需要六到十二个月才能完成新加速器的适配。这些数据指的是 Anthropic 模型在 AMD MI355X GPU 上的提示处理性能。| 图片:Anthropic
如果这些数据准确,那么长期以来被视为 Nvidia 最强竞争优势的软件开销,将因 AI 而大幅缩小。企业可以更轻松地在芯片供应商之间切换,选择最实惠或最容易获得的方案。
在供应紧张的计算市场中,多芯片策略让企业能够专注于最佳的性价比,而不必拘泥于供应商。有些芯片更适合训练,另一些则更适合推理。而由于在 AI 芯片市场的主导地位,Nvidia 目前享有超过 70% 的利润率,这对硬件行业来说高得不寻常。
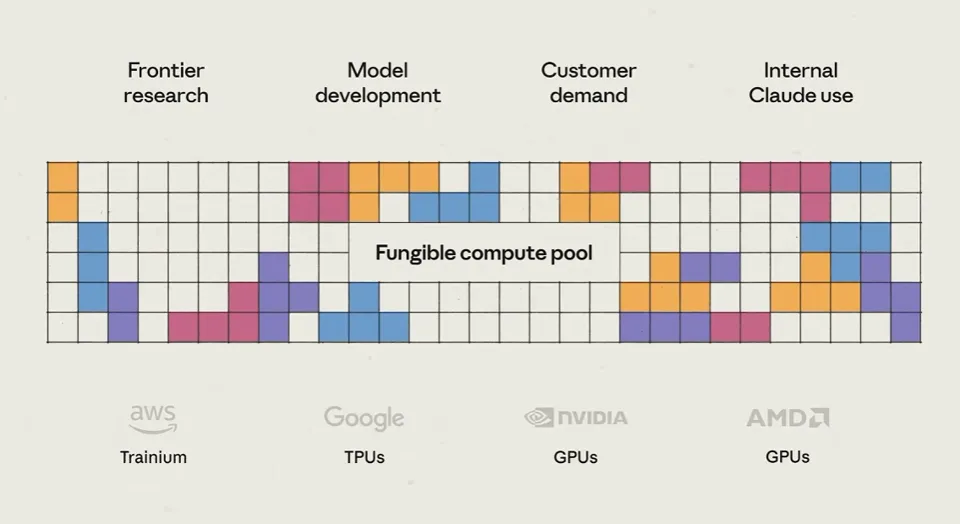
Anthropic 从一个可互换的计算池中分配算力,覆盖四个硬件平台——AWS Trainium、Google TPU、Nvidia GPU 和 AMD GPU——用于研究、模型开发、客户需求和内部 Claude 使用等任务。| 图片:Anthropic
Anthropic 将来自不同供应商、不同芯片架构和不同地点的算力视为一个可互换的资源池。该公司表示,其每一美元算力所带来的产出超过任何其他前沿 AI 实验室。
计算倍增器旨在扩大领先优势
除了多芯片策略之外,Anthropic 还依赖其所谓的计算倍增器——即从相同的物理算力中榨取更多性能的研究突破。据 Anthropic 称,这些倍增器层层叠加,使每一项新突破都能放大前一项的效果。
最终,Claude 应该能够自行发现这样的计算倍增器。那将等同于递归自我改进,这一概念在 AI 研究中备受争议,但尚未得到证实。
Anthropic 还通过“Anthropic Direct”计划建设自己的数据中心容量。该公司不再仅仅以云服务的形式购买算力,而是租赁芯片并在专门建造的数据中心中运营这些芯片。目标是降低总拥有成本。
这些数字来自 Anthropic 的投资者演示文稿,尚未经过独立核实。但它们表明,至少有一家大型 AI 实验室不再认为 Nvidia 的 CUDA 主导地位不可逾越,并且 AI 模型本身可能成为打破硬件依赖的工具。
两家主要 GPU 制造商现在都与 Anthropic 有着深厚的财务联系。2025 年 11 月,作为与 Microsoft 达成的 450 亿美元交易的一部分,Nvidia 承诺向 Anthropic 投资最多 100 亿美元。根据 Anthropic 于 2026 年 11 月 10 日向 SEC 提交的 S-1/A 注册声明,Nvidia 还参与了一项总额 260 亿美元的有条件私募配售,其中七家科技公司按 IPO 价格认购股份。
AMD 于 2026 年 7 月宣布了一项最高 50 亿美元的战略投资;作为回报,Anthropic 计划在 Helios 机架级系统中部署最多两千兆瓦的 AMD Instinct MI455X GPU,第一阶段一千兆瓦将于 2027 年上半年开始。