Google 提出 Agile Deliberation 用 LLM 优化主观图像分类
Google Research 推出“Agile Deliberation”框架,旨在解决 AI 图像分类器在主观类别定义上的难题。该框架通过交互式审议工作流引导用户界定子类别并处理边缘案例,并利用 LLM 驱动的优化循环自动构建高准确率且符合人类意图的分类器。
报道正文
本文目录12 个章节

敏捷审议:AI 如何帮助人类界定灰色地带
2026 年 11 月 4 日
Otilia Stretcu(研究科学家)与 Leijie Wang(学生研究员),Google Research
“敏捷审议”(Agile Deliberation)旨在解决为主观类别构建 AI 图像分类器所面临的挑战。它通过引导用户完成交互式审议工作流——从界定子类别到解决边缘案例——并利用由 LLM 驱动的优化循环,自动构建出准确且符合预期的分类器。
快速链接
机器学习模型通过学习人类标注的示例来识别周围的世界。这一过程隐含了一个前提假设:标注者在开始之前,心中已对目标类别拥有清晰且稳定的定义。当训练模型处理客观类别时(例如停车标志或金毛寻回犬),由于边界清晰且具备普遍共识,这一假设成立良好。然而在实际应用中,现实场景往往要求视觉系统应对人类经验中主观的“灰色地带”。例如,考虑训练一个视觉分类器以识别“健康食品”、策展“鼓舞人心的艺术品”,或辅助内容审核。在这些领域,类别边界并非普适或静态,因为它们可能随文化背景、个人理念或不断演变的运营策略而改变。此外,人们很少在主观概念上拥有一份完整的规范说明,即便是在他们自己的脑海中也是如此。相反,他们通常始于对概念的直觉认知,只有在接触真实世界的示例时,才逐渐发现该概念真正的边界、例外情况和细微差别。传统的训练工作流并未考虑到这种概念演化,迫使用户在自身心智模型仍在变化时,向 AI 系统提供僵硬的标签。
为了弥合这一差距,我们推出了 Agile Deliberation,这是一个将主观 AI 分类器的创建视为迭代对话过程的框架。Agile Deliberation 不再要求人类充当静态的数据标注员,而是将 AI 系统转变为一个协作伙伴,帮助用户“审议”并完善他们自己的定义。通过首先解决人类的模糊性,该框架系统地构建了更有效、更鲁棒且更符合对齐要求的 AI 系统。为了支持更广泛的研究社区,我们还在 GitHub 上开源了底层代码和算法。
这项工作的一个关键差异化优势在于其对实时用户体验的关注。由于标准的静态 AI 基准测试无法捕捉主观概念,我们绕过了模拟测试,在 18 场与人类参与者进行的、每场时长 1.5 小时的实时会话中评估了 Agile Deliberation。这使我们能够直接观察并测量当人与智能系统配对时,其意图是如何动态演变的。我们发现,Agile Deliberation 通过用对边缘图像的直接反馈取代手动提示工程(prompt engineering),大幅降低了用户的疲劳感和焦虑感,从而产生了比标准基线性能更一致、更高的 AI 模型。
工作原理:审议的两个阶段
Agile Deliberation 将定义主观概念这一复杂任务拆分为两个结构化阶段:概念界定(concept scoping) 和 概念迭代(concept iteration)。这两个阶段共同作用,将一个模糊的想法转化为针对 AI 模型的高度精确的指令蓝图。
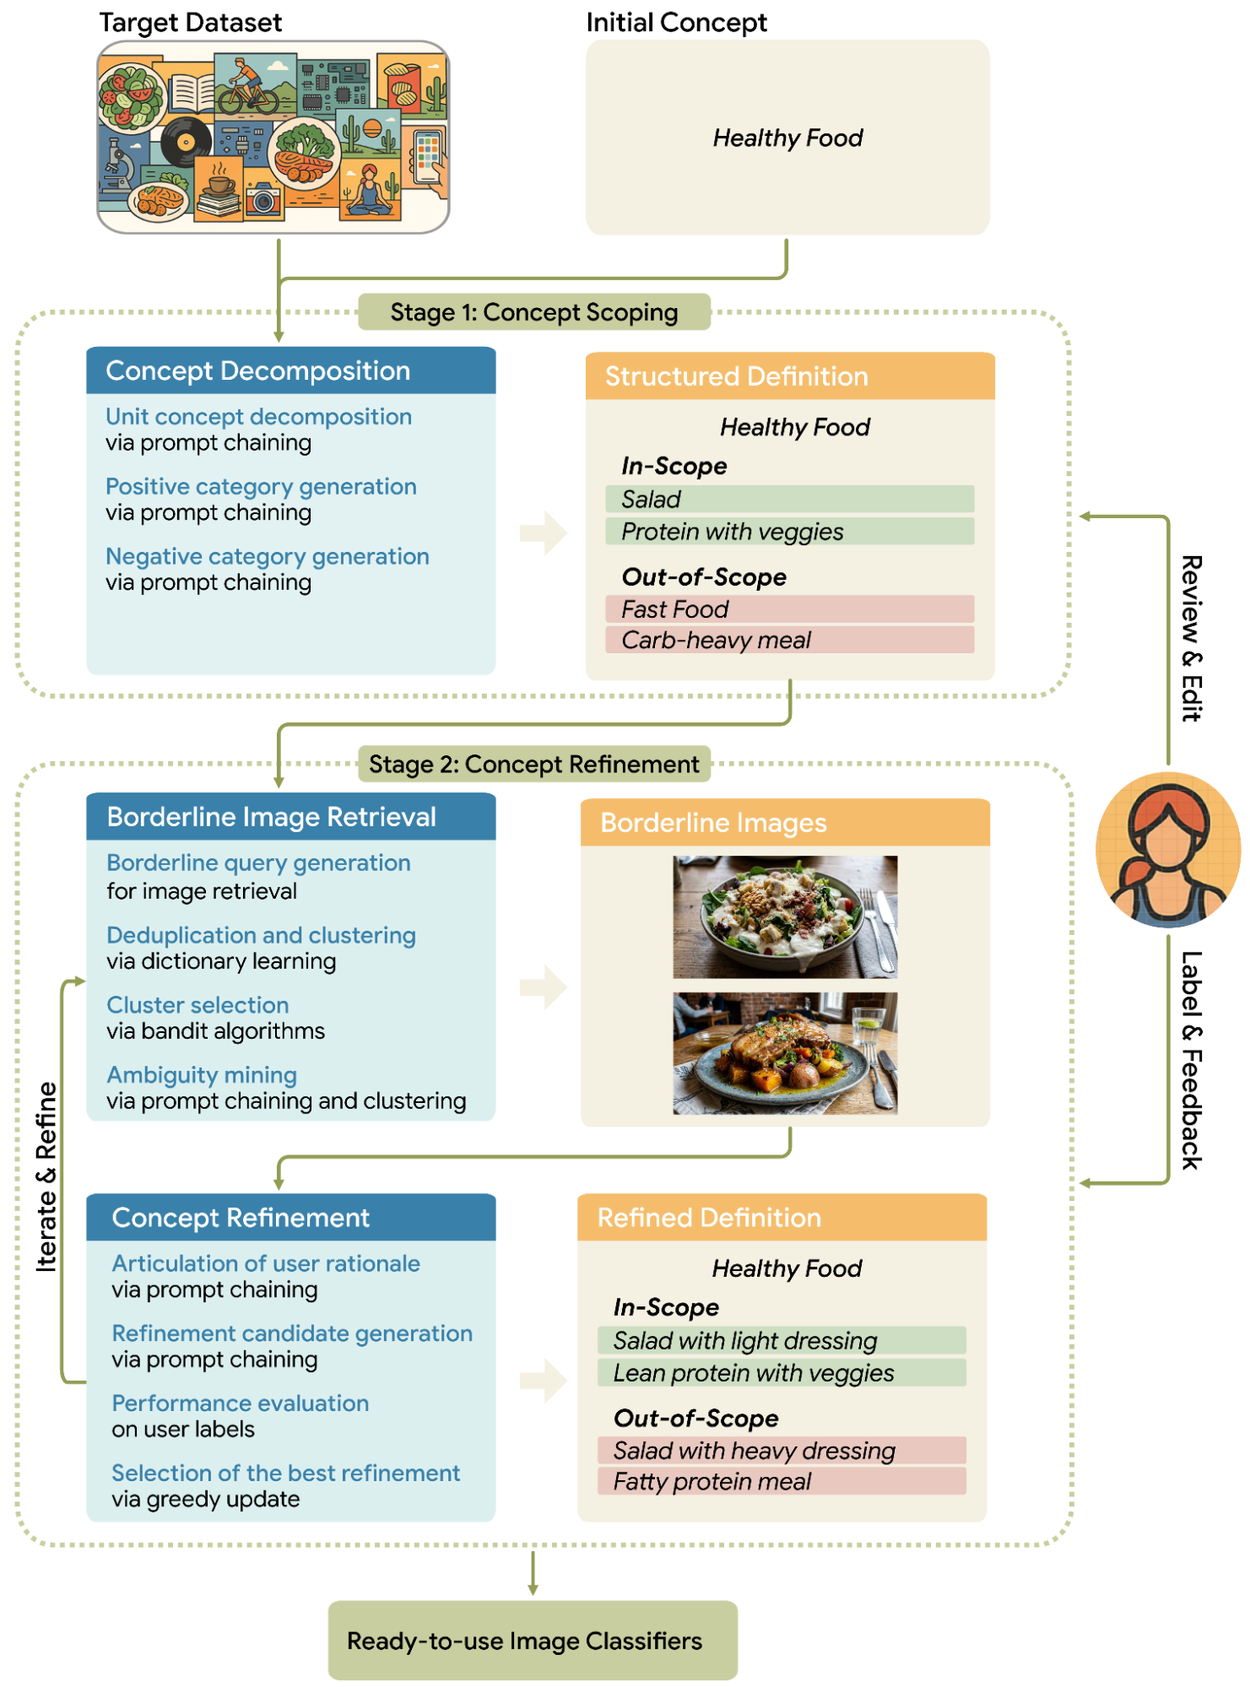
Agile Deliberation 的工作流程。该框架将一个宽泛的目标概念分解为范围内定义(即分类器应识别并标记为符合用户意图的正样本)和范围外定义(即用户希望分类器不要标记的显式负边界或“误报”),检索边缘图像以暴露极端情况,并将人类反馈引导至自动提示优化循环中,以生成可直接使用的图像分类器。
阶段 1:概念界定
面对“健康食品”这类宽泛主题时,人类的直觉往往难以预先列出所有规则。在概念界定阶段,系统会引导用户将总体概念拆解为结构化的子概念层级和明确的排除项。
例如,用户不会仅使用一个宽泛的标签,而是可能将“健康食品”分解为“沙拉”、“谷物碗”和“瘦肉蛋白”等正面子类别。同时,他们可能会定义明确的排除项,如“加工食品”或“未经处理的生鲜食材”。这建立了一个初始的结构化基准,从而夯实模型的理解基础。
第二阶段:概念迭代
在初步结构建立之后,框架从静态规划转向主动测试。传统机器学习假设人类标注员是一个已经心中拥有完整且明确定义的规则集的“神谕”(oracle)。Agile Deliberation 颠覆了这一前提,转而聚焦于协作式精炼。
该阶段的灵感来源于主动学习(active learning),这是一种传统上用于检索信息量大的数据点以最大化机器训练效率的方法。然而,与主动学习纯粹为了最小化机器不确定性而选择样本不同,Agile Deliberation 利用视觉-语言模型(VLMs)主动挖掘并呈现那些挑战当前基于文本定义的语义边界图像。
例如,系统可能会展示一张水果冰沙的图片来挑战“健康饮食”的概念,迫使用户做出决定:这是含有生水果的健康饮品,还是因含糖量高而被排除的加工食品?
直面这些模糊的边缘案例促使用户反思自己隐藏的假设,澄清真实意图,并相应地更新策略规则。随后,这些人类反馈被直接引入自动提示优化循环,确保 VLM 的分类边界随着用户精确定义的调整而同步移动。
实验
评估主观视觉分类器是一项根本性挑战:由于不存在静态、客观的基准真值(ground truth)来衡量性能,因此在预标注数据集上进行的离线评估无法衡量框架在用户概念心智模型随审议过程发生变化时的适应能力。
为了捕捉这种动态变化,我们构建了一个功能原型,并通过一项实时用户研究对其进行了评估。我们共开展了 18 场实时用户会话,每场持续 1.5 小时。参与者以随机顺序与我们的系统及替代基线进行交互,以防止学习偏差。
我们选择了两个复杂且高度主观的领域来测试这些系统的极限:
- 健康食品:在该领域中,个人健康理念、饮食限制和文化背景会产生高度多样化且主观的观点。
- 付费游玩(Pay-to-Play):这是一项现实世界的内容审核挑战,需要捕捉专家级的细微差别和特定语境。这涉及识别在线娱乐或游戏领域中那些承诺误导性财务或数字奖励的点击诱饵图像。
我们将敏捷审议(Agile Deliberation)与三种常见的不同范式进行了对比评估:
- 零样本分类器(Zero-shot classifiers):标准的“一次性”方法。用户编写初始提示词,但无法查看边缘案例,也无法在模型误解边界时进行调整。
- 建模协作者(Modeling collaborator):一种自动化的自上而下方法,由 AI 代理尝试自行分解概念。虽然它能自动生成标准,但将用户排除在循环之外,导致用户无法引导或纠正其逻辑。
- 手动审议:繁琐、暴力的现状流程,用户在电子表格中检查数据,猜测搜索查询以寻找异常,并手动重写原始提示词。
结果
实时用户会话表明,敏捷审议不仅能生成性能更高的分类器模型,还显著改善了用户体验。
提升一致性与性能
我们发现,参与结构化审议过程的研究对象在时间推移中表现出显著更高的标注一致性。通过尽早解决边界模糊问题,他们构建的分类器性能大幅超越了所有标准基线模型。这些性能提升在最棘手的主观图像上尤为显著——而这正是传统分类器通常失效的领域,因为它们依赖默认的、通用的 AI 假设,而非用户明确且细微的意图。
消除盲区
专家参与者反馈称,该系统充当了有效的诊断工具。通过有意呈现令人困惑的边缘案例图像,AI 系统帮助他们发现了初始定义中的“盲区”——揭示了他们在面对模糊的真实世界示例之前未曾预料到的场景。
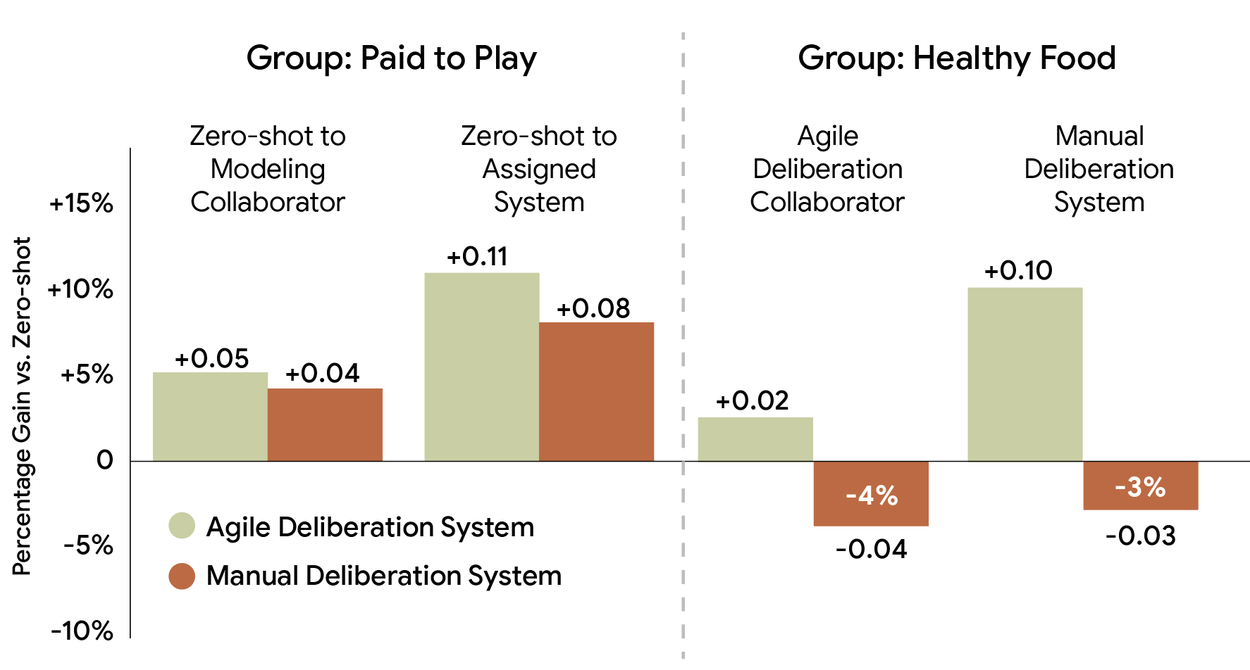
跨任务分类器性能增益***。***在“Pay-to-Play”和“Healthy Food”评估组中,敏捷审议(Agile Deliberation)框架相较于零样本基线均能带来一致的性能提升,而人工审议方法往往无法改善甚至降低分类器准确率。
缓解认知疲劳
我们现场研究的一个关键发现是人工提示工程带来的认知负担。研究表明,当用户在人工概念审议过程中试图预测可能揭示边缘案例的搜索词时,会经历明显的认知疲劳。此外,他们报告称存在持续的焦虑感:手动调整文本提示以修复一个错误,可能会无意中损害分类器其他已修正部分的表现。
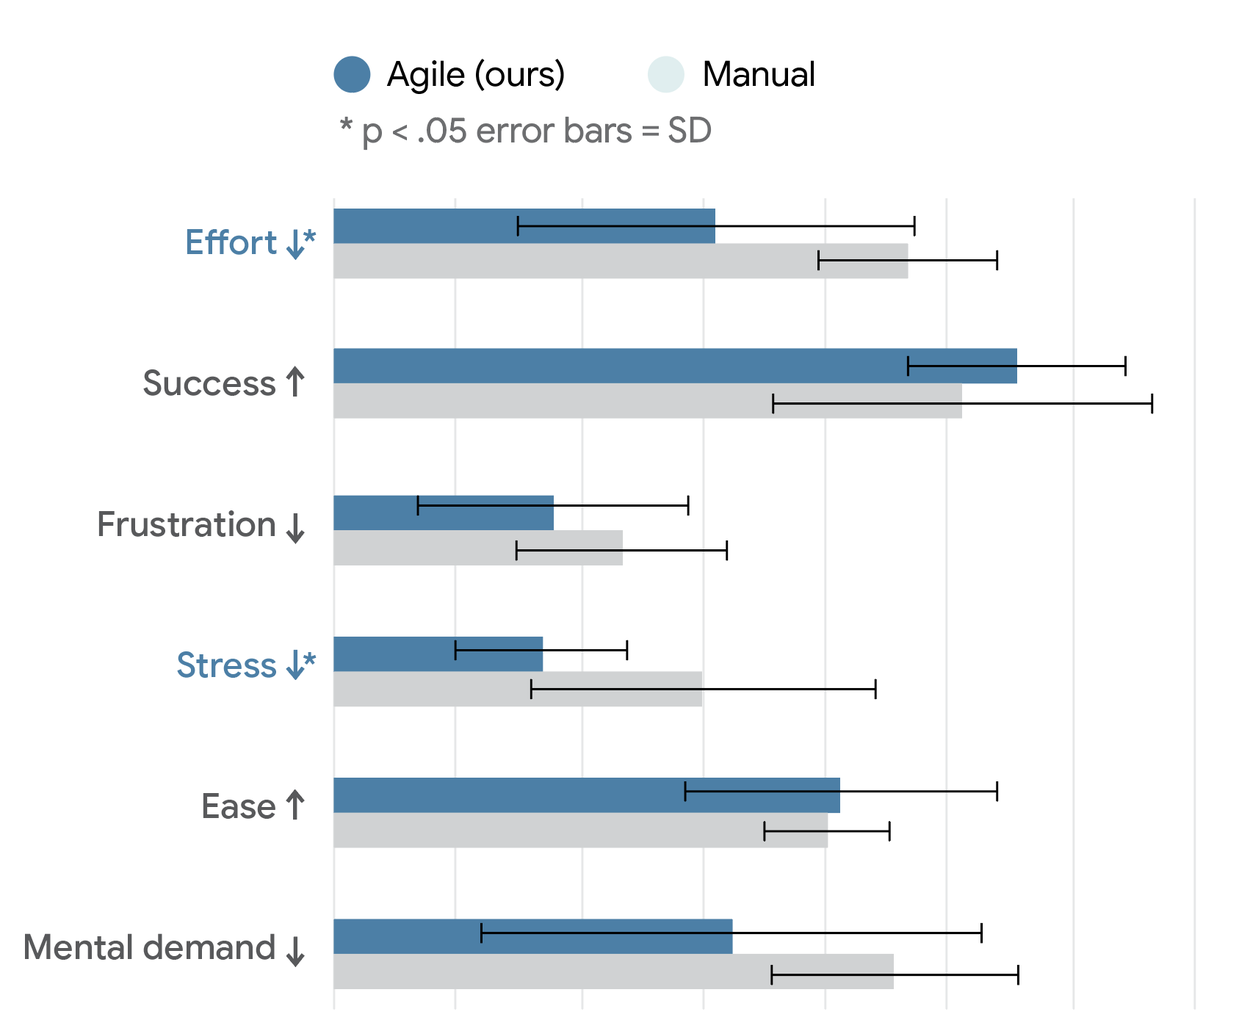
用户体验与认知负荷指标**。** 与传统的人工提示工程相比,使用敏捷审议框架的参与者报告所需的努力程度和压力水平有统计学意义上的显著降低,同时心理需求更低,感知成功率和易用性更高。
Agile Deliberation 通过承担繁重的计算任务来解决这一摩擦。用户无需成为提示词工程师;他们只需查看经过精心筛选的边界图像画廊,并提供自然语言反馈即可。系统能够无缝吸收用户的意图,并自动更新底层模型。
结果显示,使用 Agile Deliberation 的参与者报告称压力显著降低、挫败感减少且精神消耗更少,所有参与者均表示更偏好 Agile Deliberation 而非手动方法。
结论
最终,Agile Deliberation 将人机协同机器学习(human-in-the-loop machine learning)的范式从单向通道——即 AI 系统仅从人类标签中学习——转变为双向协作模式,在此模式下,人类与 AI 共同完善概念。
随着机器学习系统越来越多地被部署用于处理复杂的社会现实任务,确保其决策边界能够反映细微的主观概念至关重要。无论是赋能信任与安全团队构建更安全的内容审核过滤器,帮助策展人塑造数字收藏,还是协助科学家对复杂的视觉数据进行分类,Agile Deliberation 都为实现人机对齐提供了基础。
如需了解更多关于底层主动学习技术以及我们范围界定和聚类算法的技术实现细节,请阅读我们的论文,并在 GitHub 上查看开源实现。若要开始使用,请参阅我们的交互式 Colab/Jupyter 演示,以逐步体验本文中展示的“健康食品”示例。随后,您可以将其适配到您作为领域专家的任何场景(例如标记误导性标题党),或利用它围绕您个人的主观品味和标准构建个性化分类器(例如策划“鼓舞人心的艺术作品”)。
致谢
我们衷心感谢我们的合作者——Wei Qiao、Thomas Denby、Krishnamurthy Viswanathan、Enming Luo、Chun-Ta Lu、Tushar Dogra、Ranjay Krishna 和 Ariel Fuxman——他们为本研究及配套论文提供了宝贵的见解与贡献。这项研究的开展得益于 Google Research 与 Google Ads 之间的紧密合作。