InfoQ 中文 · 2026/10/15 10:39:41
KAN 一作刘子鸣创立元环智能获数亿融资:研发元模型以预测架构性能替代试错式 AI 设计
由 KAN 架构提出者、清华助理教授刘子鸣创立的元环智能在成立半年内完成种子及种子+轮融资,累计金额达数亿元。公司核心方向是开发“元模型”,旨在通过学习架构配置与训练表现的关系,在完整训练前预测模型性能,从而辅助自动架构搜索并降低算力试错成本。
报道全文原始报道全文
本文目录3 个章节
成立不到半年的 AI 创业公司元环智能(MetaCircle),宣布连续完成种子轮和种子+轮融资,累计融资金额达数亿元。
据公司提供的信息,种子轮由顺为资本领投,上海未来产业基金、星连资本、君礼资本等机构跟投;种子+轮投资方包括上海半导体产投、360 战投、首程资本、上海人工智能产业系列基金,以及 BV 百度风投、山行资本、云时资本等。新一轮融资将主要用于核心算法研发、阶段性产品探索、团队扩充,以及相关评测基准的建设。
元环智能成立于 2026 年 5 月,创始人刘子鸣生于 1998 年,现任清华大学人工智能学院助理教授,毕业于北京大学物理系,获得麻省理工学院物理学博士学位,曾在斯坦福大学从事博士后研究。
在 AI 研究领域,刘子鸣最为人熟知的成果是 2024 年参与提出的 Kolmogorov-Arnold Networks(KAN)。这一神经网络架构通过在连接边上引入可学习的一元函数,探索传统多层感知机之外的函数表示方式,并因其在可解释性和科学计算方面的潜力受到关注。
从神经网络架构研究转向创业,刘子鸣现在希望解决一个更加基础的问题:设计 AI 模型这件事,能不能也交给 AI?
不直接解决任务,而是学习如何设计模型
近年来,大语言模型已经能够帮助研究人员编写训练代码、调整实验参数、运行评测,甚至在一定程度上自动开展机器学习研究。但目前很多自动科研系统仍然需要通过反复实验,才能判断某个模型设计或训练策略是否有效。
元环智能希望尝试另一种路径。元环正在研究的“元模型”(Meta Model),并不是一个直接执行文本生成、图像识别等任务的通用模型,而是试图学习不同模型架构、训练配置与实验表现之间的关系,进而预测一个模型的训练表现,并辅助研究人员选择和设计更合适的架构。
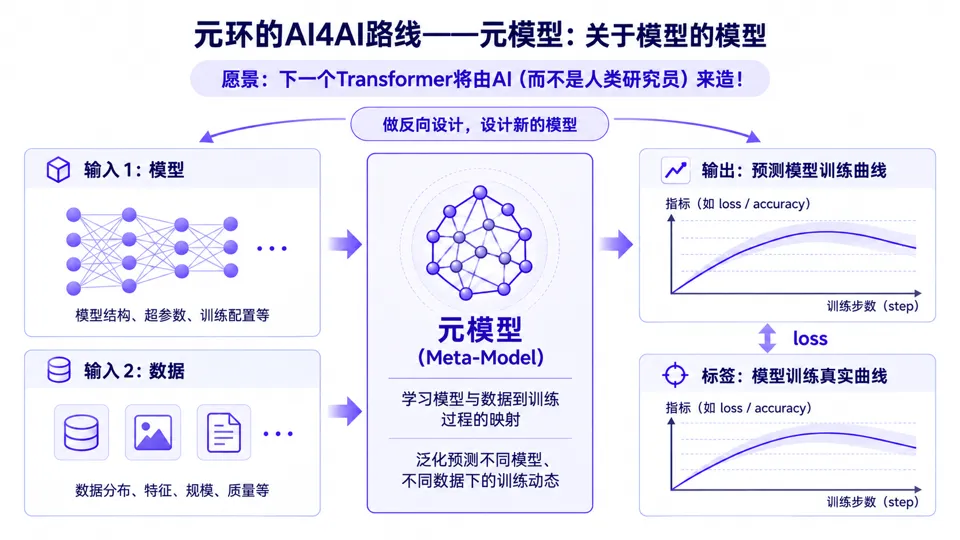
按照元环披露的研究思路,研究团队可以生成不同的神经网络架构与训练配置,运行实验并记录相应的训练曲线,再利用这些配对数据训练元模型。
例如,面对一个新的候选神经网络架构,元模型希望在尚未完成完整训练时,就能够预测其损失函数和性能指标可能如何变化。如果预测足够准确,研究人员便有机会提前排除表现较差的方案,将计算资源集中在更有潜力的模型上。
进一步地,元环希望将这种预测能力用于自动架构设计:针对不同任务的特点,生成并筛选适合该任务的专用模型。这一方向与神经架构搜索(NAS)、自动机器学习(AutoML)以及模型性能预测等既有研究存在关联。元环的长期目标,则是让模型设计经验能够在不同任务、不同架构之间迁移,减少对研究人员逐项试错的依赖。
不过,能够预测模型表现,与能够自主设计出更好的新架构,仍然是两个不同层次的能力。后者还涉及候选架构的生成、搜索与实际训练验证。
从训练表现预测到自动科研
围绕 AI 模型训练规律,元环已经公开了多项研究与工具。其中,Marin Hero Run 预测案例尝试在一次大模型训练尚未结束时,提前预测最终训练表现。元环公布的预测 Loss 为 2.034,而 Marin 项目自身通过 Scaling Ladder 方法得到的预测值为 2.039。
这两个预测结果较为接近,但预测之间的一致性并不等于预测准确。元环此前提供的研究资料也明确指出,该案例公开的是预测结果,并非训练完成后的最终实测成绩。元模型在更多架构和任务中的预测精度、泛化能力及计算成本优势,仍需进一步验证。
另一项值得关注的研究是 OPHIS,一套围绕模型训练机制展开的自动科研方法。
与单纯根据实验结果寻找更高分数的方案不同,OPHIS 试图将观察、提出问题、建立假设、实验干预和性能改进组织成一个研究过程。例如,当模型训练过程中出现某种异常或性能变化时,系统尝试分析可能的原因,并通过调整实验条件检验相关假设。
元环此前公开的实验涉及 Grokking 和 nanoGPT 训练任务,并报告在特定条件下找到能够改善训练表现的干预方案。不过,这些结果仍属于特定任务上的实验验证,能否迁移到更大规模、不同架构的模型训练中,还有待进一步研究。
此外,元环还发布了 ComfyResearch 和 nanoGPT Observable Library。前者通过可连接的图式节点组织模型、数据、训练和分析流程;后者则帮助研究人员观察权重、梯度、激活、注意力等训练过程中的内部信号。
这些项目共同指向元环所强调的 Science of AI:将 AI 模型自身作为科学研究对象,尝试从训练现象中发现和积累能够指导后续研发的规律。
先从时间序列模型切入
尽管长期目标是跨领域的模型架构设计,元环选择从能力边界较小的时间序列预测任务开始探索产品化。
时间序列广泛存在于工业设备监测、气象、电力需求、金融数据等场景中。不同任务虽然具有相似的数据格式,其背后的生成机制、预测目标和数据特征却可能存在明显差异。
在元环看来,这意味着不同场景未必适合采用相同的模型架构。公司希望通过元模型,为具体任务自动寻找更合适的预测模型,减少人工架构选择和参数调优的工作。
公司在融资材料中还披露了部分内部实验进展,包括在时间序列任务上找到优于 LSTM 基线的架构,以及在一项世界模型任务中取得性能提升。不过,相关实验的完整评测条件、指标定义和可复现结果尚未随本次材料提供,因此目前还难以判断这些提升的通用性。
按照元环披露的计划,公司希望在明年推出通用元模型 1.0,进一步探索跨场景的专用模型设计能力。此外,团队正在建设 Architecture IQ 评测基准,用于衡量模型或研究人员根据架构判断训练表现的能力。
对于这家刚成立数月的公司而言,当前值得关注的技术问题已经相当具体:元模型能否在未见过的架构和任务上准确预测训练结果,并将这种预测能力转化为可衡量的模型研发效率提升?这也将决定元环的研究能否从特定任务上的训练预测和自动优化,逐步走向更广泛的模型架构设计。
相关链接: