OpenAI 发布 GPT-6.2 Astra 与 Sol 两款新模型
OpenAI 推出 GPT-6.2 Astra 与 GPT-6.2 Sol 两款新模型,前者面向科学、法律、金融等高强度专业任务,后者主打日常快速响应,API 价格较前代下调 20%。在 Artificial Analysis 智能指数上 Astra 位列第二,仅次于 Claude Fable 5.2,但在性价比帕累托前沿上占据优势。
报道正文
本文目录8 个章节
OpenAI 发布 GPT-6.2 Astra 和 Sol,API 价格更低,部分基准测试有所提升
[Matthias Bastian](https://the-decoder.com/author/matthias-bastian/) [查看 Matthias Bastian 的 LinkedIn 个人资料](https://www.linkedin.com/in/matthias-bastian-128b71b1/) 2026年11月17日
由 THE DECODER 提示生成的 GPT-Image-2.6
要点
-
OpenAI 发布了两款新模型:GPT-6.2 Astra 和 GPT-6.2 Sol。它们与 Anthropic 的最佳模型不相上下,但价格要实惠得多。
-
Astra 专为科学、法律和金融领域的高要求专业工作而设计,而 Sol 则面向快速的日常任务。两者现已向 Plus、Pro、Enterprise 和 Edu 用户开放。Astra 的 API 价格比其前代低 20%。
-
在 Artificial Analysis 智能指数中,GPT-6.2 Astra 排名第二,仅次于 Anthropic 的 Claude Fable 5.2,但据 Artificial Analysis 称,它在性价比方面占据了帕累托前沿的主导地位。
文本 询问关于本文的问题… 搜索
OpenAI 发布了两款新的语言模型。GPT-6.2 Astra 面向高要求的专业工作,而 GPT-6.2 Sol 则为日常使用而打造。OpenAI 表示,两者在基准测试中均优于前代产品,且运行成本更低。
GPT-6.2 Astra 和 Sol 现已面向 ChatGPT Work 和 Codex 中的 Plus、Pro、Enterprise 和 Edu 用户开放。Pro-500 订阅者可以在两款模型上使用 Ultrafast 模式。Pro-200 订阅者首次也能获得 Ultrafast 访问权限,从 GPT-6.2 Sol 开始。
开发者可以通过 OpenAI API 访问这两款模型。OpenAI 表示,GPT-6.2 Astra 的 API 价格比其前代便宜 20%,为每百万输入 token 8 美元、缓存输入 0.40 美元、每百万输出 token 40 美元。GPT-6.2 Sol 保持 GPT-6.1 Sol 的定价,即每百万 token 输入 2 美元、缓存输入 0.10 美元、输出 10 美元。
OpenAI 称 Astra 是“全球最适合科学家的模型”,并大力宣传精美的幻灯片
OpenAI 训练 GPT-6.2 Astra 以更可靠地处理法律、金融和会计等领域的专业惯例。该公司表示,演示文稿会从模板中提取布局、颜色和排版,并精确匹配字体大小。幻灯片标题旨在抓住幻灯片的要点,而正文则聚焦于关键细节。
OpenAI 的公告重点强调了其模型的性价比。据 OpenAI 称,在测试多步骤专业工作流的基准 Agents' Last Exam 上,GPT-6.2 Astra 的得分比其前代 GPT-6 Astra 高出 5.2 分,而成本不到后者的三分之一。它以仅 5% 的成本领先 Anthropic 的 Claude Fable 5.2 达 5.5 分。只有 Google 的 Gemini 4 Carbon 在该基准上能与 Astra 匹敌。
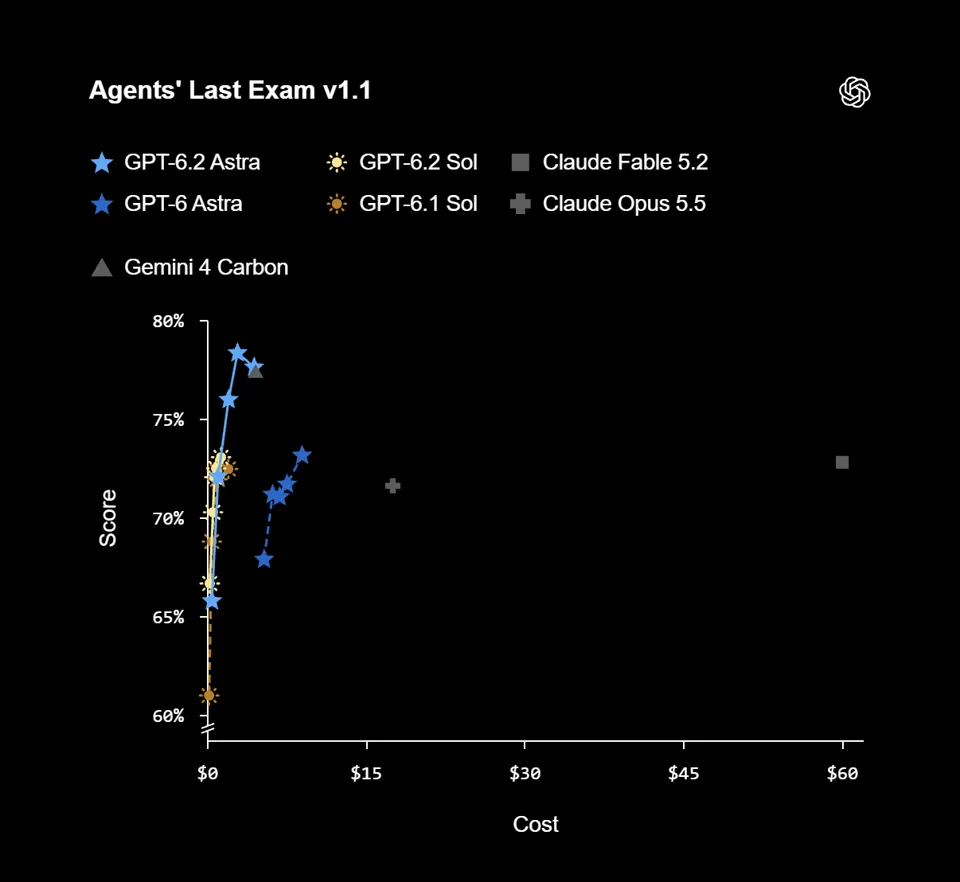
GPT-6.2 Astra 在 Agents' Last Exam v1.1 上以较低的每任务成本取得最高分。Claude Fable 5.2 达到相近分数,但每任务成本高出数倍。| 图片:OpenAI
据 OpenAI 称,在涵盖合同条款分析等任务的法律基准 Harvey LAB-AA 上,GPT-6.2 Astra 的通过率是 Claude Fable 5.2 的两倍多,而成本约为后者的六分之一。在包含咨询、金融和设计任务的内部基准 GDPval-v2 上,OpenAI 表示 Astra 比其前代提升了 6.2 个百分点,同时输出 token 用量减少了 22%。
OpenAI 表示,计算机使用能力——这已是前代模型的强项——又有了进一步提升。在测试中,该模型据称构建了一个 3D 汽车模型,用 Python 编写了一个物理求解器,并在 Blender 中为结果制作了动画。在另一个演示中,它逐个部件地为一辆遥控车建模,并生成了一份动画装配指南。
OpenAI 还声称其在网页设计方面取得了进展。在 3D 基准 AA-3D 上,由人类评委对两个盲测的交互体验进行比较。GPT-6.2 Astra 以 1,318 Elo 分位居第一,领先于 Claude Fable 5.2 的 1,271 分和 GPT-6.2 Sol 的 1,259 分。
据 OpenAI 称,在测试终端中科学工作流的基准 Terminal-Bench-Science 上,该模型的得分比 GPT-6 Astra 高出 9 个百分点,而成本同样不到后者的三分之一。OpenAI 表示,Astra 还在衡量模型解读生物数据和运行实验能力的 Vals Science Index 上创下新高。
Sol 以极低的成本几乎追平原版 Astra
OpenAI 表示,GPT-6.2 Sol 面向希望获得一款快速、多用途、适用于日常任务的模型的用户。在编码基准测试 FrontierCode 2.0 上——该测试用于检验代码变更是否达到真实项目的质量标准——Sol 仅落后 Astra 0.5 分,而成本只有后者的五分之一。OpenAI 称,该模型也能很好地处理非工作类任务。
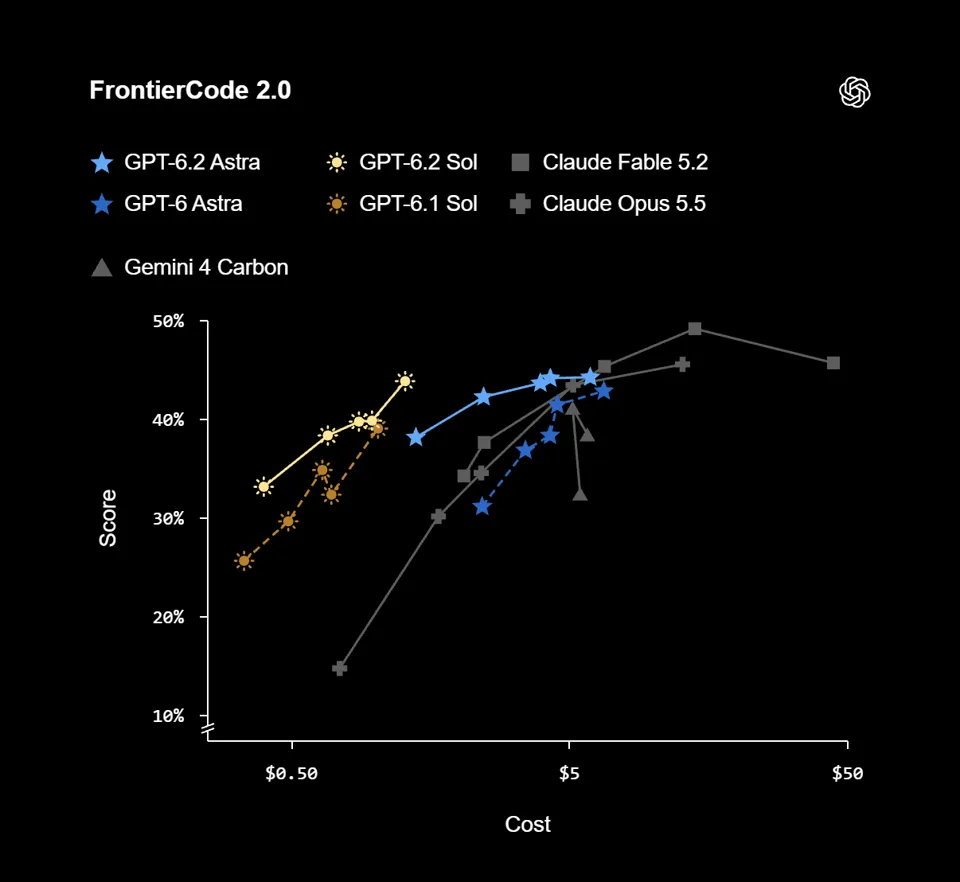
在编码基准测试 FrontierCode 2.0 上,GPT-6.2 Sol 的得分几乎与 GPT-6.2 Astra 持平,但成本仅为后者的一小部分。Claude Fable 5.2 取得了最高峰值分数,但每项任务的成本高出数倍。| 图片:OpenAI
据 OpenAI 称,GPT-6.2 Astra 和 Sol 在网络安全方面也有所提升。它们能更有效地发现和利用漏洞、编写更安全的代码,并提供更好的缺陷修复,在多项测试中 token 效率显著更高。这两款模型都达到了 OpenAI Preparedness Framework 中网络安全的“Critical”阈值,与此前的 GPT-6 Astra 相同。
作为回应,OpenAI 正在针对可能具有风险的网络安全请求增加更严格的防护措施。OpenAI 表示,这些防护措施应会使滥用更加困难,但也会限制合法的漏洞研究和安全测试。
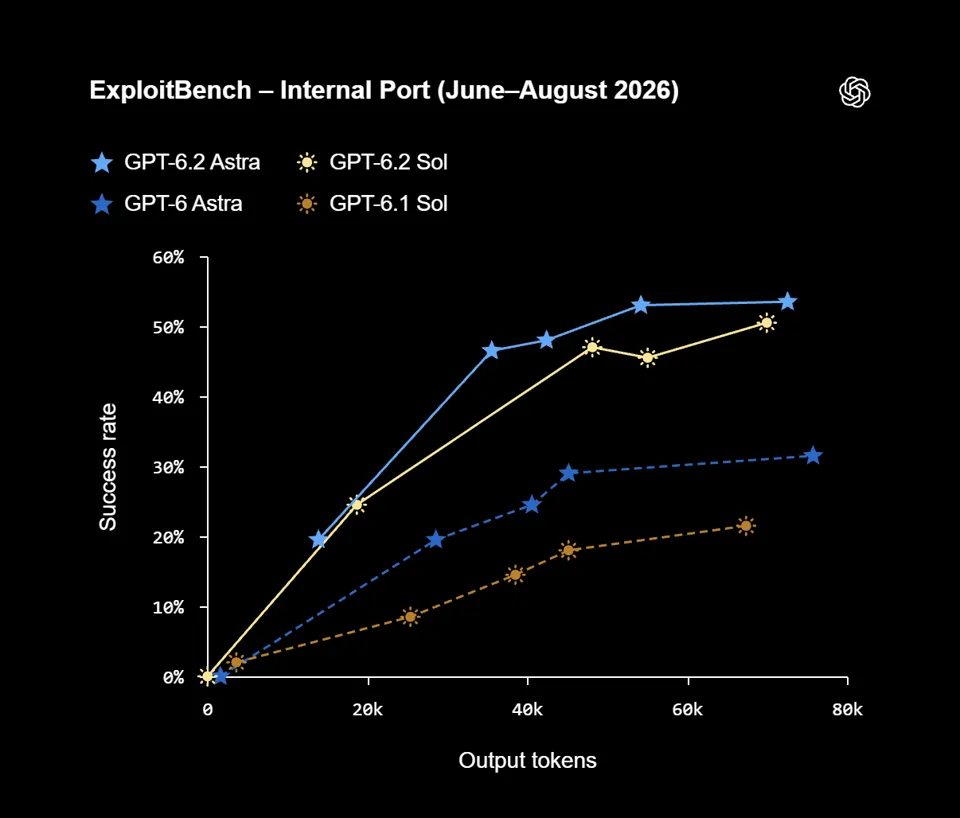
在内部 ExploitBench 测试中,模型必须将已知的浏览器漏洞转化为可用的漏洞利用程序。GPT-6.2 Astra 的成功率超过 50%,远超其前代 GPT-6 Astra。结果来自关闭防护措施后的测试。| 图片:OpenAI
OpenAI 计划通过 OpenAI Daybreak 提供这些新模型,该渠道已让经过审查的安全研究人员能够以更少的护栏访问其他模型。公布的网络安全基准数据来自关闭防护措施和分类器的内部测试。OpenAI 在随附的安全报告中阐述了其方法论。
Astra 在 Artificial Analysis 智能指数中排名第二
在 Artificial Analysis 智能指数中,该指数汇总了知识工作、编程、科学和常识四个领域的九项评估,GPT-6.2 Astra 位列第二,仅次于 Anthropic 的 Claude Fable 5.2。据 Artificial Analysis 称,Astra 比 GPT-6 Astra 提升了五分,超过了 Google 的 Gemini 4 Carbon(60 分)和 Anthropic 的 Claude Opus 5.5(59 分)。GPT-6.2 Sol 提升两分达到 57 分,与 GPT-6 Astra 的水平持平,但每任务成本仅约为后者的 15%。
据 Artificial Analysis 称,OpenAI 在成本与性能的帕累托前沿上占据主导地位——即没有其他模型能同时做到更便宜且更优的那条线。只有 Anthropic 和 Meta 的模型也出现在该前沿上。在按每任务输出 token 数衡量的效率方面,OpenAI 同样占据了大多数靠前位置。Claude Fable 5.2 是唯一出现在该榜单上的外部模型。
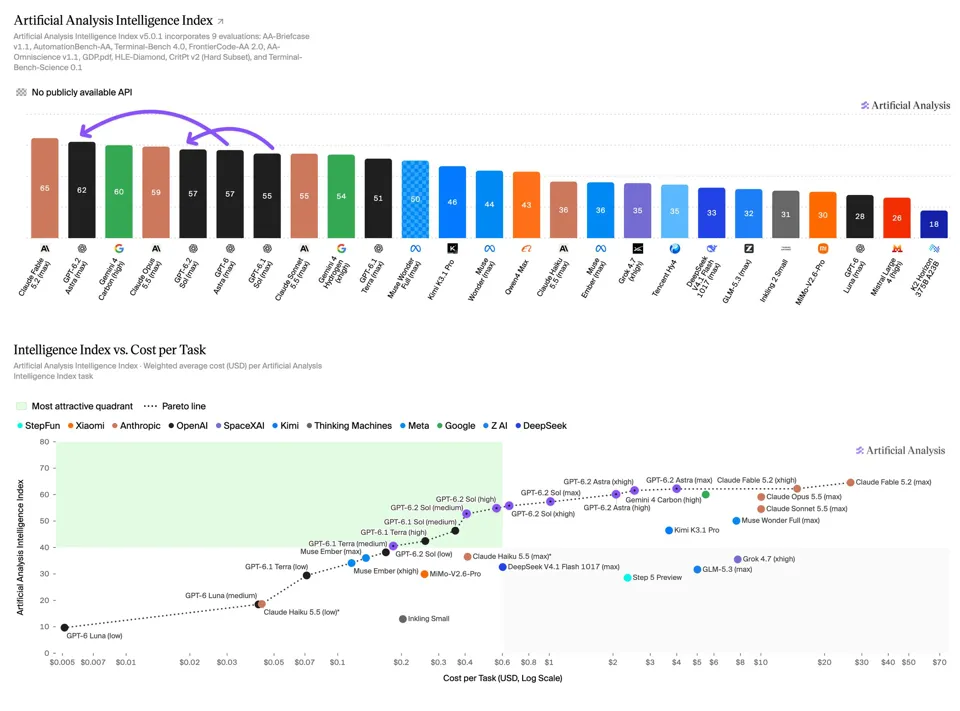
GPT-6.2 Astra 达到 62 分,在智能指数中位列第二,仅次于 Claude Fable 5.2(65 分)。OpenAI 模型在成本性能的帕累托前沿上占据主导。| 图片:Artificial Analysis
Artificial Analysis 在科学和事实知识方面印证了 OpenAI 的说法。GPT-6.2 Astra 在 Terminal-Bench-Science 0.1 上领先,并在物理推理测试 CritPt v2、事实知识基准 AA-Omniscience 和知识基准 HLE-Diamond 上位列第二,仅次于 Claude Fable 5.2。Astra 还在 3D 设计(AA-3D)和机器人技术(AA-Robotics v0.1)方面领先,机器人技术得分为 79 分,而 Sol 为 78 分,Claude Fable 5.2 为 75 分。
不过,编程方面则是另一番景象。据 Artificial Analysis 称,两款模型在该领域均已停滞不前。在 Coding Agent Index 中(使用 Codex harness 在最大算力下测量),GPT-6.2 Astra 与 GPT-6 Astra 持平。GPT-6.2 Sol 实际上比 GPT-6.1 Sol 下降了三分。这一下滑源于 SWE-Atlas-QnA-AA 上 14 分的跌落——该模型比其前代更频繁地在回答中遗漏关键事实。
Artificial Analysis 还指出其幻觉率偏高。在最大努力模式下,GPT-6.2 Astra 的幻觉率为 59%,Sol 为 55%。该指标名为 AA-Omniscience Hallucination Rate,衡量的是模型在事实性问题上猜测而非承认自己不知道的频率。这些问题异常困难,因此这些数字并不反映日常的幻觉率。
Epoch AI 发现 Astra 与 Fable 5.2 持平,但在真实世界任务上较弱
研究机构 Epoch AI 在发布前对 GPT-6.2 Astra 进行了测试,使用的是其自有基准。该模型在 Epoch Capabilities Index(ECI)中得分 174 分,与 Anthropic 的 Fable 5.2 持平。据 Epoch AI 称,两款模型都超出了 Astra 之前推理模型趋势线所预测的水平。
在取自 Epoch AI 自身研究的真实世界任务中,Astra 落后于 Fable 5.2,且相比 GPT-6 Astra 几乎没有提升。据 Epoch AI 称,该模型在较简单的研究项目中偏离了核心问题,并徒劳地试图修补。在一项关于研究 AI 数据中心的任务中,Astra 过于保守,跳过了关键估算,Epoch AI 表示这是任何承包商都无法蒙混过关的。Epoch AI 评价 Astra 的写作相比其他受测模型相对较强,但仍低于其自身标准。
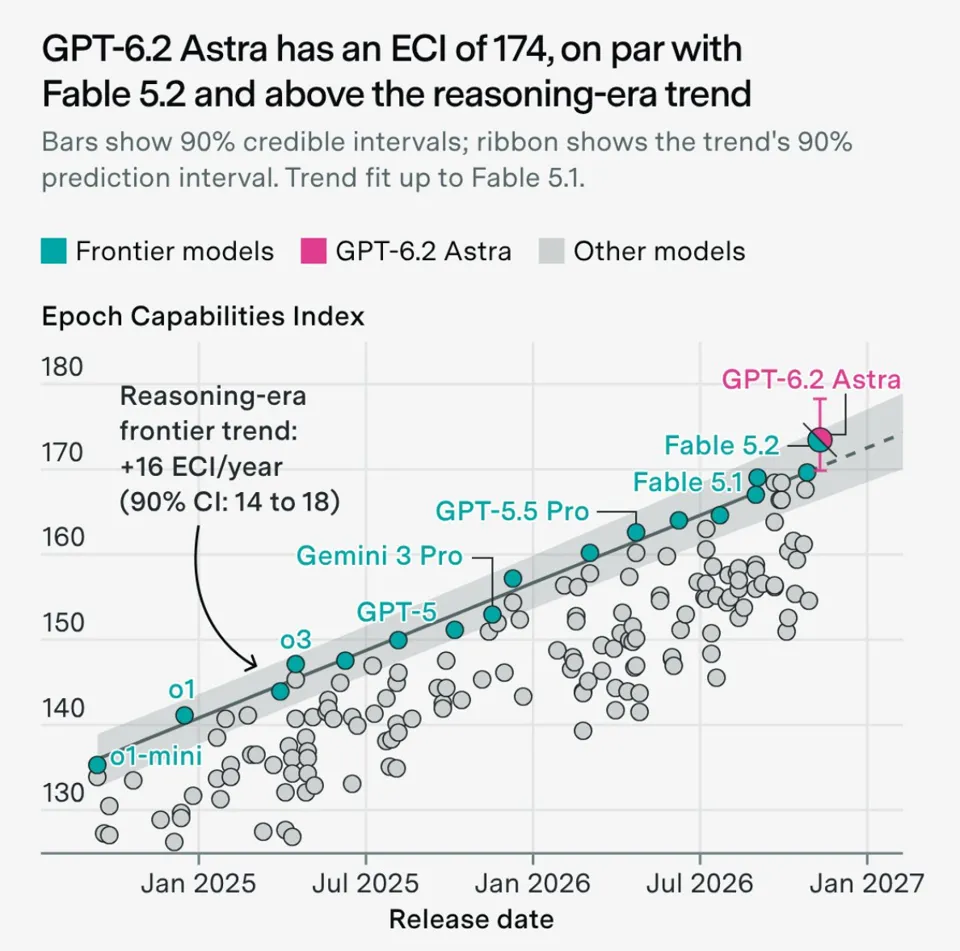
GPT-6.2 Astra 在 Epoch Capabilities Index 中得分 174 分,与 Anthropic 的 Fable 5.2 持平。两者均高于此前推理模型的趋势线。Astra 的价格显著更低。| 图片:Epoch AI
一个突出之处是 Astra 能够在单个输出 token 内进行复杂推理,且没有可见的思维链。Epoch AI 测得 Astra 的串行步骤为 12.3 步,高于 GPT-6 Astra 的 10.5 步和 Claude Fable 5.1 的 4.2 步,后者是当时最强的非 OpenAI 模型。能够以这种方式推理而不展示其工作过程的模型更难被监控,这一安全担忧在初代 Astra 模型上就已出现。
在 FrontierMath Erdős——一个由未解决数学问题组成的基准——上,GPT-6.2 Astra 解出了 68 道题中的 7 道,每道题均在证明助手 Lean 中经过形式化验证。此前的纪录是 68 道中的 3 道,由 GPT-6.1 Sol 创造。这七道题中有一道此前没有已知解法。
Vals AI 将 Astra 和 Sol 列入前十,但发现法律领域的薄弱点
GPT-6.2 Astra 在 Vals Index 中排名第 7,GPT-6.2 Sol 排名第 9,两者仅相差 1.6 分。不过价格差距很大。据 Vals AI 称,Sol 每任务运行成本为 3.18 美元,不到 Astra 的 10.68 美元的三分之一,是前 10 名中最便宜的模型。Astra 也比其前代更便宜,得分比 GPT-6 Astra 高 2.6 分,而每任务成本约为其 21.28 美元的一半。Vals AI 表示,Astra 在前 10 名中使用的输出 token 最少,平均每任务 91,000 个。
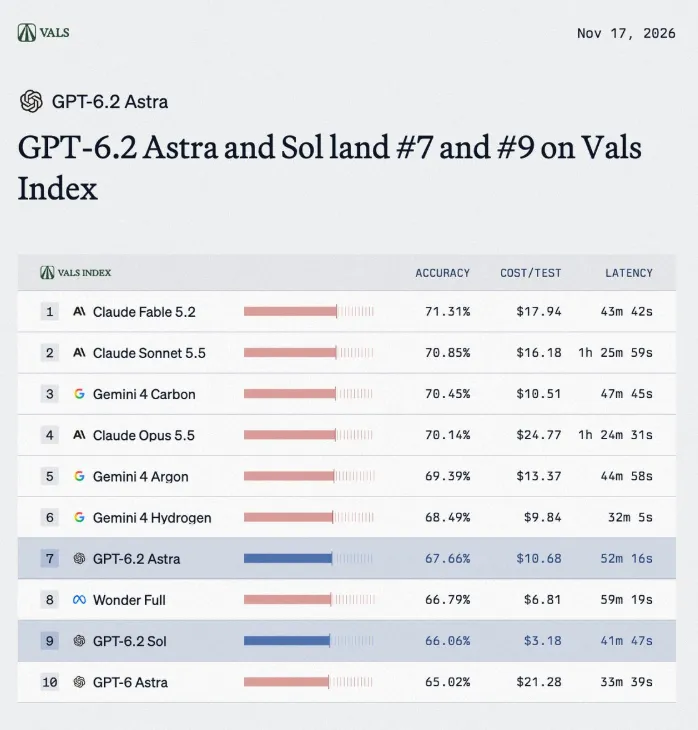
GPT-6.2 Astra 和 Sol 在 Vals Index 中分别排名第 7 和第 9。Sol 每任务运行成本为 3.18 美元,不到 Astra 的 10.68 美元的三分之一,是前 10 名中最便宜的模型。Claude Fable 5.2 位居榜首。| 图片:Vals AI
Vals AI 支持 OpenAI 在 Vals Science Index 中占据榜首的说法。Astra 在该排名中领先,并在 Terminal-Bench Science 和 VCB 1–100 中排名第一,成本约为 GPT-6 Astra 的一半,运行时间也约为其一半。Sol 在 Terminal-Bench Science 中排名第三,成本约为 Astra 的四分之一。在更广泛的智能体编程基准 Terminal-Bench 4 上,Astra 排名第 5,Sol 排名第 7。
据 Vals AI 称,法律测试是这些模型的短板。在 HLAB 基准上,Astra 和 Sol 的得分是其前代的两倍,但仅排名第 11 和第 21。在法律研究基准上,跌幅更大,Astra 排名第 30,Sol 排名第 52。Vals AI 表示,这些模型的工具调用次数几乎是其前代的两倍,但写出的答案更短。
9 月,OpenAI 发布了一款名为“Astra for Law”的专用产品。它在 Legal Research Bench 上的表现明显优于基础模型,达到第 6 名。Vals AI 在 100 万 token 上下文窗口、128,000 最大输出 token 和完整推理强度下测试了这两个模型。
GPT-6.2 Astra 是首个达到 OpenAI AI 自我改进“High”阈值的已发布模型
据 OpenAI 称,GPT-6.2 Astra 是首个达到 AI 自我改进“High”阈值的外部发布模型。OpenAI 表示,该模型能够显著加速 AI 研究,效果相当于为每位 OpenAI 研究员额外配备一名高技能研究工程师。
OpenAI 明确将此列为一项风险。能够帮助构建未来 AI 系统的模型,可能会推动该领域的发展速度超过安全措施和人类监督所能跟上的程度。业界目前正在“RSI”这一标签下努力应对这一问题。
作为应对措施,OpenAI 指出要在研究环境中实施更严格的管控,并借助其监控系统 Control Room,该系统可以跟踪研究任务并在需要时将其关停。该公司还表示,已扩大了监控范围,用于审查模型的推理与行动方式,并自动标记未经授权的行为。
在对齐方面,即模型遵循用户指令和公开沟通的表现如何,据 OpenAI 称,新模型与其前代产品相当。然而,在两项测试中,它们更频繁地未能标记出阻碍其工作的障碍,例如文件缺失或搜索工具不可用。