马普所新论文:开启推理后不同大模型更趋同,连错误也一致
原标题:New Max Planck paper finds that turning on reasoning makes different LLMs agree more, even on mistak...
78AI 研判分
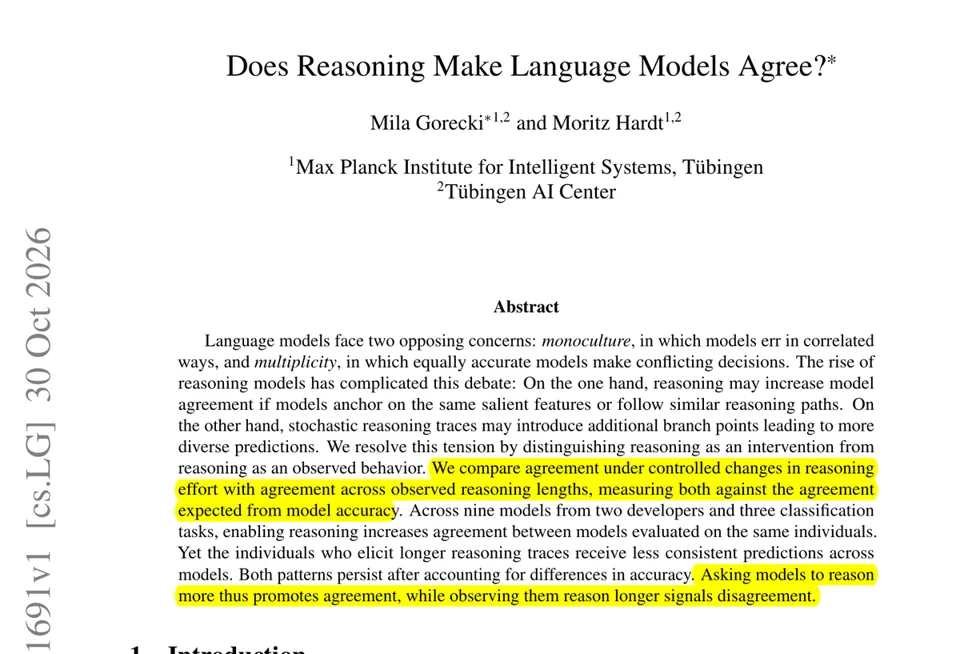
马克斯·普朗克研究所的新论文在 9 个 Qwen 与 GPT 模型、3 个基于美国人口普查数据的预测任务上对比推理开关状态,发现开启推理后模型间一致性上升,但全部 9 个模型同时答错的人群比例也上升 2.0 至 2.4 个百分点。对推理链最长的样本,校正后一致性降至约 0.31 至 0.39。作者提醒,多模型集成投票的纠错前提是错误不相关,而推理可能让错误变得更相关。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-05 10
马克斯·普朗克研究所的一篇新论文发现,开启推理会让不同的 LLM 更加一致,甚至在错误上也趋于一致,而较长的推理轨迹则标记出它们产生分歧的地方。
当多个 LLM 对同一个人做出判断时,一个模型的错误答案或许可以通过换用另一个模型来纠正。但这只有在这些模型不会全都犯相同错误的前提下才成立。
作者在 3 个基于美国人口普查调查构建的预测任务上测试了 9 个 Qwen 和 GPT 模型,分别开启和关闭推理。他们衡量的是超出各模型自身准确率所能预测范围之外的一致性。
开启推理后,模型之间的一致性更高,而全部 9 个模型都答错的人所占比例上升了 2.0 到 2.4 个百分点。对于推理轨迹最长的那部分人,校正后的一致性降至约 0.31 到 0.39。
对于涉及人的决策,要检查你的模型集合中是否有人能给出正确答案,因为更高的一致性也可能意味着更多共同的错误。