AWS Machine Learning Blog · 2026/10/23 02:00:04
AWS SageMaker AI 推出无服务器模型定制训练会话
Amazon SageMaker AI 正式推出“训练会话”功能,允许开发者在无需管理 GPU 基础设施的情况下,通过编写自定义训练循环和损失函数来对开源权重模型进行后训练。该服务自动处理分布式执行与故障恢复,旨在降低强化学习等高级定制技术的工程门槛。
报道全文原始报道全文
本文目录6 个章节
真正从 AI 中获益的企业,并不仅仅是在开箱即用地使用基础模型(FM)。他们正在利用强化学习等后训练技术对开放权重模型进行定制。基于你的业务背景、产品目录或临床词汇表训练的模型,在特定任务上会更准确,且运行成本更低。当你构建智能体时,你的数据、工作流、评估标准和成功准则也会塑造模型的行为方式。
然而,模型定制并非易事。你必须选择合适的技术,搭建并管理 GPU 基础设施,而对于智能体而言,还需要为多轮强化学习构建环境。我们推出了 Amazon SageMaker AI 无服务器模型定制功能以解决这些挑战,今天,随着训练会话(training sessions)的正式可用(GA),我们进一步扩展了这一能力。
通过训练会话,你可以在无需管理底层基础设施的情况下掌控后训练逻辑。你可以编写和协调训练循环,包括自定义损失函数或奖励信号。SageMaker AI 负责处理 GPU 分配、分布式执行、故障恢复和检查点存储。
摆脱基础设施管理的繁琐,轻松实现模型定制
借助 SageMaker AI 无服务器模型定制,你无需选择实例类型、管理集群或编写分布式训练配置。
我们不想限制你。你可以使用 SFT、DPO、RLVR、RLAIF 或多轮 RL 等技术。你可以选择通过低秩适配(LoRA)更新模型的多少部分,或者进行全量微调,并通过持续定制将多种技术串联起来。
我们不想让你浪费时间。我们的 SageMaker AI 训练会话 cookbook 提供了示例和用例,以及模型定制智能体技能。你只需描述你的用例,智能体就会处理数据准备、技术选择、训练、评估和部署。该智能体可以在你工作的地方运行,无论是 SageMaker Studio、Kiro、Claude Code、Codex 还是 GitHub Copilot。
“我们采用 SageMaker AI Serverless Training Sessions 构建了一个医疗理赔拒付分诊模型,从第一天起,这一体验就验证了该平台的价值。底层 API 接口、对前向和反向传播、采样以及优化器步骤的直接控制,为我们的科学家提供了在要求严苛且精度至关重要的用例中开展强化学习所需的细粒度控制能力。Training Sessions 为我们提供了合适的原语,以推动实现生产级性能。” — Rob Gontarek, ImagineSoftware 数据科学高级副总裁
编写你自己的后训练循环
智能体训练的一个重要转变是迈向多轮强化学习。例如,一个负责预订旅行、分派支持工单或执行多步研究任务的智能体,需要经过几轮交互才能判断其是否达成了正确结果。
然而,训练循环可能会迅速变得复杂。你可能在一个基础设施上训练模型,在另一个基础设施上运行推理以生成响应,对这些响应进行评分,并将结果输入到下一次更新中。每个阶段都需要不同的计算资源,而通过独立的工具和集群将它们连接起来会增加额外的工作量。
SageMaker AI 已经提供了一种托管的、无服务器的多轮强化学习技术。但我们听到客户反馈,他们希望在一个循环中定义自己的损失函数、塑造奖励信号或 RL 阶段。Training Sessions 赋予了这种灵活性。
“借助 SageMaker AI Serverless Training Sessions,我们针对 Amazon Neptune 知识图谱微调了 gpt-oss-20b,以实现智能体的多轮工具调用——平台为我们处理了基础设施。设置过程开箱即用,无需手动调优,也无需处理内存溢出问题。检查点与恢复功能表现卓越:从确切步骤恢复完全可靠。它在减轻运维负担的同时,为开发人员提供了他们所需的灵活性。” — Nitin Wagh, Karini AI 首席执行官
工作原理
你的代码在你的环境中运行训练循环和奖励函数,并将智能体连接到其工具或模拟器。Training Session 负责执行 GPU 密集型工作:采样器生成响应,训练器计算梯度并更新模型权重。具体的执行顺序取决于你编写的算法。
例如,我们来看看组相对策略优化(Group Relative Policy Optimization, GRPO)的实现。GRPO 是一种强化学习方法,它针对同一个提示词生成多个响应,对这些响应进行评分,并利用它们的相对表现来更新模型。一次循环迭代的工作流程如下:
- 采样响应 – 你的循环要求采样器使用当前模型为每个提示词生成多个响应。
- 评分 – 你的奖励函数在环境中使用验证器、奖励模型或测试框架对每个响应进行评分。
- 更新模型 – 你的循环将评分发送回训练器。
forward_backward()利用这些评分计算梯度,而optim_step()则将更新应用到模型权重上。 - 刷新并重复 – 你的循环要求会话使用更新后的权重刷新采样器,然后开始下一批次。你的代码会重复这些步骤,直到训练完成。
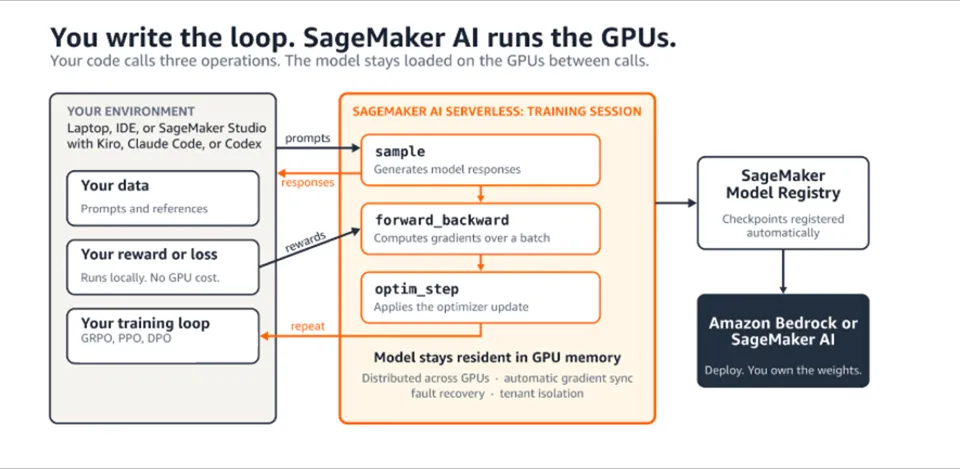
你只需为 SageMaker AI 处理的 token 付费。当你的奖励函数在环境中对一批数据进行评分时,计费会暂停,且无需预留容量。
掌控你的数据和模型
每个会话都使用你创建的 AWS Identity and Access Management (IAM) 执行角色,你可以添加自己的 AWS Key Management Service (AWS KMS) 密钥和虚拟私有云 (VPC) 配置。你的数据保留在你选择的 AWS 区域中的自有 Amazon Simple Storage Service (Amazon S3) 存储桶中,检查点也存储在相同位置。
我们不会使用你的数据或自定义权重来训练其他模型。在部署之前,你可以评估模型的准确性、偏见和安全性。部署之后,你可以应用护栏并通过 Amazon CloudWatch 对其进行监控。
你可以继续使用团队现有的治理流程。
立即开始
在 SageMaker AI 无服务器模型定制训练会话上编写你自己的训练循环,现已支持 gpt-oss-20b、gemma-4-31B-it、Qwen3.6-27B 和 Qwen3.8-27B。
两种入门方式:
- 在你的 IDE 中: 安装 SageMaker Python SDK(支持 Linux 或 macOS 上的 Python 3.10 至 3.12),克隆 cookbook,并开始开发。
- 在 SageMaker Studio 中: 在不到 20 秒内启动一个现成的 AI 开发环境。登录,打开笔记本,连接你的编码代理(Kiro、Claude Code、Codex 或 Copilot),下载代理技能和 cookbook,即可准备就绪。