Artificial Analysis (@ArtificialAnlys) · 2026/10/14 15:04:00
DeepSeek V4.1 Flash 登顶 AA-AgentPerf:NVIDIA GB300 实现 261M tokens/s/MW 能效突破
Artificial Analysis 将 DeepSeek V4.1 Flash 纳入其智能体推理基准测试 AA-AgentPerf,结果显示在 NVIDIA GB300 硬件上,该模型在每兆瓦功耗下实现了高达 2.61 亿 tokens/秒的系统吞吐量。V4.1 Flash 以约三分之一的参数量超越了前代 V4 Pro 0813 的智能水平,并在同等用户体验标准下展现出显著的能效优势。这一数据为评估开源大模型在真实编码代理工作负载中的部署成本与性能提供了关键参考。
报道全文原始报道全文
Artificial Analysis (@ArtificialAnlys) · 2026-10-14 07
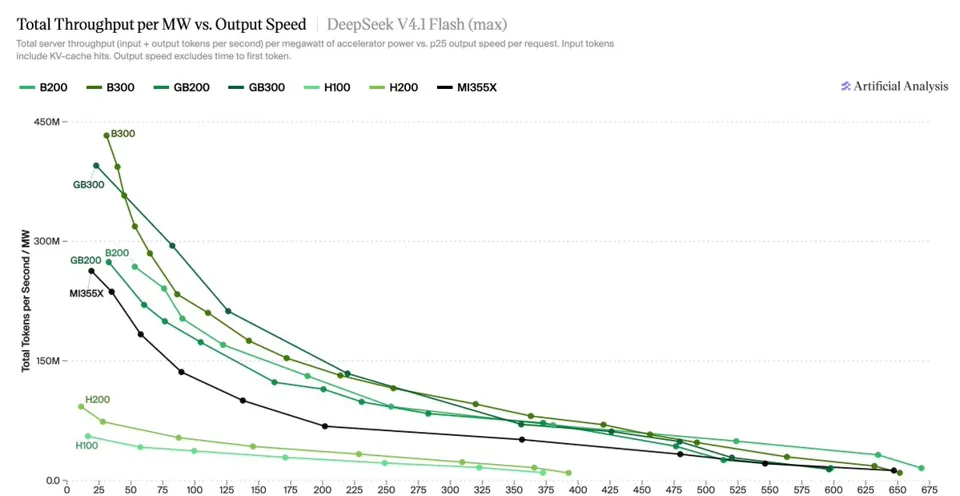
我们已将 DeepSeek V4.1 Flash 纳入 AA-AgentPerf,并提供了 NVIDIA 和 AMD 硬件的测试结果。在每用户 100 tokens/s 的条件下,NVIDIA GB300 位居榜首,其吞吐量高达每兆瓦 2.61 亿 tokens/s。
AA-AgentPerf 是我们的智能体推理性能基准测试。它通过重放真实的智能体编程会话(包括提示词缓存和工具调用延迟),为日常智能体工作负载中的推理性能提供真实可靠的衡量标准。我们测量的是每兆瓦运行功耗下的系统总吞吐量,以及不同并发级别下的单智能体输出速度,以展示系统利用率与单个用户体验之间的权衡关系。
DeepSeek V4.1 Flash 今日加入排行榜。这使得榜单上的精选模型增至四个,其他三个分别为 DeepSeek V4 Pro 0813、Kimi K3 和 GLM-5.2/5.3。随着热门新开源权重模型的发布,我们将持续更新精选模型列表,并为未来的重大发布提供首日(Day-0)测试结果。
关于 DeepSeek V4.1 Flash 的背景信息:
➤ 它在 Artificial Analysis 智能指数中得分为 39,高于 DeepSeek 早期的 V4 Pro 0813(得分 36),但参数量仅为后者的三分之一(主干网络 552B,激活参数 16B,对比 V4 Pro 的 1.6T 和 49B)。
➤ 它基于全新架构构建,采用因果编码器-解码器设计,每个输入 token 激活 8B 参数,每个输出 token 激活 16B 参数。此外,它还使用了 196B 参数的 Engram n-gram 记忆模块,该模块可驻留在主机内存而非加速器上;同时采用了压缩稀疏注意力机制,使得每个 token 所需的 KV Cache 仅为早期 V4 Flash 模型的四分之一左右。
➤ 这使其服务效率大幅提升,因为模型权重可以容纳在更少的 GPU 上,且较小的 KV Cache 为每张 GPU 支持更多并发智能体留出了空间。
DeepSeek V4.1 Flash 的初步 AA-AgentPerf 结果:
➤ V4.1 Flash 最少仅需 2 张 GPU 即可运行,因此机架级系统相较于 B300 等 8-GPU 单节点系统的优势减弱。在整个曲线范围内,B300 的性能保持在机架级 GB300 NVL72 的约 20% 以内,并在两端均处于领先地位。
➤ 在每用户 100 tok/s 的条件下,GB300 以约 2.61 亿 tokens/s/MW 的吞吐量领先,其次是 B300(约 2.2 亿)、B200(约 1.93 亿)、GB200(约 1.78 亿)和 MI355X(约 1.28 亿)。
➤ 所有 Blackwell 系统和 MI355X 在单智能体场景下(即 batch size 为 1)均可达到约 600 至 670 tok/s 的输出速度,而 H100 和 H200 在此条件下的速度为 372 至 392 tok/s。
➤ V4.1 Flash 不仅比 V4 Pro 0813 更智能,而且服务成本大幅降低。在每用户 100 tok/s 的条件下,其单位兆瓦(MW)吞吐量约为同系列更大模型的 1.3 倍(GB300)至 6.2 倍(B200)。