Artificial Analysis 发布编程智能体指数 v2.1
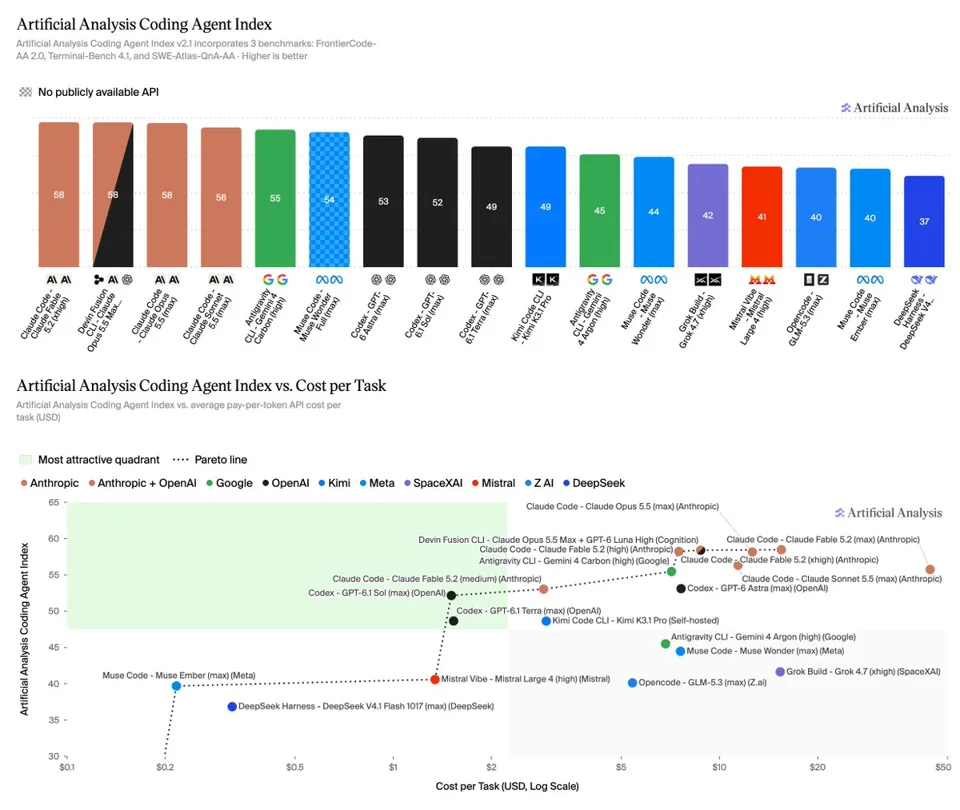
Artificial Analysis 发布 Coding Agent Index v2.1,将 FrontierCode 升级至 2.0、Terminal-Bench 升级至 4.1,并强化验证器以抵御奖励攻击。Claude Fable 5.2 与 Claude Opus 5.5 以 58 分并列榜首,但同分档配置的单任务成本相差约 30 倍,从 1.51 美元到 44.22 美元。
报道正文
Artificial Analysis (@ArtificialAnlys) · 2026-11-14 00
发布 Artificial Analysis Coding Agent Index v2.1,升级 FrontierCode 与 Terminal-Bench。Claude Fable 5.2 与 Claude Opus 5.5 以 58 分并列领先
Coding Agent Index 在智能体运行框架(agent harness)中评测模型;该指数 v2.1 将 FrontierCode 从 1.1 升级至 2.0,并将 Terminal-Bench 从 4.0 升级至 4.1。
升级内容:
➤ FrontierCode-AA 2.0(取代 FrontierCode v1.1):我们对 Cognition 的 FrontierCode 2.0 的实现,包含 132 个真实世界编码任务,评分标准为仓库维护者是否会合并智能体的改动
➤ Terminal-Bench 4.1(取代 Terminal-Bench 4.0):相同的 66 个任务,采用更新后的验证器评分,提升了可靠性及对奖励黑客(reward hacking)的抵抗能力
继续保留在指数中:SWE-Atlas-QnA-AA
关键结果:
➤ Claude Fable 5.2 与 Claude Opus 5.5 以 58 分并列领先:Claude Fable 5.2 在 Claude Code 中以 xhigh 和 high 两档均得 58 分。Claude Opus 5.5(max)在 Claude Code 中得 58 分,与 GPT-6 Luna High 搭配、在 Cognition 的多模型运行框架 Devin Fusion CLI 中同样得 58 分。Claude Fable 5.2(max)得 56 分,因其更多尝试触达任务时间上限。紧随其后的是 Claude Code 中的 Claude Sonnet 5.5(max,56 分)和 Antigravity CLI 中的 Gemini 4 Carbon(high,55 分)
➤ v2.1 的指数分数整体更低,主要源于升级至 FrontierCode-AA 2.0:模型平均得分下降 5 分。搭配 GPT-6.1 Terra(max)的 Codex 是唯一未在两个版本之间下滑的配置,与其此前得分相差在 1 分以内
➤ 在得分 48+ 的配置中,每任务成本相差约 30 倍:从搭配 GPT-6.1 Sol(max,52 分)的 Codex 的 $1.51,到搭配 Claude Fable 5.2(max,56 分)的 Claude Code 的 $44.22