vLLM 实现编码器解耦 多模态推理吞吐大幅提升
vLLM 社区推进 EPD(编码器/预填充/解码)解耦架构,将视觉编码阶段拆分为独立部署的实例,使其可随媒体大小与模态需求独立扩缩容。vLLM 主分支现已支持 DeepSeek V4.1 Flash 的纯元数据 EPD,并扩展至远程嵌入传输、共享缓存与请求路由等环节。
报道正文
本文目录19 个章节
vLLM 中的编码器解耦:以 EPD 扩展多模态服务
多模态推理在语言模型执行之前增加了一个编码阶段。图像、视频帧和音频必须先被处理成嵌入,语言模型才能使用它们。这一阶段的需求随媒体大小、模态和请求组合而变化,并且可以独立于 prefill 和 decode 的需求发生变化。
编码器 / Prefill / Decode(EPD)解耦将这些阶段分离为独立部署的 vLLM 实例。vLLM 社区近期的工作在模型执行、远程嵌入传输、共享缓存、多模态输入处理和请求路由等方面扩展了 EPD。
DeepSeek 的推理部署问答描述了一种单独部署视觉编码器的 E/P/D 架构。vLLM 自我们 2025 年 12 月的架构文章起就支持编码器解耦,并持续改进这一支持。vLLM main 现在也支持 DeepSeek V4.1 Flash 的仅元数据 EPD。
本文解释这一进展背后的工程实现,重点介绍五项变更:
- 仅元数据请求,让下游实例能够消费远程嵌入,而无需重复媒体预处理。
- 专用编码器执行,包括独立的 Model Runner V2 路径、仅编码器的 CUDA Graph 支持,以及减少的检查点加载 I/O。
- 远程嵌入传输,通过 NIXL 和 Mooncake 集成实现。
- 跨编码器输出复用,通过 Mooncake Store 实现。
- 降低编排开销,在 Python EPD 代理中,以及通过 vLLM Router、SMG 和 llm-d 进行 EPD 编排时。
EPD 跟踪器汇总了正在进行的工作。下文描述的核心 vLLM 能力,包括 MiMo 和 XPU 支持,已包含在 vLLM v0.32.0 中。DeepSeek V4.1 Flash 的仅元数据支持已通过 #62802 在 main 上提供。下文的 vLLM Router 和 SMG 集成使用各自的主分支。
为什么要分离编码器?
一个多模态请求通常经过三个阶段:
- 编码器(E): 预处理媒体并生成多模态嵌入。
- Prefill(P): 处理提示词和多模态嵌入,构建生成所需的状态。
- Decode(D): 使用该状态生成输出 token。
EPD 支持两种部署模式:E+PD,即独立的编码器加上一个合并的 prefill/decode 实例;以及 E/P/D,即三个阶段全部独立部署。
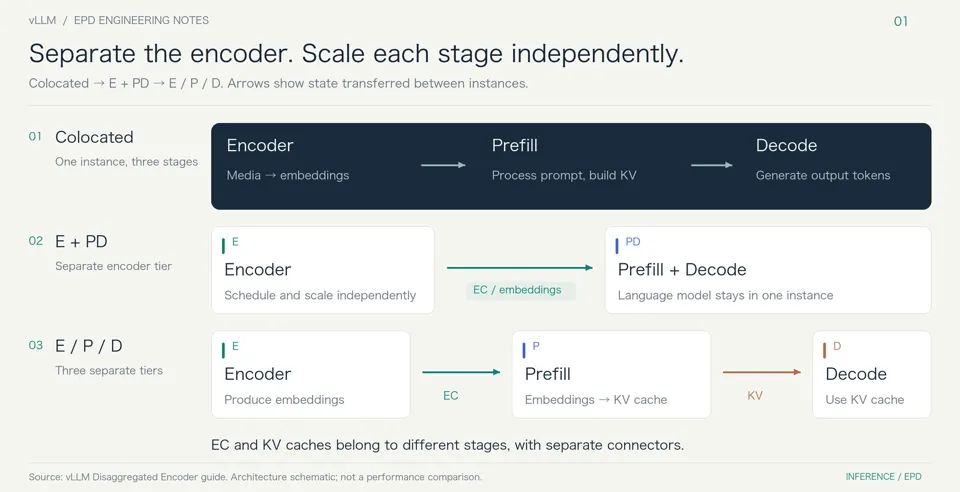
编码器、prefill 与 decode 的部署模式
图 1. E+PD 将编码与语言模型执行分离。E/P/D 则进一步将 prefill 与 decode 分离。EC 连接器负责传递编码器嵌入;KV 连接器在 prefill 与 decode 之间传输状态。
图像密集型工作负载可能需要更多编码器容量,而 decode 容量无需相应增加。响应较长的工作负载则可能恰好相反。将各阶段分离后,运维人员可以独立调整各阶段的实例数量和执行设置,同时把编码器计算从服务语言模型的 GPU 上移走。
仅元数据请求:避免重复预处理
传输嵌入只解决了交接的一部分问题。消费方还需要足够的信息来重建多模态输入的布局:占位符长度、图像网格、特征长度,以及将这些位置与所传输嵌入关联起来的标识符。
一种直接的 EPD 实现会将原始媒体发送给编码器,通过 EC 连接器传输生成的嵌入,并将原始请求转发给 P/PD。这样做可以正确运行,但消费方可能仍需获取、解码、缩放、归一化或分块处理媒体,以恢复其输入布局。而编码器已经完成了这些工作。
仅元数据请求会用包含编码器侧已生成的结构信息的引用,替换下游的媒体项。 消费方根据该元数据重建占位符,并通过 EC 连接器接收实际的嵌入。
只有多模态项发生变化:文本提示和生成设置保持不变,嵌入仍通过 EC 数据路径传输。
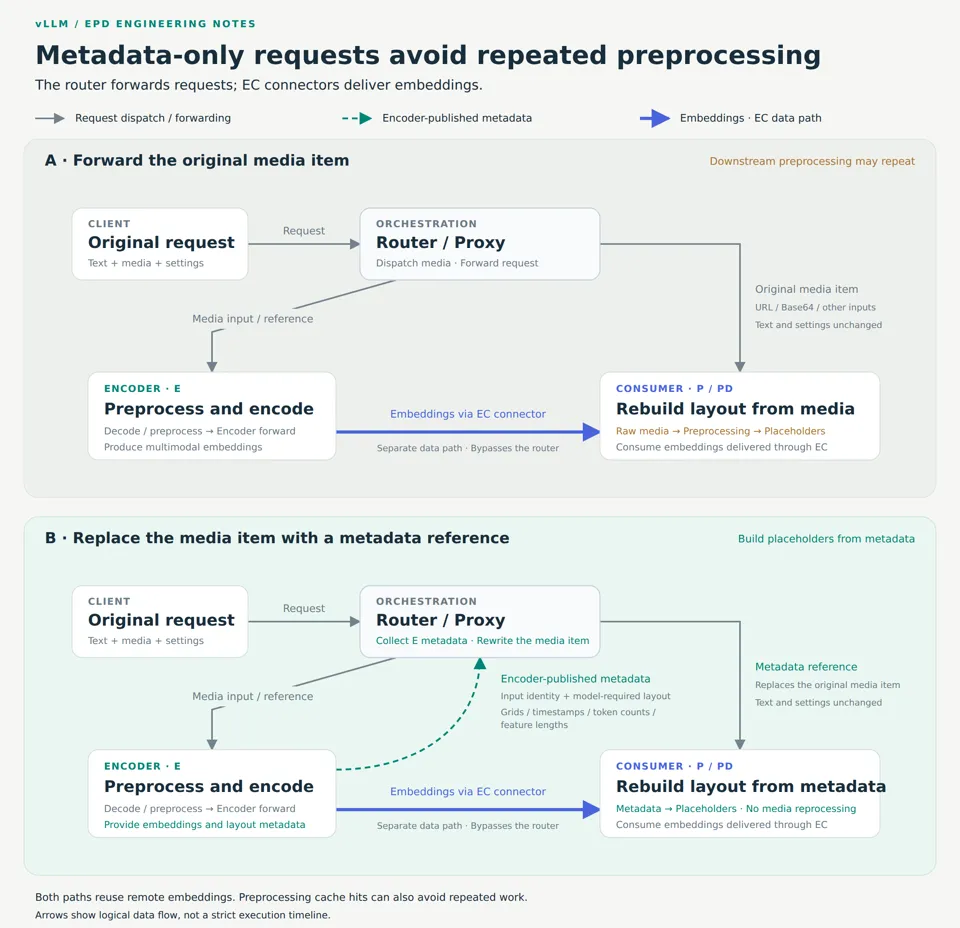
路由器转发原始媒体请求或仅元数据请求,而 EC 连接器单独传递嵌入
图 2. 路由器/代理将媒体分发给 E,并将请求转发给 P/PD。在仅元数据路径中,E 将布局元数据返回给路由器,由路由器替换下游媒体项。在两条路径中,嵌入均通过 EC 连接器单独传输。箭头表示逻辑数据流,而非执行时间线。
例如,Qwen 系列的图像输入需要 image_grid_thw 等网格信息来构建相应的多模态布局。编码器可以发布其已计算出的网格,使 P 能够直接使用。
| 对比项 | 转发到 P 的原始媒体 | 仅元数据 |
|---|---|---|
| 下游媒体项 | 图像 URL、base64 数据或其他原始媒体输入 | 输入标识及模型所需的结构化元数据 |
| 输入布局重建 | 媒体处理,或复用缓存中的预处理结果 | 基于编码器发布的元数据构建占位符 |
| 嵌入来源 | EC 连接器;可用的远程嵌入可避免再次执行编码器前向计算 | EC 连接器 |
| 主要开销或要求 | 可能重复的获取、解码和预处理 | 与所传输嵌入及输入布局一致的元数据契约 |
如果没有仅元数据转发,编码器不一定需要运行两次,因为远程嵌入已经覆盖了它。重复发生在媒体处理环节,而转发 URL 也可能导致消费者再次获取媒体。
跨图像、视频和音频的元数据
Python EPD 路径在支持的模型中支持对图像、视频和音频进行仅元数据转发。三者使用相同的交接方式:消费者根据编码器发布的元数据重建输入布局,同时通过 EC 连接器接收嵌入。所需字段取决于模型和模态:
- 图像: 诸如
image_grid_thw之类的图像网格让消费者无需再次处理像素即可构建视觉占位符范围。 - 视频: 前端接受
video_embeds引用以及重建视频布局所需的元数据。对于 Qwen3-VL,这包括video_grid_thw和编码器发布的时间戳,它们会影响提示词中的 token 布局。 - 音频: 音频 token 数量和所需特征长度让消费者无需重复音频预处理即可重建占位符。
元数据序列化是一项独立的优化。模型声明的元数据字段现在可以表示为数值 JSON 数组,从而避免对小结构字段进行 PyTorch 张量序列化和 base64 转换。这也为路由器和其他前端提供了一种语言中立的表示。
下面的音频评估说明了这种交接方式带来的好处。音频改动覆盖了纯音频 Chat Completions 请求相关的 Qwen2-Audio、AudioFlamingo3、Ultravox、Qwen2.5-Omni 和 Qwen3-Omni 路径;实时和组合视听输入不在其范围内。
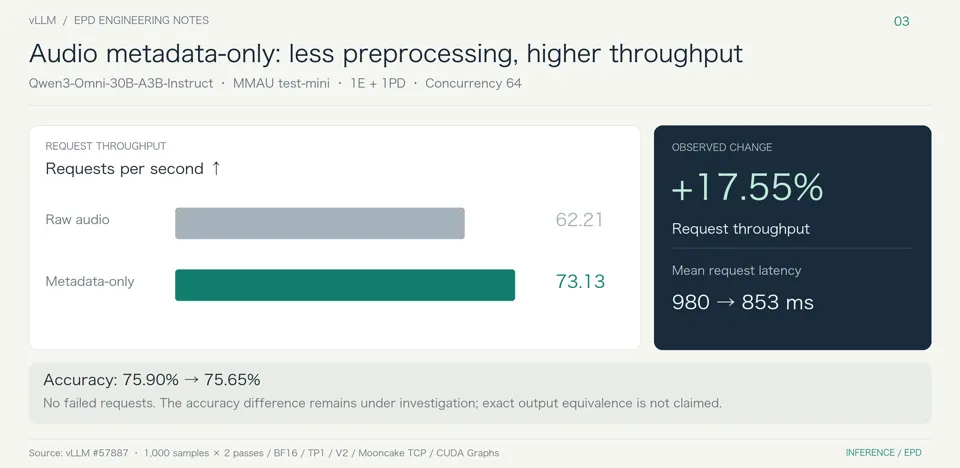
音频仅元数据吞吐量和延迟结果
图 3. 在 MMAU test-mini 上的音频仅元数据评估:1,000 个样本,两轮,Qwen3-Omni-30B-A3B-Instruct,BF16,TP=1,Model Runner V2,Mooncake TCP,1E+1PD,并发 64,并启用 CUDA Graphs。
在此音频评估中,仅元数据转发将吞吐量从 62.21 提升至 73.13 请求/秒,并将平均延迟从 980 降至 853 毫秒。准确率从 75.90% 变为 75.65%;这一差异仍有待调查。该比较衡量的是 EPD 内的两条音频输入路径,而非 EPD 与同址部署的对比。
编码器实例的专用执行路径
仅编码器实例不运行语言模型,不维护语言模型 KV 缓存,也不生成采样 token。其执行生命周期应体现这些差异。
Model Runner V2 将仅编码器执行隔离在专用的 MMEncoderModelRunner 中。它不依赖 token 采样来管理 GPU 完成状态,从而在编码器工作仍在进行时防止缓冲区被过早复用。
相关改动使编码器执行更加一致:
- 配置规范化: 仅生产者 EC 实例会自动进入仅编码器模式。
- 正确的异步执行: 仅编码器步骤跳过 token 采样,包括没有 EC 连接器的独立
--mm-encoder-only实例。 - 减少启动 I/O: 当权重布局可以安全分类时,仅编码器加载会跳过纯语言模型检查点分片。在裁剪后的 Kimi-K3 检查点上,编码器仅读取了 96 个分片中的 2 个,权重加载时间从 683 秒降至 0.31 秒。
- 编码器 CUDA Graph 捕获: 仅编码器 V2 runner 支持可选的 ViT 图捕获,复用现有的预算选择、重放和 eager 回退机制。
GPU 视频处理
GPU 预处理和 NVDEC 硬件解码加速了 E 上的媒体处理。在30 帧 MMVU 评估中,端到端吞吐量在三次运行中提升了约 94–115%,每次运行均在独立的 4-GPU GB200 节点上进行。每次运行使用 Qwen3.5-35B-A3B、1E+3PD 拓扑、共享存储 EC 连接器、eager 执行和并发度 64。这些收益包括 GPU 预处理和硬件视频解码;随着编码器变快,PD 层成为瓶颈。
远程嵌入传输与故障隔离
ECExampleConnector 提供了一条用于验证 EPD 的共享文件系统路径。跨节点部署需要网络传输、目标缓冲区管理以及对在途输出的明确所有权。
两条远程传输路径已经落地:
| 后端 | 能力 | 文档 |
|---|---|---|
| NIXL + CPU EC | 通过在已注册的 CPU mmap 区域之间进行 NIXL 传输,在实例之间共享 CPU 卸载的编码器输出 | CPU EC 指南 |
| Mooncake EC | 通过 Mooncake TransferEngine 传递编码器输出,支持 TCP 和 RDMA 配置路径 | Mooncake EC 指南 |
传输形状必须与编码器输出匹配
传输缓冲区可能需要在某个条目被编码之前就分配好。它们的大小无法仅凭单个语言模型隐藏层大小字段可靠推断:不同模态和模型架构可能产生不同的编码器输出宽度。
例如,所测试的 Qwen3-Omni checkpoint 产生的视觉输出宽度为 8192(包含 DeepStack 信息),音频输出宽度为 2048。EC 生产者现在会在初始化期间按模态测量输出宽度,并在整个传输协议中携带实际形状。NIXL EC 协议版本也已更新,要求生产者和消费者一同升级。
传输失败应使受影响的请求失败
仅含元数据的请求使失败处理尤为重要。持有原始媒体的消费者或许能够回退到本地编码。而仅持有元数据的消费者则缺少该输入。
消费者现在会显式处理这一区别:当远程编码无法到达且本地恢复不可用时,它会将受影响的请求报告为不可用,而不是采取可能导致 EngineCore 终止的不安全回退路径。资源生命周期方面的修复(包括在 NIXL 设置失败后释放共享内存)进一步改进了失败处理。
跨编码器实例复用输出
实例本地缓存留下了复用缺口。一张由 E0 编码的图像,在负载均衡、扩缩容或恢复之后,可能被路由到 E1。如果 E1 没有缓存输出,它可能会重复执行另一个实例已经完成的编码器前向计算。
Mooncake Store 实现了跨编码器的输出复用。在本地未命中时,编码器会检查共享 Store。命中则直接提供嵌入,无需再次前向计算;未命中则按正常流程编码,并异步发布输出。向所选 P 实例的交付继续通过 Mooncake P2P 进行。
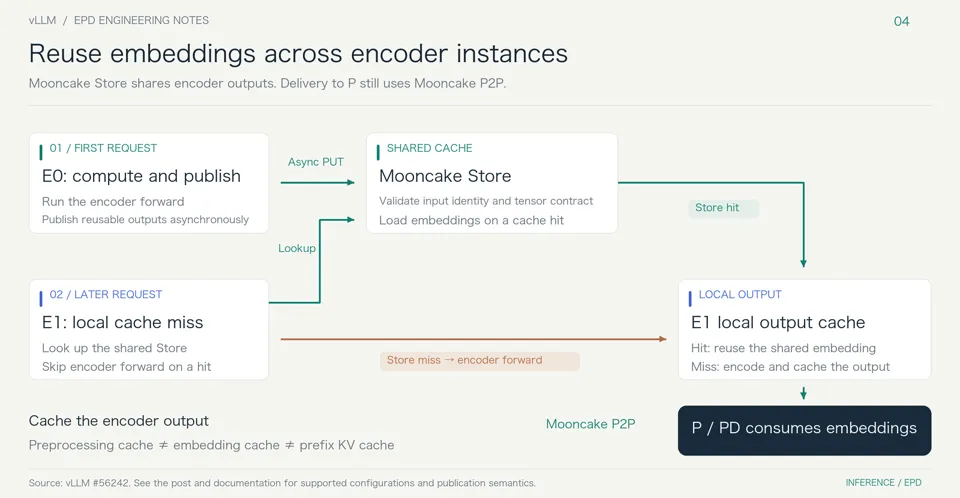
使用 Mooncake Store 实现跨编码器嵌入复用
图 4. Mooncake Store 提供跨编码器的共享输出复用。ECMooncakeConnector 保留到所选消费者的 P2P 交付路径。
共享复用会校验输入身份、模型身份以及输出张量契约。初始支持包括图像、Model Runner V2、编码器 TP=1,且不支持动态 LoRA。发布是异步的,因此并发的冷请求仍可能重复计算。有关配置和支持的组合,请参阅跨编码器复用指南。
一项受控重分配实验使用了六块 H20 GPU、InternVL3_5-38B-HF、2E+4PD 拓扑以及同节点 Mooncake TCP。在缓存填充后,图像在编码器之间被重新分配,以制造本地未命中。在包含 512 张图像的 128 个被测请求中,共享复用将重复的图像编码从 512 次降至零。TTFT p50 从 1.209 秒降至 0.819 秒,p90 从 1.656 秒降至 0.891 秒,TPOT 基本不变。
这是对每个图像都被重新分配的工作负载进行的单次运行,因此它展示的是共享复用的最佳情况。生产环境的节省取决于输出被复用的频率,并与 Store 的内存和 I/O 成本相权衡。
EPD 编排与路由
计算阶段的独立扩展需要一条能够跟上节奏的编排路径。 分发媒体、收集编码器元数据以及转发请求,可能会随着编码速度加快或缓存命中消除编码而成为瓶颈。
仅元数据请求可减少下游媒体流量,而 JSON 元数据避免了结构字段的张量序列化。Python EPD 代理通过更快的 JSON 编码和解码,以及直接转发最终响应字节(包括流式响应)而无需解码和重新编码,进一步降低了 CPU 开销。
vLLM Router 中的 EPD 编排
vLLM Router 支持 HTTP E+PD 和 E/P/D 部署、仅元数据转发、跨编码器的多图像分发,以及数据并行 P/PD 消费者。编码器和消费者数量可以独立配置。支持的 EC 后端包括 Mooncake、NIXL 以及共享文件系统示例连接器。有关使用静态 worker 的原生 CLI 配置,请参阅路由器 EPD 指南。
SMG 中的 EPD 编排
SMG 通过 gRPC 支持 vLLM E/P/D 部署,包括仅元数据转发、编码器侧媒体预处理,以及 Mooncake 和 NIXL EC 后端。它支持Python 和 Rust 两种 servicer,并且可以将单个纯图像请求中的图像分发到多个 E worker,对分配给同一编码器的图像进行批处理。
llm-d 中的 EPD 编排
llm-d 在 Kubernetes 上运行 vLLM EPD,其多模态服务指南中提供了 E+PD 和 E/P/D 布局。每个角色作为独立的 pod 层级运行,因此编码器可以独立于 prefill 和 decode 进行扩展,并使用不同的硬件。llm-d Router(即 Endpoint Picker,简称 EPP)负责选择编码器 pod,而路由 sidecar 或 Coordinator 则在其间分发编码请求,以并行处理多张图像。嵌入通过基于 NIXL 的 EC 连接器到达消费者,纯文本请求则跳过编码。
llm-d 团队与 vLLM 社区合作,为 EPD 提供了一条经过验证的、Kubernetes 原生的部署路径。有关架构以及何时需要分离编码的更多信息,请参阅 llm-d 的多模态服务博客。
DeepSeek V4.1 Flash:EPD 实践
我们在 GB200 上使用 DeepSeek V4.1 Flash 和 512 个 MP-DocVQA 验证问题,对比了 PD 服务与 EPD,每个问题包含四到六页原始文档页面。请求平均为 4,905 个输入 token 和 5.2 个输出 token。每个并发级别运行三次,并启用了缓存和 CUDA Graphs。
PD 基线使用四块 GPU 用于 P,四块用于 D。EPD 增加了四个单 GPU 编码器实例,同时保持相同的 P/D 配置:TP=1、DP=4、专家并行,以及跨 DP rank 分片的 GPU 常驻 Engram 表(DEP4)。EPD 使用 Mooncake GPU RDMA 传输嵌入;两种部署均使用 NIXL 进行 KV 传输。两者均运行 main 分支的 5314c58281 加上 DeepSeek 仅元数据扩展。
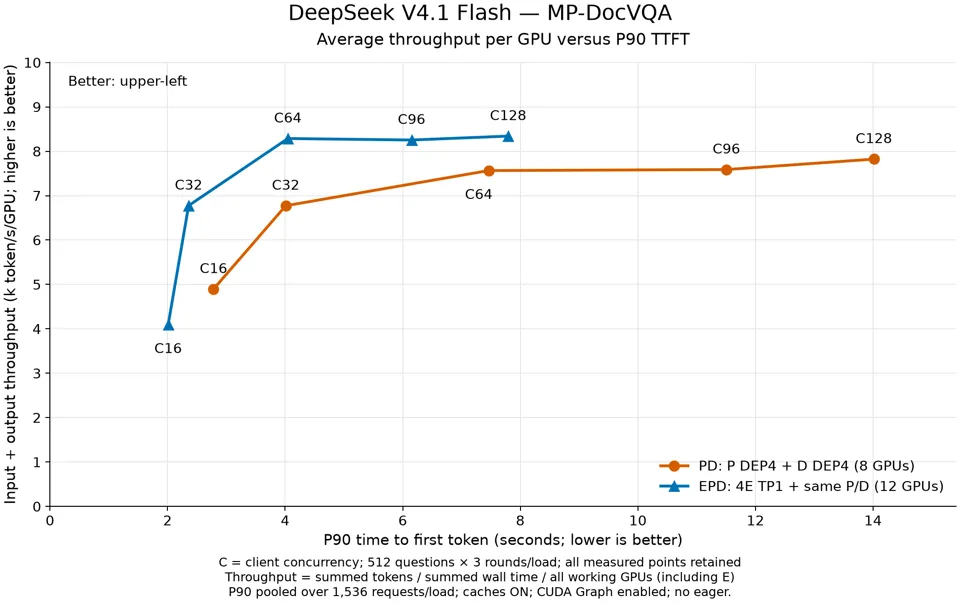
DeepSeek V4.1 Flash 每 GPU 吞吐量与 P90 首 token 时间对比,比较 PD 与 EPD
图 5。吞吐量越高、P90 TTFT 越低越好。C 表示客户端并发数。吞吐量统计输入加输出 token 数,除以实际耗时和所有已部署 GPU:PD 为八块,EPD 为十二块,包含全部四块编码器 GPU。数据点为三轮汇总;P90 汇总每个并发级别下的全部 1,536 个请求。绘图数据。
在并发 64–128 时,EPD 的每 GPU 输入加输出吞吐量比八 GPU 的 PD 基线高 6.6–9.5%,统计了全部 12 块 EPD GPU,包括编码器。P90 TTFT 低 44–47%。但在并发 16 时,EPD 的每 GPU 吞吐量更低;并发 32 时大致持平。收益取决于负载和资源分配,而非仅靠分离本身。
快速上手
先从 E+PD 开始,在增加独立解码层之前验证编码器到消费者的交接。分离式编码器指南提供了示例部署和集成测试的链接。
在具备兼容的 vLLM 检出、已安装 Mooncake 且有两块可用 GPU 的情况下,以下集成脚本会运行基线,并与分离式部署的输出进行对比:
GPU_E=0 GPU_PD=1 MOONCAKE_EC_PROTOCOL=tcp \
  bash tests/v1/ec_connector/integration/run_epd_mooncake_ec_full_pipeline.sh
传输依赖和消费者控制地址配置请参阅 Mooncake EC 指南,CPU 卸载和基于 NIXL 的共享请参阅 CPU EC 指南。根据目标媒体组合、缓存行为和延迟要求选择 E/PD 资源划分。
下一步
近期工作已将 EPD 扩展到其核心执行和传输路径之外。MiMo-V2-Omni 现在声明了图像 EPD 所需的嵌入字段,而 XPU 支持则包括 EC 集成和仅编码器生产者运行器。
后续工作包括可观测性、更多传输和缓存后端、前端集成,以及更清晰的上游错误传播。运维人员需要区分计算嵌入、加载缓存输出和远程传输各自花费的时间。
另一个机会是将编码器工作与预填充侧复用进行协调。在 E-first 流水线中,编码可以在 P 发现其 KV 缓存已覆盖某个多模态出现、或本地已有可复用嵌入之前就开始。设计讨论正在探索 P 的需求如何抑制不必要的上游工作。该设计必须在节省的计算和交付与额外的查找、协调和冷请求延迟之间取得平衡。
对 EPD 有疑问或有兴趣参与?加入 vLLM Slack 上的 EPD / EC-connector 频道,讨论用例、分享反馈并开展协作。
致谢
我们感谢以下贡献者的工作和反馈:
- Inferact: Tianyu Guo、Zifeng Mo、Siyu Liu、Roger Wang
- InferMatrix 团队: Ziheng Zhou、Chenzhou Jiang、Ruixin Li、Hang Wu、Chenguang Zheng、Haozhao Dai、Hongsheng Liu
- IBM: Omer Paz、Or Ozeri、Danny Harnik
相关资源
- 面向可扩展多模态模型服务的编码器解耦:原始架构与动机。
- 解耦编码器文档:部署示例与配置。
- EPD 跟踪器:正在进行的实现工作。
实现参考
- 多模态输入:图像元数据、视频引用与时间戳、音频元数据 和 JSON 元数据。
- 编码器执行:专用 runner、配置规范化、异步执行、检查点加载 以及 CUDA Graph 捕获与后端校验。
- 远程传输:NIXL + CPU EC、Mooncake EC、实测传输形状、请求故障隔离 和 共享内存清理。
- 缓存与媒体处理:跨编码器复用 和 GPU 视频处理。
- 编排:降低 Python 代理开销、动态注册、vLLM Router 集成、Router 数据并行消费者、SMG gRPC EPD、SMG Rust servicer 支持 和 SMG 多编码器图像扇出。
- 模型与设备支持:MiMo-V2-Omni、XPU EC 集成 和 XPU 仅编码器执行。