研究揭示基准低分可被精确制造
原标题:This paper finds that a low benchmark score can be manufactured precisely, so a low score alone says...
78AI 研判分
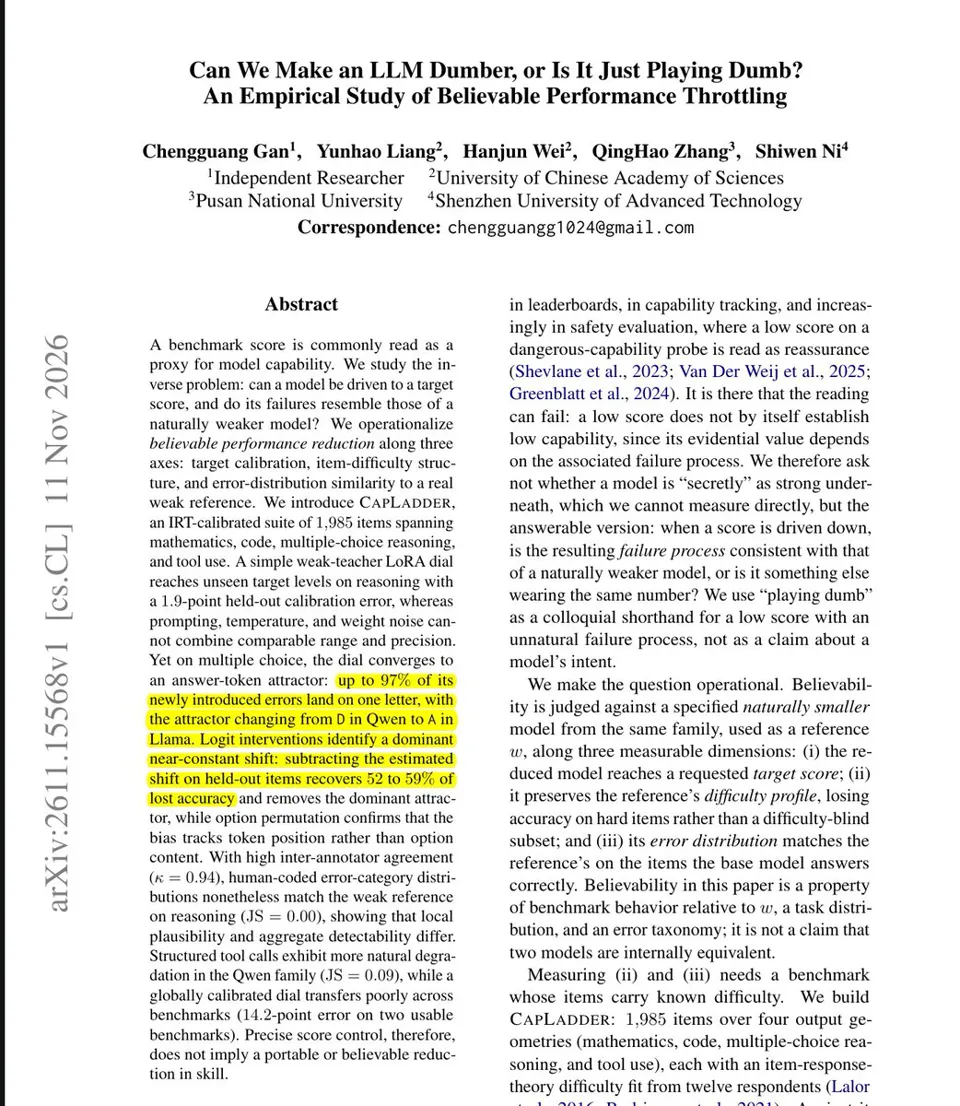
一篇新论文指出,模型在危险能力探针上的低分可能来自人为压制而非真实能力不足,因此单看分数几乎无法证明安全性。研究者用 LoRA 训练出一个“调节旋钮”,把 Qwen 模型拉向更小的 Qwen 模型,可在 1.9 分以内命中未见过的目标分数,而提示词诱导的偏差高达 42 至 47 分。更关键的是,该旋钮产生的新错误中最多 97% 集中在同一个选项字母上,这种错误分布特征可作为识别人为压分的信号。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-17 17
这篇论文发现,低基准分数可以被精确地人为制造出来,因此单凭一个低分几乎无法说明模型能做什么。
安全测试常常把危险能力探针上的低分解读为令人安心的信号。但低分可能源于模型被刻意压制,所以仅凭这个数字证明不了什么。
他们训练了一个 LoRA“旋钮”,将 Qwen 模型拉向一个更小的 Qwen 模型,然后将其错误与真实小模型的错误进行比较。他们还尝试通过提示让模型表现不佳、提高温度以及添加权重噪声。
该旋钮在未见过的目标分数上误差在 1.9 分以内,而提示方法的误差为 42 到 47 分。但在多项选择上,其新增错误中高达 97% 集中在 1 个字母上,这一比例在他们测试的模型中没有任何自然模型能接近。
在将低分解读为低能力之前,先检查模型在哪些题目上失败,以及其错误答案是如何分布的。