Claude Opus 5.5 登顶 AA 智能指数:以 58 分刷新纪录并大幅降价至 $4/$20
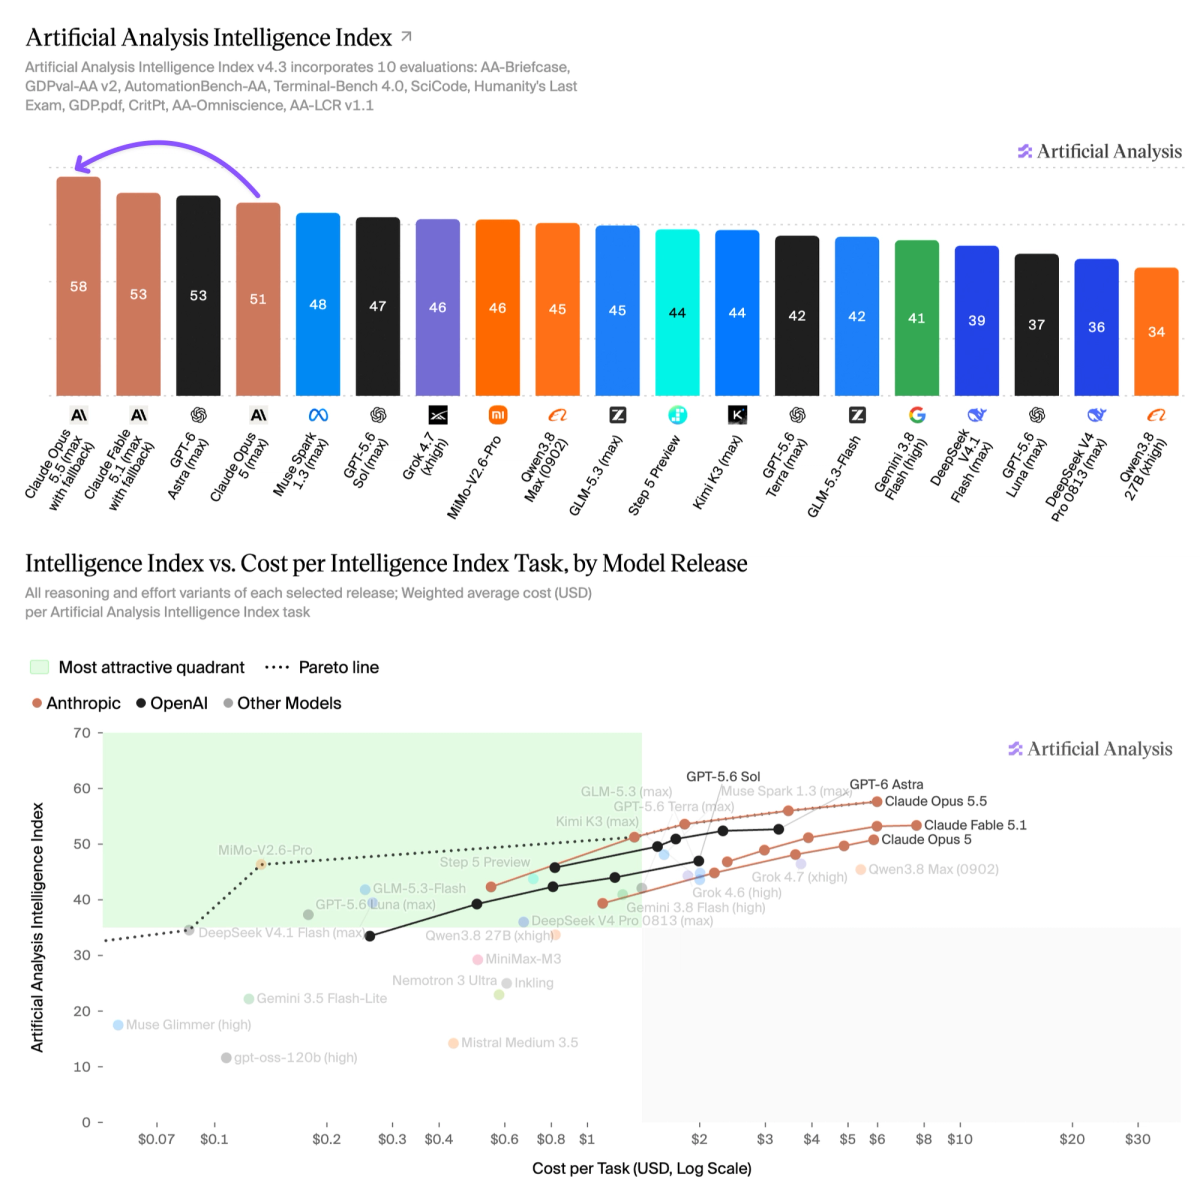
Anthropic 发布 Claude Opus 5.5,在 Artificial Analysis Intelligence Index 中以最高努力模式获得 58 分的历史最高纪录。该模型在 Terminal-Bench 4.0 和 AutomationBench-AA 等关键评估中与 GPT-6 Astra 持平,并在六项基准测试中领先,同时在 agentic 知识工作(AA-Briefcase)上确立显著优势。此外,API 定价下调至每百万 token $4/$20,缓存读取费用减半,提升了性价比。
报道正文
Claude Opus 5.5 使 Anthropic 在 Terminal-Bench 4.0 和 AutomationBench-AA 等评测中与 GPT-6 Astra 持平,同时进一步扩大了其在智能体知识工作领域的领先优势。
在最高推理强度(max effort)下,它在 Artificial Analysis Intelligence Index 中得分 58,比我们此前测得的最高分高出数个百分点。Anthropic 已将 Opus 的定价降至每百万输入/输出 token 20(Opus 5:25),并将缓存读取价格从 $0.50 降至 $0.20。
关键要点:
➤ 表现强劲且稳定,在十项 Intelligence Index 评测中有六项取得领先分数: Humanity's Last Exam 61.4%(此前最佳为 59.1%,由 Claude Fable 5.1 保持),SciCode 66.9%(63.1%,Fable 5.1),GDPval-AA v2.1、AA-Briefcase v1.1、AA-Omniscience 以及 AutomationBench-AA。在 Terminal-Bench 4.0 上得分为 59.6%,与领跑者 GPT-6 Astra (xhigh) 持平,并比 Opus 5 高出 11 个百分点。但在 CritPt、AA-LCR 和 GDP.pdf 上仍落后于对手。
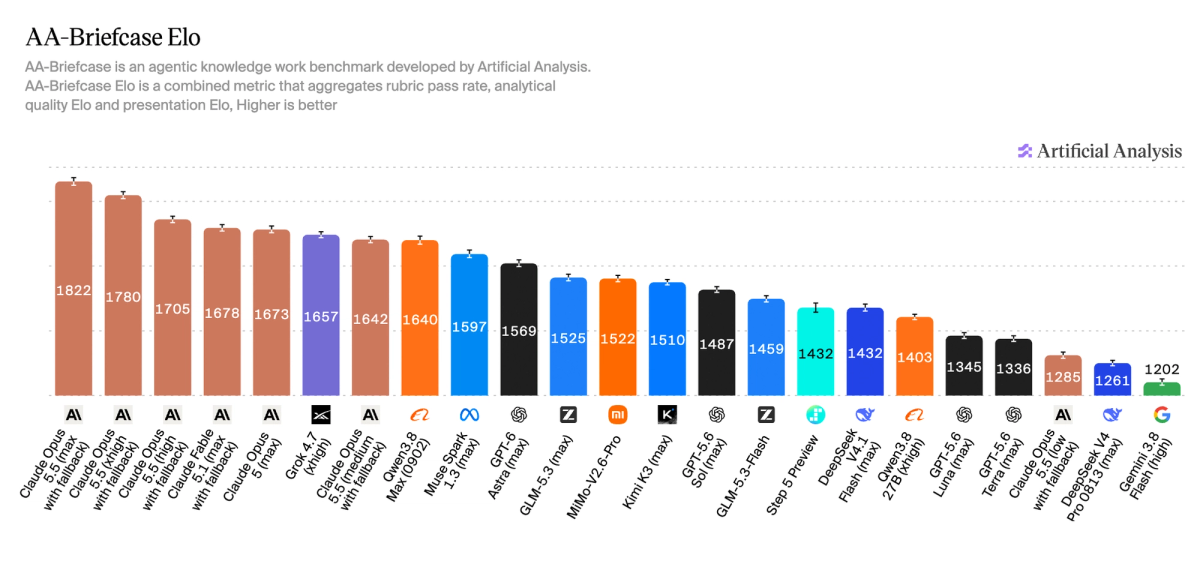
➤ 在智能体知识工作领域处于领先地位: 在我们的私有前沿知识工作评测 AA-Briefcase 中,其 Elo 评分达到 1822。这比 Fable 5.1 高出 143 分,在分析质量和呈现效果上均占优,并且是 Anthropic 首次实现呈现质量超越 GPT-5.6 Sol。该评测使用我们的开源参考智能体框架 Stirrup,测试模型能否生成准确且呈现专业的输出结果。
➤ 尽管输出 token 数量增加至 1.6 倍,但单任务成本与 Opus 5 持平: Opus 5.5 (max) 在每个 Intelligence Index 任务中消耗约 11.9 万输出 token,而 Opus 5 (max) 约为 7.3 万,Fable 5.1 (max) 约为 7.8 万,GPT-6 Astra (max) 约为 2.7 万。
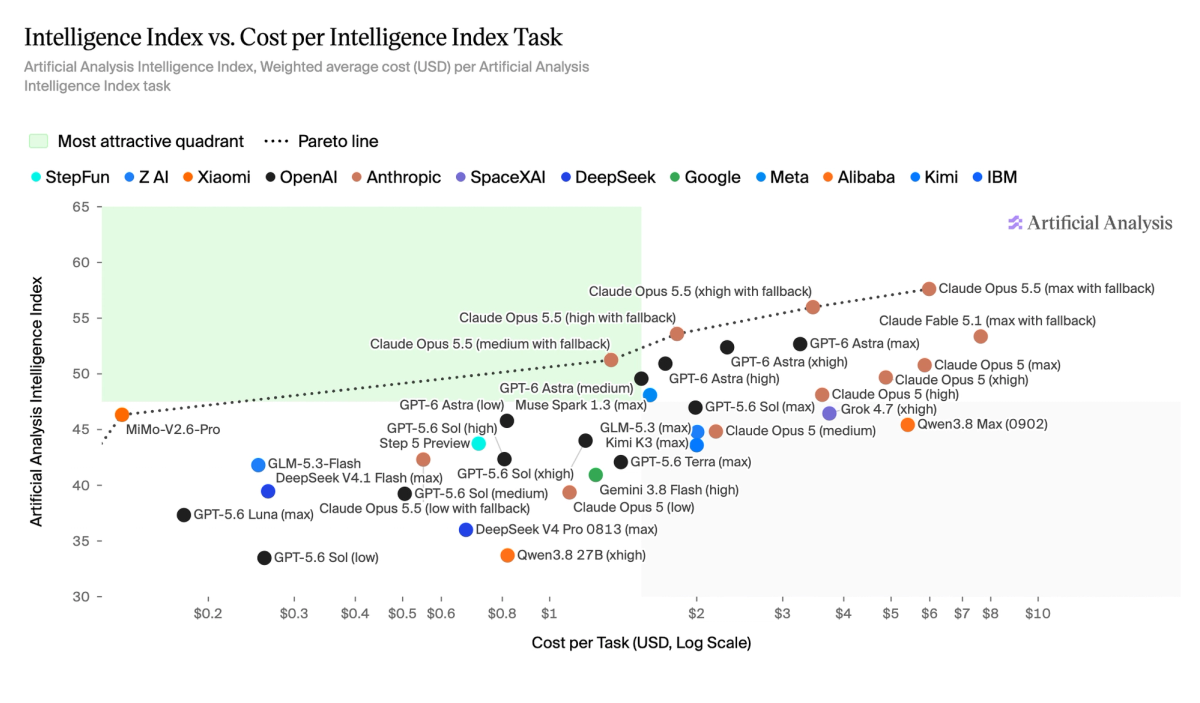
➤ 五个推理强度等级中有四个位于“智能 vs 单任务成本”的前沿曲线上: Opus 5.5 的 max、xhigh、high 和 medium 等级均位于帕累托前沿(Pareto frontier),即在成本更低或性能更优方面超越了其他得分超过 50 分的模型(GPT-6 Astra、Claude Fable 5.1 和 Claude Opus 5)。
其他模型细节:
➤ 上下文窗口: 支持图像和文本输入的 100 万 token 上下文窗口,与 Opus 5 保持不变。
➤ 定价: 每百万输入/输出 token 价格为 20,较 Opus 5 的 25 下降 20%。5 分钟 TTL 的缓存写入价格为每百万 token $5,较之前的 $6.25 有所下降。缓存读取价格进一步优惠至每百万 token $0.20,较 Opus 5 的 $0.50 下降 60%。与非缓存输入价格相比,折扣高达 95%,高于之前 Opus 模型的 90% 折扣率。
➤ Effort 设置: 五种 Effort 设置(low、medium、high、xhigh 和 max)。Intelligence Index 评估在全部五种设置下运行,并启用了 Anthropic 的默认 fallback。
Claude Opus 5.5 的五种 effort 级别中有四种位于“智能 vs 单任务成本”前沿:Opus 5.5 的 max、xhigh、high 和 medium 均处于 Pareto 前沿,相较于得分超过 50 的其他模型,要么成本更低,要么性能更优。
Claude Opus 5.5 (max) 在 agentic knowledge work 中表现卓越。它在 AA-Briefcase v1.1 中以 1,822 Elo 领先(比 Fable 5.1 高 +143),并在 GDPval-AA v2.1 中以 1,846 Elo 领先(比 Claude Fable 5.1 高 +111,比 Claude Opus 5 高 +138)。在 AA-Briefcase 上,它在分析质量和展示子评分方面均处于领先地位,仅在基于 rubric 的评分上略低于 Fable 5.1。
如需了解 Claude Opus 5.5 的更多细节和 benchmark,请访问 https://artificialanalysis.ai/models/claude-opus-5-5