AWS Machine Learning Blog · 2026/10/23 02:00:01
AWS SageMaker 推出训练会话 API 支持无 GPU 管理自定义循环
Amazon SageMaker AI 推出新的训练会话 API,允许开发者在无需管理底层 GPU 基础设施的情况下编写完全自定义的模型训练循环。该功能通过抽象计算资源而非算法逻辑,解决了传统托管服务缺乏灵活性而自建集群运维成本高的痛点,支持如自定义损失函数、强化学习奖励机制等高级微调场景。
报道全文原始报道全文
本文目录9 个章节
如今,对大语言模型(LLM)进行微调通常需要在训练循环控制与运维简便性之间做出权衡。使用全托管服务时,你只需选择基础模型、提供数据和超参数,其余一切均由服务负责,这在标准预置方案契合你的问题时效果很好。低托管程度更高的服务虽然提供了更多控制权,但也要求你管理更多的底层基础设施和训练框架。有时,标准方案并不够用:你可能需要为监督微调(SFT)定制损失函数或数据课程,实现自己的偏好优化算法,定义强化学习(RL)奖励函数,或者采用上周刚发布的对齐算法。一旦你需要自行塑造训练流程,就必须承担相应的基础设施工作以换取算法自由度。
今天,Amazon SageMaker AI 中的无服务器模型定制功能通过引入训练会话 API(training session APIs)得以扩展,这些 API 通过将抽象边界下移一层来消除上述权衡。它们不再抽象掉算法,而是抽象掉计算资源。诸如 forward_backward()、optim_step() 和 sample() 等操作变成了 SageMaker API 调用,你可以将这些调用组合成任何技术所需的流程:SFT、偏好优化、RL 或其他新方法。这些调用针对的是实时、有状态的会话,因此模型在各步骤间始终加载在 GPU 上,你可以按需对其发起任意数量的调用。该服务负责运行时设置、分布式执行、梯度同步、故障恢复、租户隔离以及大规模 GPU 运行的运维工作。你编写训练循环,SageMaker AI 运行基础设施。
伴随该服务的发布,我们还推出了 SageMaker 训练会话 Cookbook,这是一套可直接运行的 SFT 和 RL 配方,可作为你自己训练循环的蓝图。
在本文中,我们将介绍编程模型和三个 SDK 客户端,并展示训练会话 API 在 SageMaker AI 模型训练和定制选项中的定位。随后,我们将拆解一个在小学数学问题数据集(GSM8K)上的最小化 RL 循环,以展示各操作如何协同工作,最后以一个来自 Cookbook 的真实工作负载收尾:在竞赛编程问题上进行强化学习,其中生成的代码通过运行单元测试来进行评分。
什么是 SageMaker AI 训练会话 API?
借助 SageMaker AI 训练会话 API,你可以从本地机器上的 Python 进程中驱动一个实时的、由 GPU 支持的会话。你调用相关操作,SageMaker AI 会在加载了所选基础模型以及你的低秩适配(LoRA)适配器的托管加速器上执行这些操作。无需预先描述整个任务的配置文件,也无需创建集群的步骤。你可以在代码中交互式地控制每一步发生的情况,从而快速迭代和调试。
职责划分如下:
| 你专注于 | 你编写 | SageMaker AI 处理 |
|---|---|---|
| 你的数据、RL 环境、智能体和算法 | 一个 Python 训练循环,其中调用 forward_backward()、optim_step() 和 sample() 等操作来处理需要 GPU 的步骤 | GPU 分配、模型和 LoRA 加载、分布式执行、故障恢复、检查点存储、安全性 |
该 API 围绕 SageMaker Python SDK 中的三个客户端组织,按顺序创建。ServiceClient 持有平台级设置(执行角色、模型包组、Amazon Simple Storage Service (Amazon S3) 输出位置,以及可选的 AWS Key Management Service (AWS KMS) 密钥和虚拟私有云 (VPC) 配置,你也可以在每次会话时覆盖这些设置),并启动一个会话。ServiceClient 实例化一个 TrainingClient(用于训练和检查点操作,如 forward、forward_backward、optim_step 和 save_weights_for_sampler),后者又实例化一个 SamplingClient(用于生成和评分操作,如 sample 和 compute_logprobs,适用于 rollout 和评估期间)。每个 API 调用对应于你循环中的一个操作。活动会话还会提供一个兼容 OpenAI 的聊天补全端点,因此现有的 OpenAI 客户端代码可以从中进行采样。
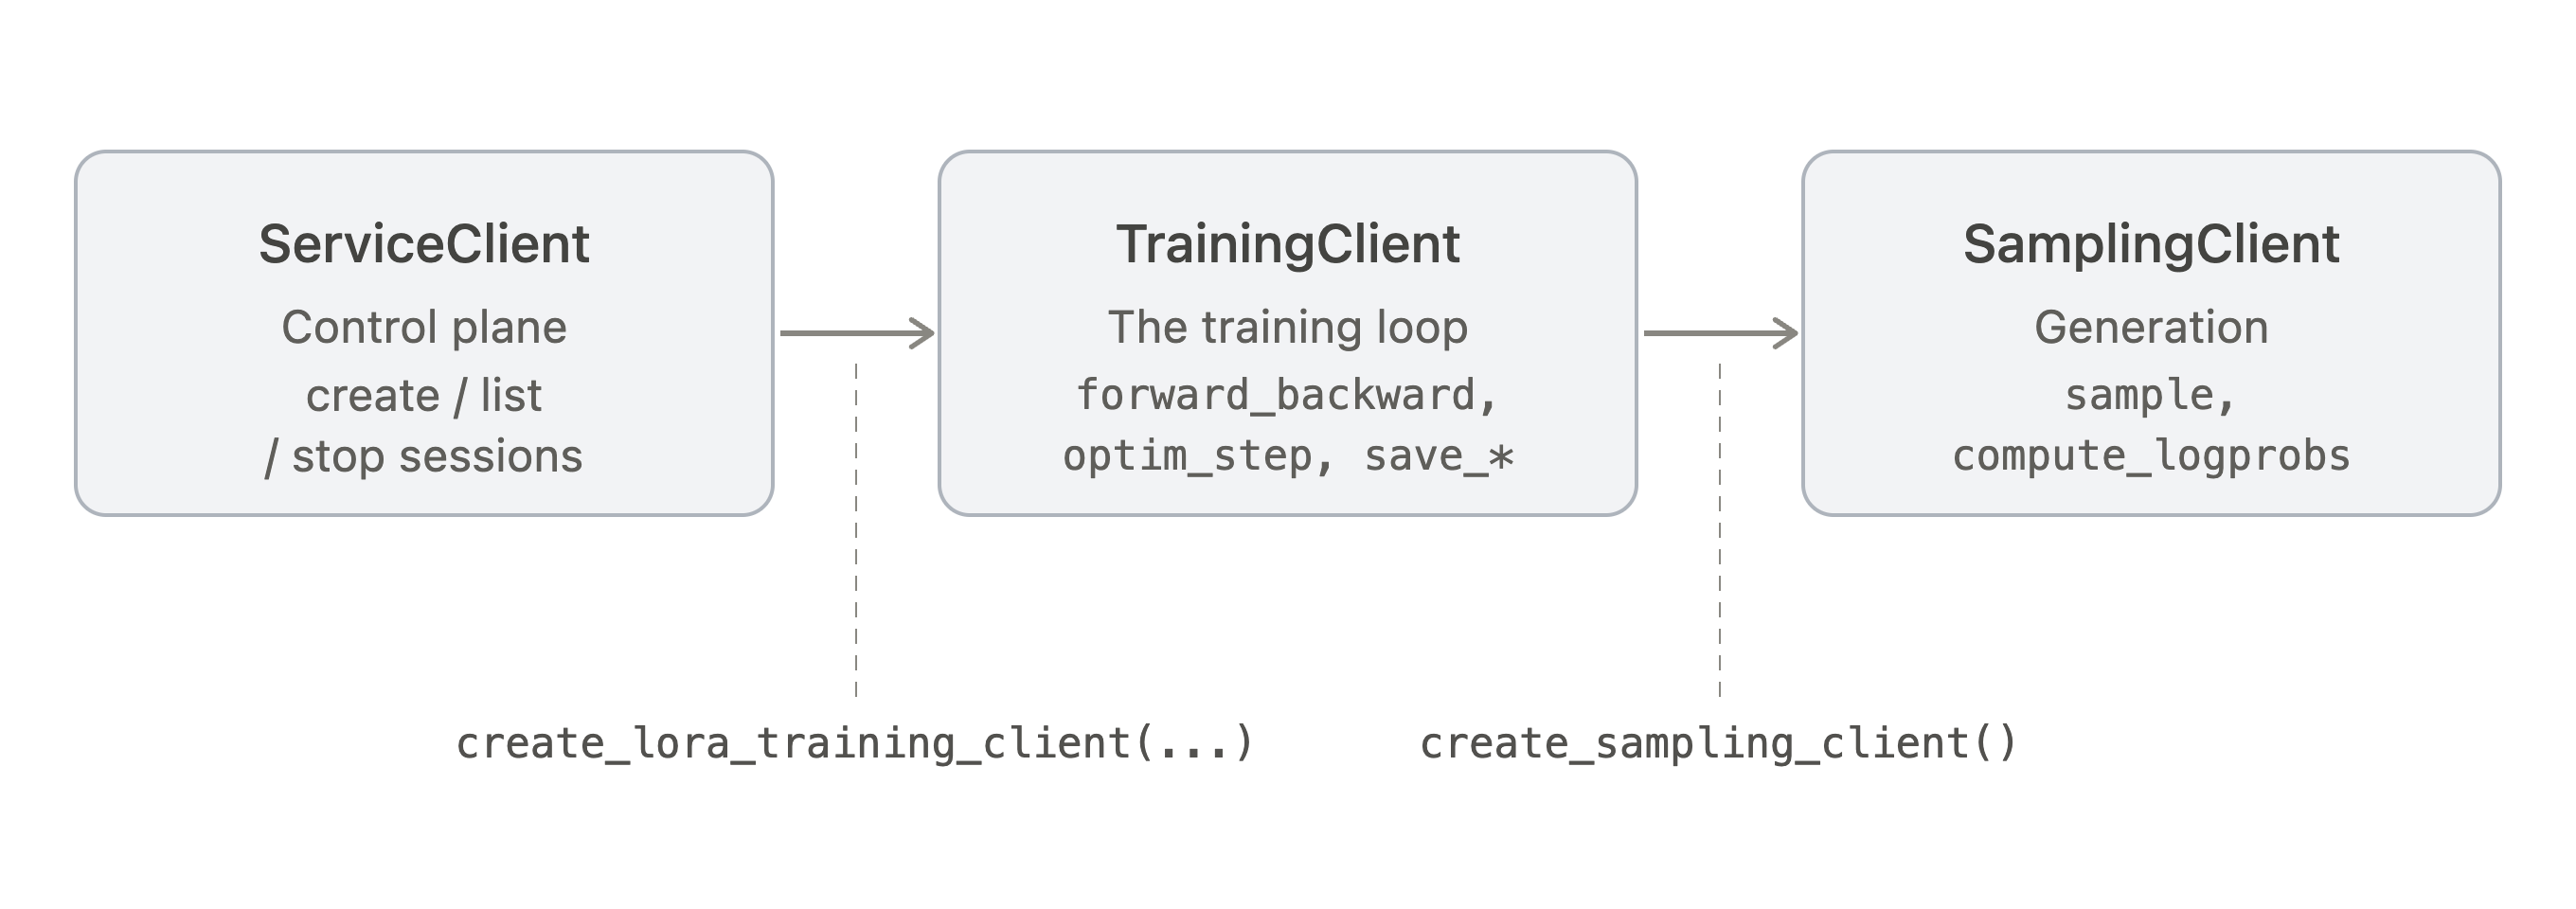
图 1:用于训练会话 API 的 SageMaker Python SDK 客户端层级结构
对于强化学习,其训练循环具有典型的形态。下图展示了一个训练步骤以及各部分的运行位置:绿色步骤调用托管 GPU 上的 API,而紫色步骤(你的循环控制和奖励逻辑)则在本地机器上运行。

图 2:一个训练步骤,其中采样、梯度和检查点操作在托管 GPU 上执行,而循环控制和奖励逻辑在本地机器上执行
每个步骤加载一批提示词(prompts),并 (1) 在 GPU 上从当前模型进行采样。随后,你的 Python 代码 (2) 对这些输出进行评分:可以是验证器、奖励模型调用、测试框架,或任何你能用代码表达的逻辑。(3) forward_backward 和 optim_step 将评分转化为 GPU 上的梯度更新,而 (4) save_weights_and_get_sampling_client() 刷新采样器,以便下一步从更新后的模型中进行采样。
你拥有数据、循环控制和奖励机制;SageMaker AI 负责执行受限于 GPU 的采样、梯度和检查点操作。同样的底层原语也适用于 监督微调(SFT)和其他 LLM 训练技术。对于 SFT,只需省略采样和奖励步骤,直接调用 forward_backward,并在带标签的样本上使用 cross_entropy 损失函数即可。
适用对象及在 Amazon SageMaker AI 中的定位
当你需要快速迭代周期和算法自由度时——例如自定义损失函数、新的 RL 奖励信号或多阶段流水线——但又不想自行配置或运维 GPU 基础设施,Training Session APIs 是理想的起点。
按处理的 token 数量计费,因此你只需为循环实际消耗的计算资源付费。如果你的奖励函数在本地机器上对一批数据进行评分需要 10 秒,那么在此期间不会扣除任何 GPU 时间费用。与按小时计费的 GPU 模式相比,这种机制具有两个实际优势。首先,没有空闲 GPU 成本:奖励计算、数据加载、日志记录和调试均在“非计费时段”完成,只有当你调用依赖 GPU 的操作时才会产生费用。其次,成本随数据集规模和生成量线性扩展,而不受挂钟时间(wall-clock time)或集群大小的影响,这使得支出更容易预测,实验也更容易对比。对于涉及大量本地计算的工作负载(例如复杂的奖励模型、多工具智能体 rollout 或人在回路评估),相较于在整个会话期间预留 GPU,这种方式可带来显著的成本节省。
训练会话 API 专为那些核心工作由训练算法定义(而不仅仅是数据集)的团队打造。由于你可以自行组合训练循环,相同的底层原语支持多种场景:使用 cross_entropy 损失函数对标注数据进行监督微调(SFT)、使用 ppo、importance_sampling 或 cispo(包括 GRPO、PPO 及其他组相对方法)进行强化学习,以及基于相同组件构建的自定义目标函数(如偏好优化或蒸馏)。这些 API 适用于以下场景:
- 实施 RL 方法(GRPO、PPO、重要性采样变体)、自定义优势估计器或新目标函数的后训练与对齐研究人员。
- 需要进行监督微调或偏好优化,且要求非标准损失函数、数据课程安排或多阶段流水线(这些无法通过配置驱动的配方表达)的团队。
- 需要自定义 rollout 逻辑、奖励塑形和课程安排的智能体及多轮 RL 构建者。
- 已超越配置驱动微调需求,但又不愿承担 GPU 集群运维负担的机器学习(ML)工程师。
- 移植现有训练循环代码的研究人员,因为基于操作的编程模型可直接映射到针对底层
forward_backward、optim_step和sampleAPI 编写的循环中。
支持的基座模型及其可用的 AWS 区域列于训练会话 API 文档中。
训练会话 API 在 Amazon SageMaker AI 中的定位
SageMaker AI 中的模型定制选项里,训练会话 API(Training Session APIs)处于一个独特的位置:相比完全托管的 Serverless Model Customization,它对训练算法拥有更多的控制权;而相比在 Amazon SageMaker Training Jobs 或 Amazon SageMaker HyperPod 上进行训练,它所需的运维责任则少得多。
| 选项 | 对训练的控制权 | 基础设施 |
|---|---|---|
| SageMaker Serverless Model Customization – Managed APIs | 低 – 选择模型,配置可用的超参数并提供数据 | Serverless,无需选择实例 |
| SageMaker Serverless Model Customization – SageMaker AI training session APIs | 高 – 你编写训练循环,调用底层原语 | Serverless,无需选择实例 |
| SageMaker Training Jobs | 完全控制 | 托管型、临时性作业,需自行选择实例类型 |
| SageMaker HyperPod | 完全控制 | 托管型、持久化集群,具备高级故障恢复能力 |
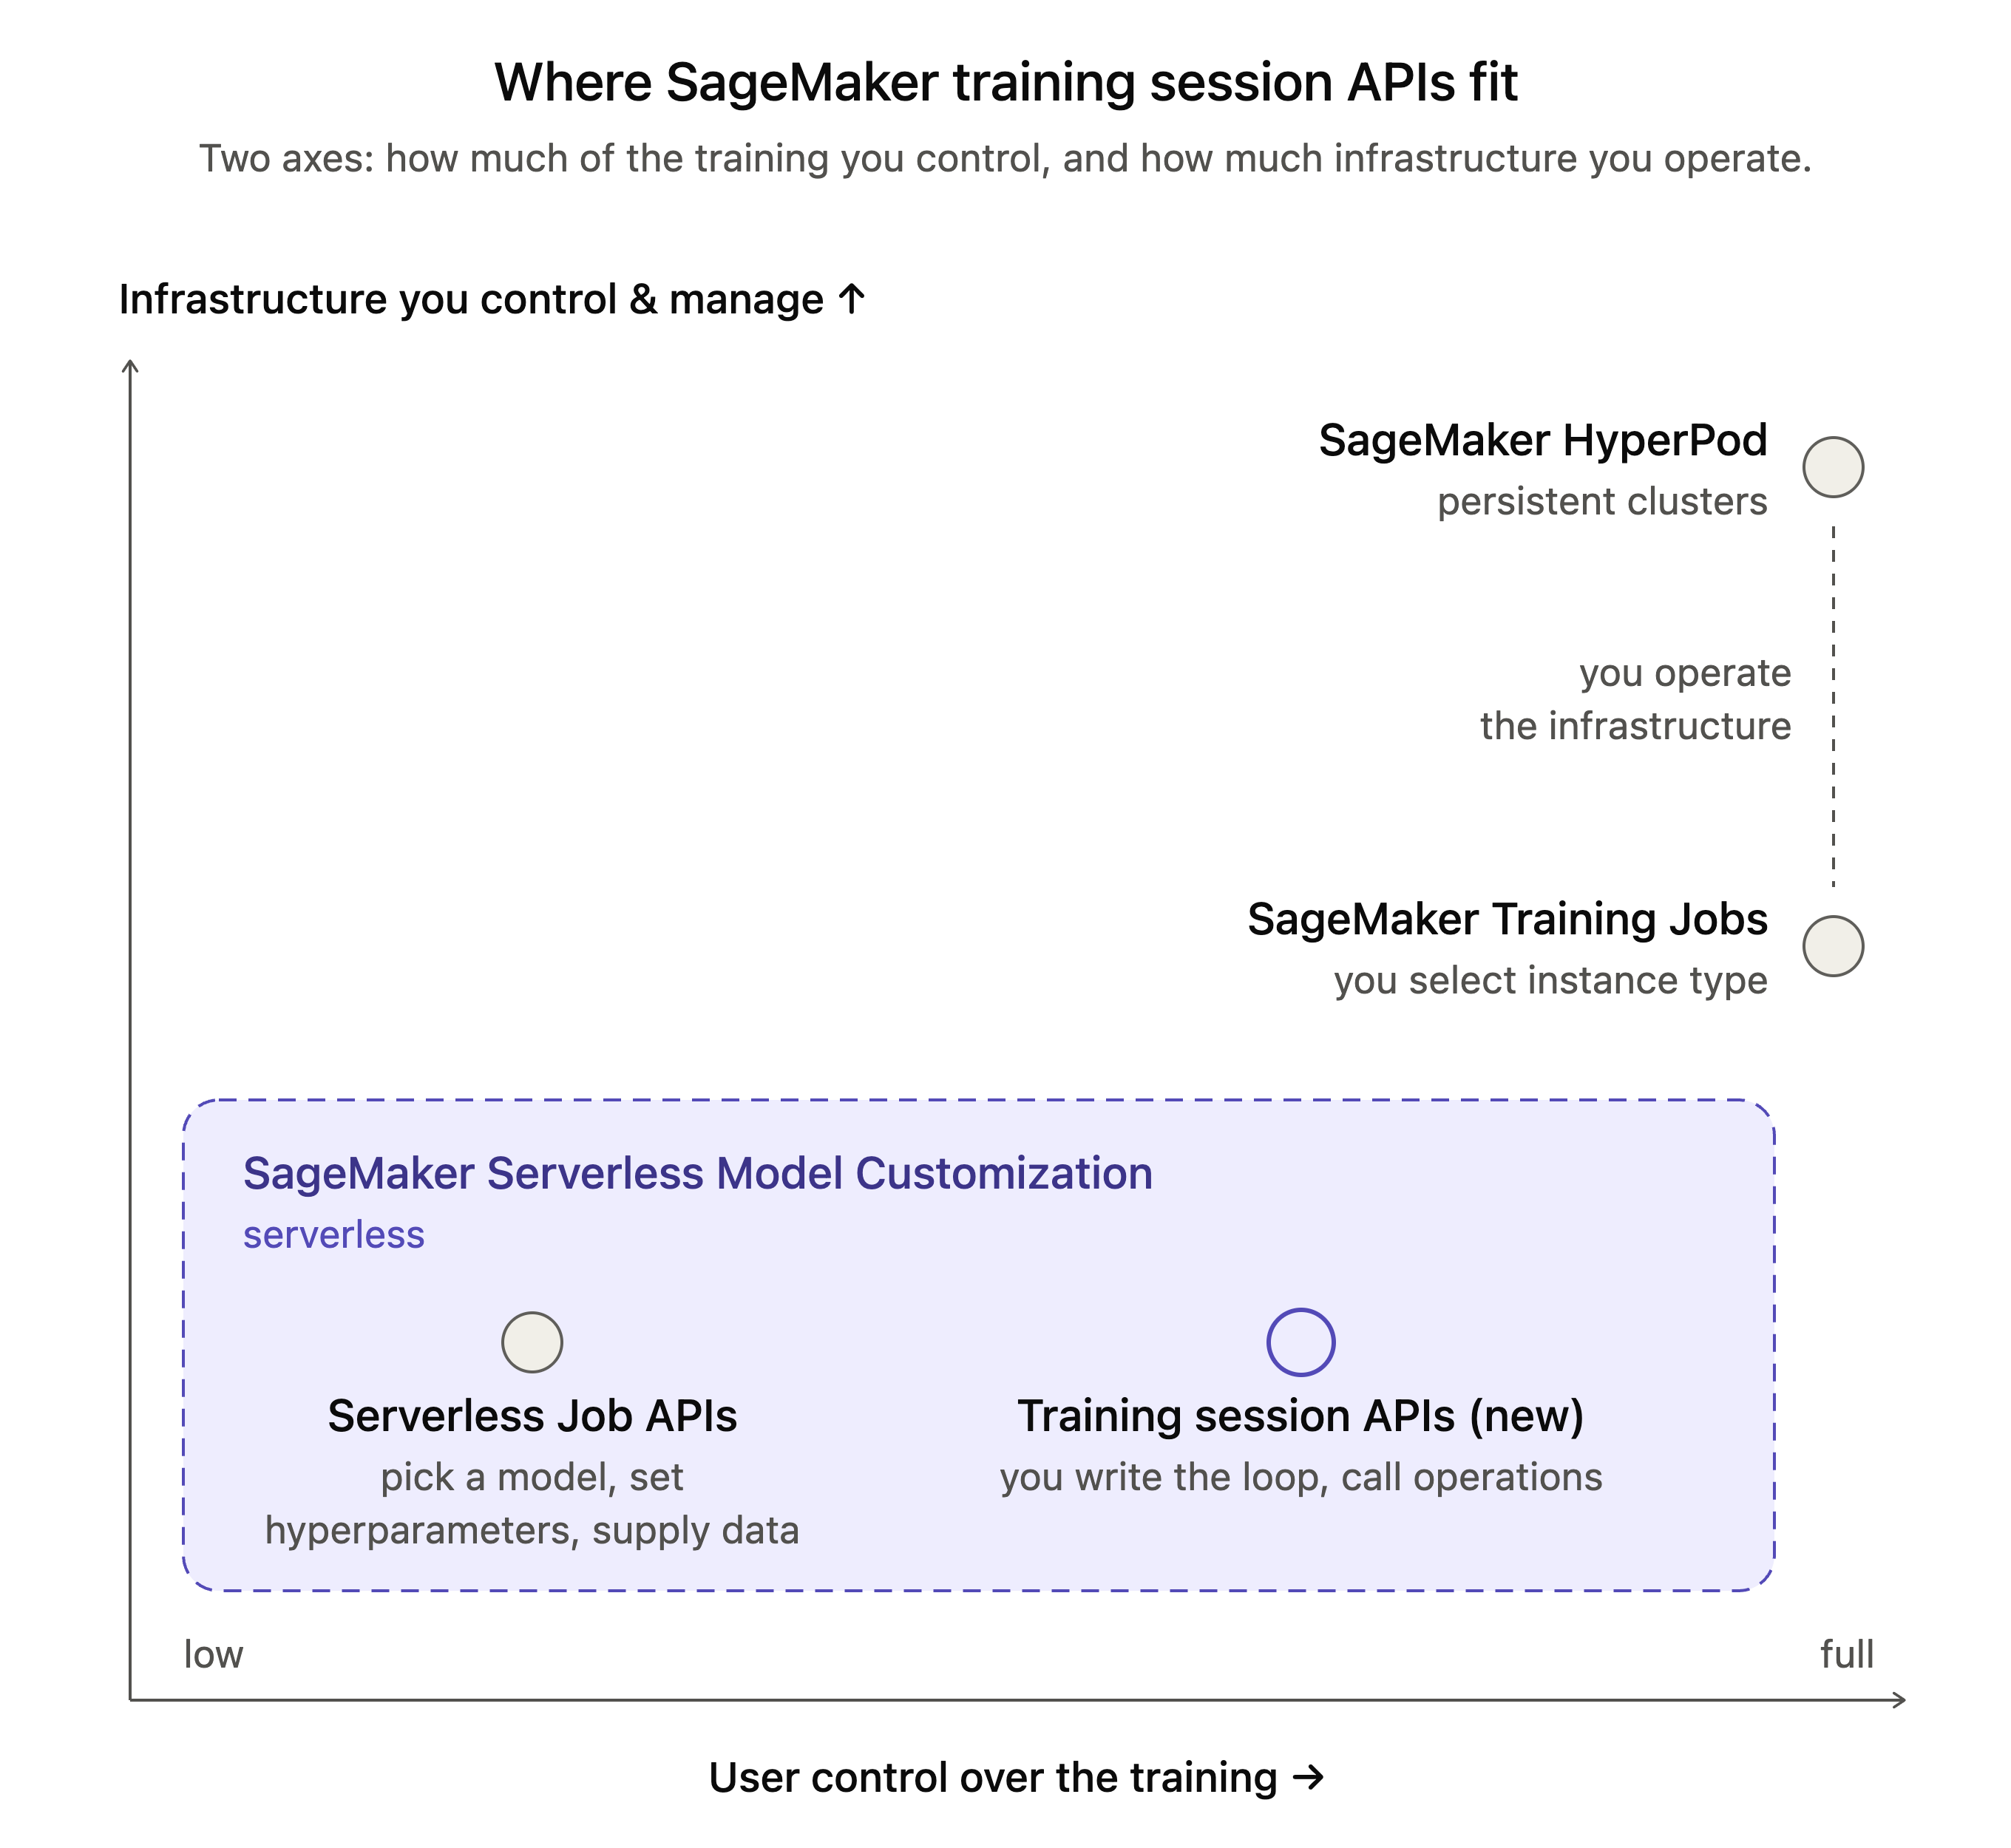
图 3:训练会话 API 在 SageMaker AI 模型定制选项中的定位
训练循环剖析:针对数学问题的 GRPO
Natalia 在四月份卖出了 48 个夹子给她的朋友,五月份卖出的数量是四月份的一半。Natalia 在四月和五月总共卖出了多少个夹子? → 72
我们使用组相对策略优化(Group Relative Policy Optimization, GRPO)为 OpenAI 的 GPT-OSS 20B 训练一个 LoRA 适配器:对于每个问题,模型生成多个回答,对每个回答的正确性进行评分,并强化那些得分高于组平均值的回答。完整且可运行的示例位于 Amazon SageMaker examples repository。
在开启会话之前,请完成文档中的 先决条件。
开启会话
创建一个会话,然后从中获取 tokenizer 和一个 SamplingClient:
from sagemaker.train.training_session import ServiceClient, SamplingParams, AdamParams

svc = ServiceClient(role_arn=role, region=REGION)

training_client = svc.create_lora_training_client(
    "openai/gpt-oss-20b",                        # a name from svc.list_base_models()
    training_session_name=SESSION_NAME,
    rank=32, alpha=64,                           # LoRA rank and scaling factor
    model_package_group_arn=MODEL_PACKAGE_GROUP_ARN,
    s3_output_path=OUTPUT_S3_PATH,
)
tokenizer = training_client.get_tokenizer()
sampling_client = training_client.create_sampling_client()
任务特定的逻辑由两个简短的函数组成,它们在您的本地机器上运行:
def compute_reward(response_text, ground_truth):
    predicted = extract_answer(response_text)      # parse the number after "#### "
    return 1.0 if predicted == ground_truth else 0.0

def compute_advantages(rewards):
    rewards = np.array(rewards)
    advantages = rewards - rewards.mean()          # center within the group (the GRPO baseline)
    return advantages / (rewards.std() + 1e-8)     # normalize
循环过程
每一步都遵循图 2 中所示的四个阶段。draw、build_prompt 和 build_training_datum 是示例中的简短辅助函数:
for step in range(NUM_STEPS):
    datums, pending = [], []
    # (1) sample K responses per question in one request each (GPU); returns a future right away
    for question, ground_truth in draw(PROMPTS_PER_STEP):          # data loading is local
        prompt = tokenizer.encode(build_prompt(question), add_special_tokens=False)
        pending.append((prompt, ground_truth, sampling_client.sample(
            prompt, num_samples=K,
            sampling_params=SamplingParams(max_tokens=512, temperature=0.7, top_p=0.9))))

for prompt, ground_truth, future in pending:
        result = future.result()                                    # wait once the batch is in flight
        # (2) score each response, then center the rewards within the group (local)
        rewards = [compute_reward(tokenizer.decode(s.tokens), ground_truth) for s in result.sequences]
        advantages = compute_advantages(rewards)
        datums += [build_training_datum(prompt, s, a) for s, a in zip(result.sequences, advantages)]
(3) 对批次执行一次梯度步骤(GPU);优化器步骤紧随其后
fwd_bwd_op = training_client.forward_backward(datums, loss_fn="ppo")
optim_op = training_client.optim_step(AdamParams(learning_rate=1e-5))
fwd_bwd_op.result(), optim_op.result()
(4) 刷新采样器,以便下一步的 rollout 来自更新后的策略(GPU)
sampling_client = training_client.save_weights_and_get_sampling_client()training_client.stop()
以下三个细节使该循环得以正常运行:

操作返回 Future。每个 GPU 绑定调用都会立即返回一个 `APIFuture`:请求由后台提交器排队并发送,而 `.result()` 会等待值返回。循环会在等待任何请求之前提交当前步骤的所有采样请求,因此整个批次可以并发生成。训练操作按调用顺序运行,因此可以在 `forward_backward` 完成之前提交 `optim_step`。

Datum 包含损失函数所需的一切信息。`build_training_datum` 打包了提示词和响应 token、来自 `sample()` 的每 token logprobs、优势值(advantage),以及一个用于将提示词排除在损失计算之外的 `weights` 掩码。

检查点是模型包。每次保存都会在您的模型包组中注册一个版本,包括上述循环中的每步采样器刷新。训练结束后,再执行两次保存以添加用于部署的合并模型以及包含权重和优化器的可恢复状态。

```python
training_client.save_weights_for_sampler(merge_weights=True).result()   # 合并后的可部署模型
training_client.save_state().result()                                   # 可恢复状态(权重 + 优化器)
若要恢复训练,请使用 create_training_client_from_state_with_optimizer 从最新检查点启动新会话。
在您调用 stop() 或会话过期之前,正在运行的会话会占用您的并发会话配额,因此在完成时(包括错误路径)请停止它,或者使用 with 块打开客户端。合并后的检查点会部署到实时端点。若要将检查点作为 LoRA 适配器提供服务,请参阅 cookbook 中的部署 notebook。
在我们的示例运行中,对 40 个问题执行 10 个训练步骤,使留出集准确率从 56% 提升至 75%。
真实世界工作负载:在竞赛编程上进行 RL
GSM8K 让机制清晰可见,但生产级 RL 工作负载引入了更多复杂性:更长的生成序列、多轮交互、外部评分器,以及足以保持 GPU 满载的吞吐量。SageMaker 训练会话 Cookbook 将这些工程实践封装为基于相同操作构建的可复用训练循环。对于新的 RL 任务,你只需定义一个环境:模型看到什么、其答案如何评分,以及是否获得另一轮机会。Cookbook 负责处理批处理、聊天模板、优势估计、采样与训练的重叠执行、验证、支持断点续训的检查点保存,以及逐步指标记录,并记录每次运行的配置以便复现。code_rl 配方利用它来针对竞争性编程问题训练模型。
任务。 题目来自 DeepCoder 数据集(训练集包含 PrimeIntellect、TACO 和 LiveCodeBench;测试集包含 Codeforces 和 LiveCodeBench)。模型编写 Python 解决方案,该方案在你机器上的 SandboxFusion 容器中针对题目的单元测试运行。如果所有测试通过,奖励为 1,否则为 0;如果响应中不包含代码块,则扣除 0.1 的惩罚。
多轮工具使用。 在两轮交互中,模型可以调用 check_solution 工具,读取测试结果,并在最终评分前修改其答案。工具调用及其结果以模型原生的聊天格式呈现,因此模型在训练时使用的 token 格式与其推理时完全一致。
该配方在最小化循环基础上增加了以下内容:
- 采样与训练重叠: Rollout worker 在 trainer 执行步骤的同时持续生成数据。如果从旧策略采样的响应组不超过 k 步,则直接使用;否则重新入队等待,并使用
cispo损失函数校正策略差异。 - 流式梯度计算:
forward_backward随着各组数据的完成被分批提交,而不是每步仅提交一次。 - 保留验证集、检查点续训及逐步指标,可选择发布到 SageMaker 托管 MLflow。
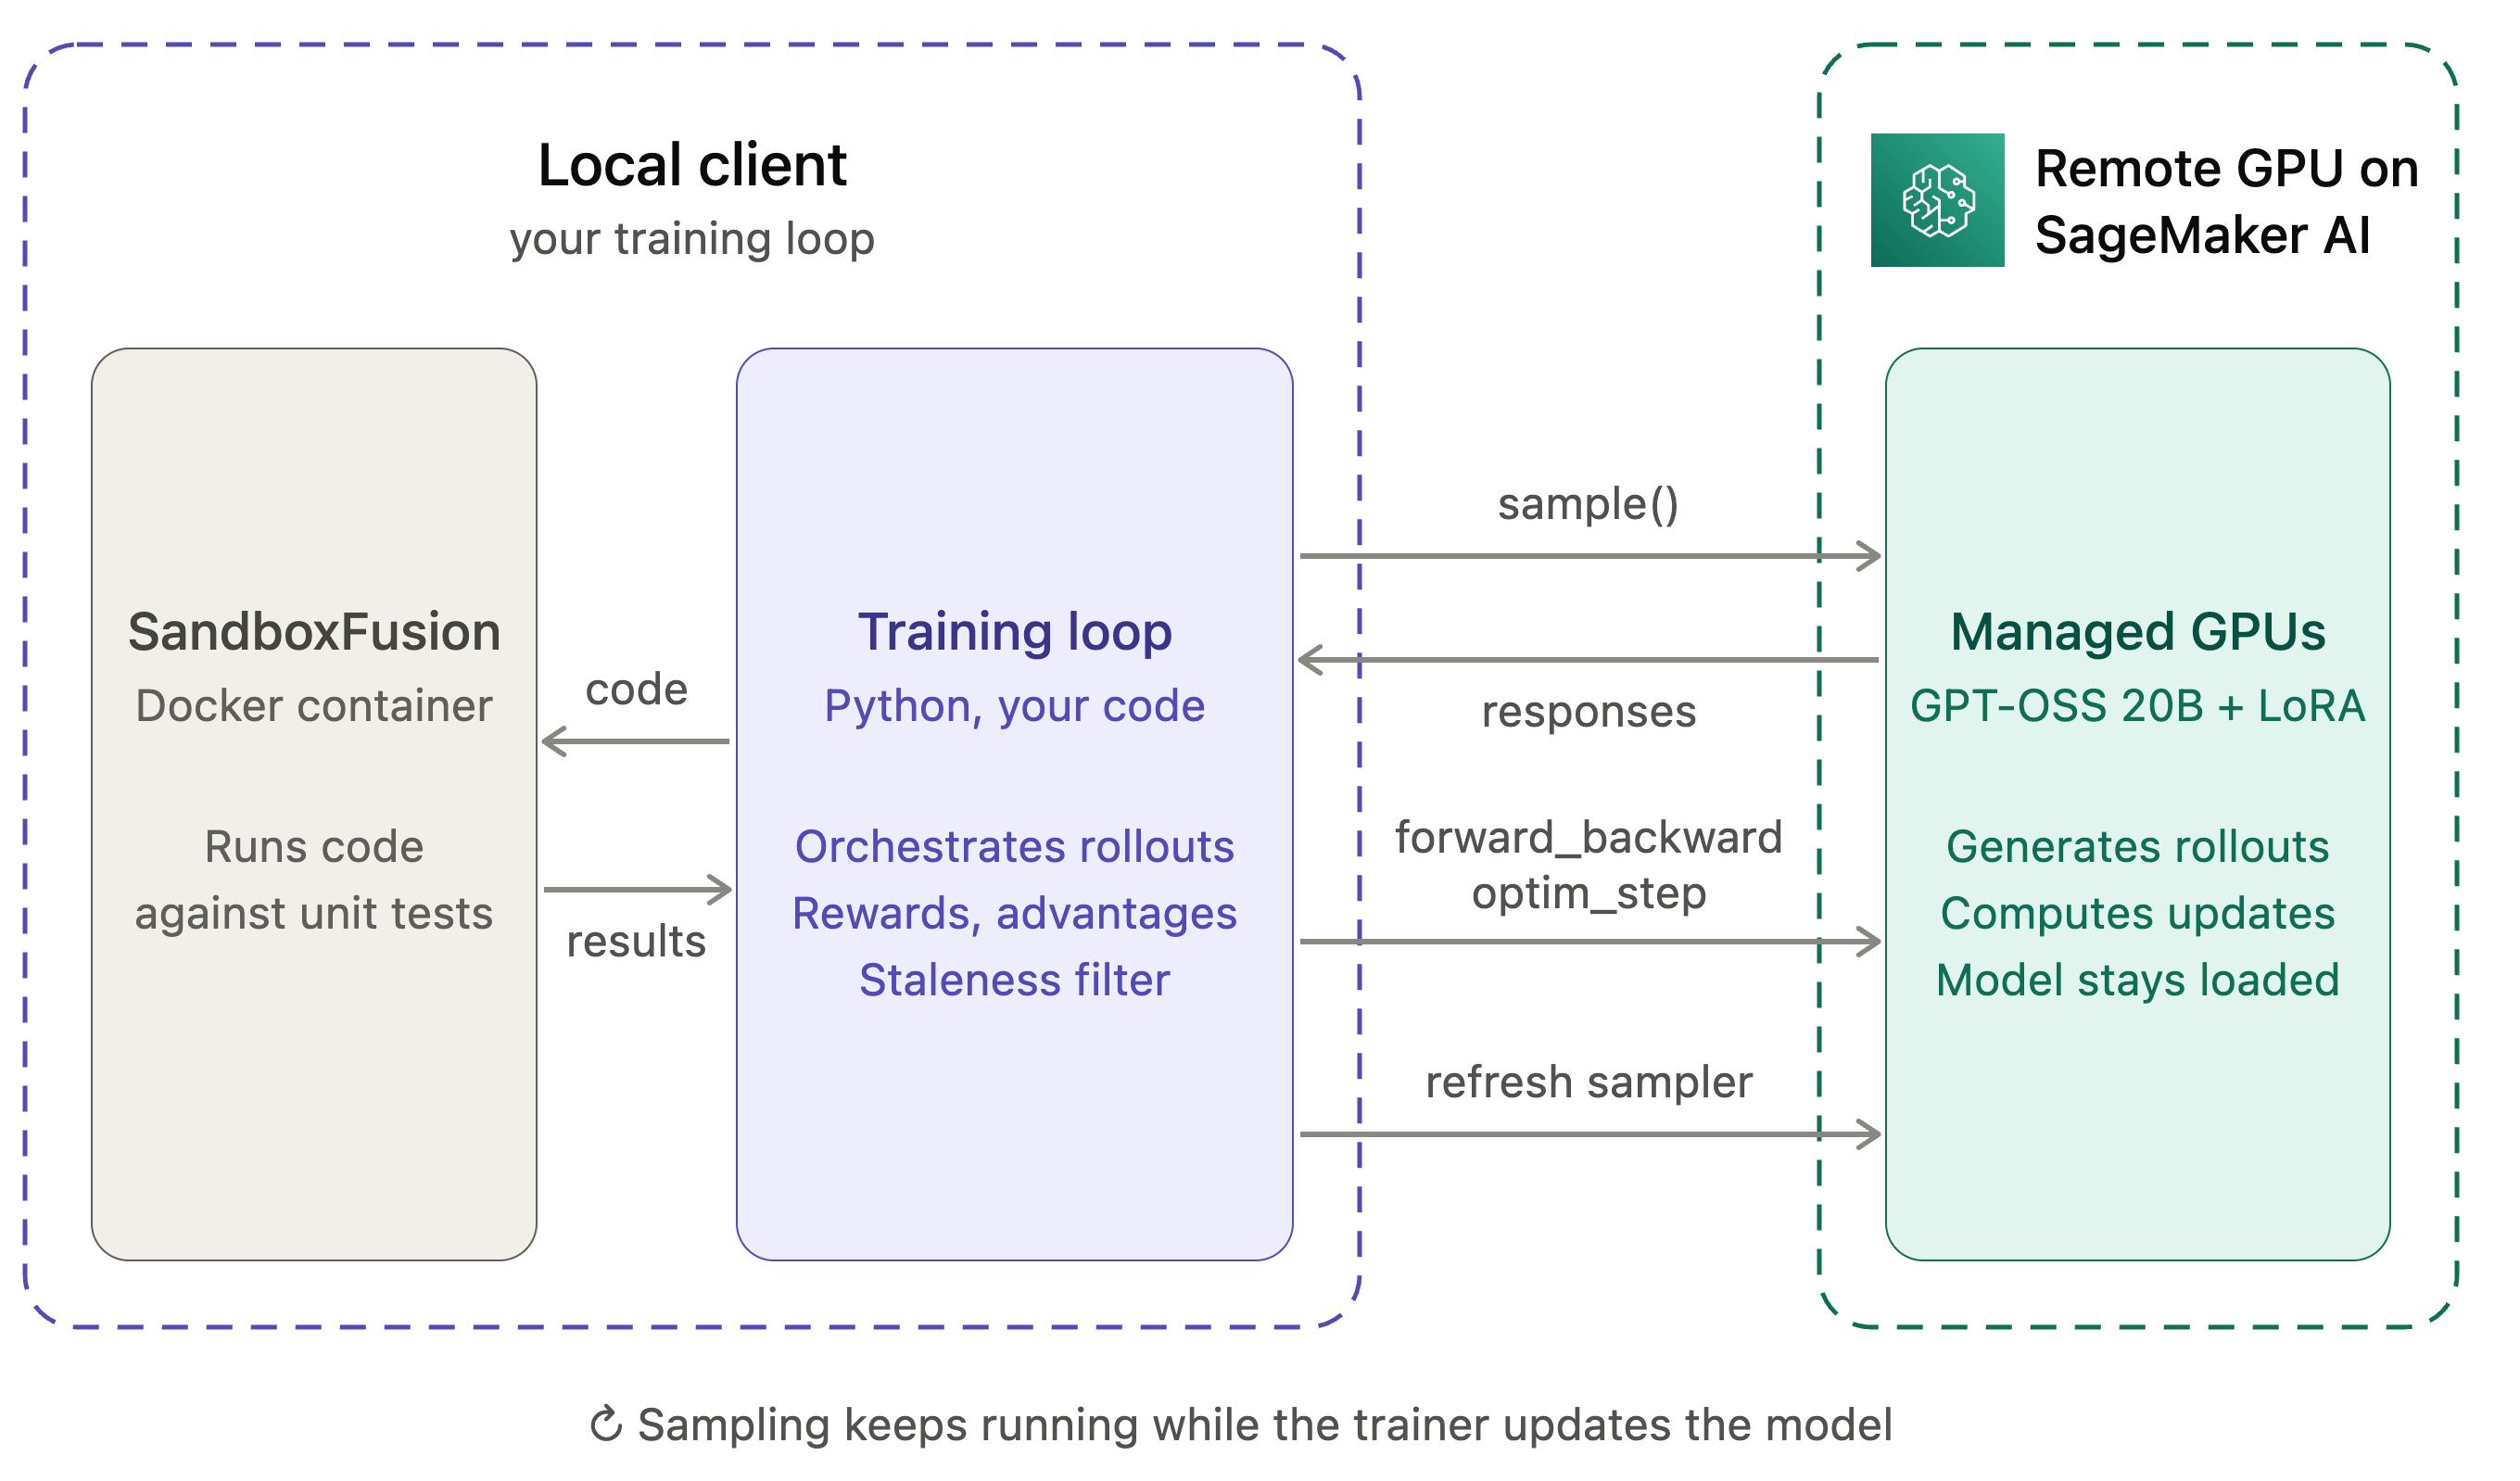
图 4:Code RL 设置,左侧为本地训练循环和沙箱,右侧为托管 GPU
我们为 GPT-OSS 20B 训练了一个 LoRA 适配器(rank 32),共进行 50 步,每步包含 128 个问题,每个问题生成 8 个响应,使用两轮对话并设置 staleness bound 为 k=3。训练奖励从 0.46 上升至 0.60,在 200 个保留测试问题上的准确率从 40% 提升至 50.5%。
要运行该流程,请先启动沙箱,然后执行以下 recipe:
bash tools/sandbox_up.sh
python -m training_sessions_cookbook.recipes.code_rl.train \
    --config training_sessions_cookbook/recipes/code_rl/configs/coderl_oss20b_service.json \
    --max_steps_off_policy 3 --stale_policy requeue --num_rollout_workers 80 --max_steps 50 \
    --base_model_arn "$BASE_MODEL_ARN" \
    --model_package_group_arn "$MODEL_PACKAGE_GROUP_ARN" \
    --role_arn "$ROLE_ARN" \
    --output_s3_path "$OUTPUT_S3_PATH"
Cookbook 中还提供了更多基于相同结构的 recipes,包括在聊天数据集(Tulu 3、UltraChat)上进行监督微调(SFT)、在全规模 GSM8K 数据集上进行强化学习(RL),以及基于二元反馈的 KTO 偏好对齐。每个 recipe 的 README 文件均列出了其命令、超参数及预期指标。
结论
SageMaker AI 训练会话 API 将抽象边界下移至训练操作层面:你在本地机器上用 Python 编写训练循环,服务则在托管 GPU 上运行该循环,并负责处理模型与 LoRA 加载、分布式执行、故障恢复及检查点保存。一个完整的 GRPO 循环可简化为四个操作:sample、forward_backward、optim_step 和 save_weights_and_get_sampling_client,而奖励与优势计算逻辑则保留在你自己的代码中。正如 Code RL recipe 所示,这些相同的操作可扩展至支持多轮对话和工具调用的强化学习场景,并实现沙箱化评分。
自定义奖励、智能体 rollout、逐步调试以及新发表的技术均采用相同的编程模型:算法始终在你的循环中,而 SageMaker AI 负责运行 GPU。
开始上手:
- 从 SageMaker 训练会话食谱中选择一个示例,例如 Code RL。
- 运行 Amazon SageMaker 示例仓库中的 GSM8K 示例,并替换为你自己的奖励函数。
- 阅读 训练会话 API 文档,了解前提条件、配额、区域、支持的模型以及 API 参考。
致谢
感谢 Arun Nagarajan、Xichao Wang 和 Shruti Sharma 对本文的贡献与指导。