Apple 研究:智能体泛化更依赖数据多样性而非任务量
原标题:New Apple paper finds that, as training data grows, tool-use agents gain more from diverse apps and ...
78AI 研判分
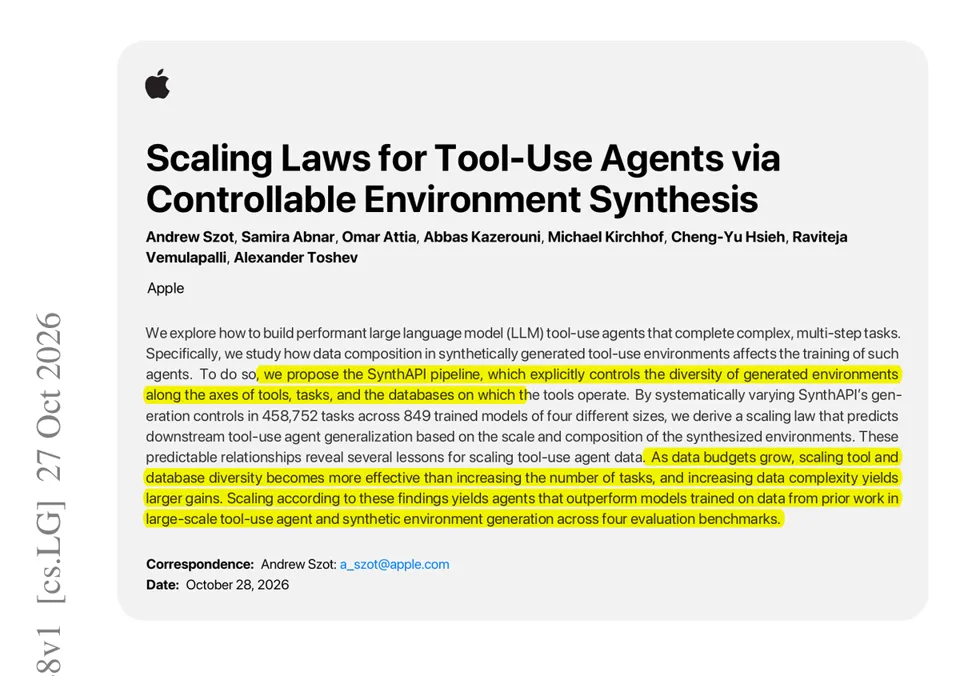
Apple 最新论文指出,在固定训练预算下,增加合成环境中的应用种类和数据库状态多样性,比单纯增加任务数量更能提升工具使用智能体的泛化能力。该研究通过 SynthAPI 框架验证了数据混合比例对模型性能的决定性作用,并提出了基于数据构成的缩放定律。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-10-29 04
苹果最新论文发现,随着训练数据量的增长,工具使用型智能体(tool-use agents)从多样化的应用和数据库状态中获得的收益,要高于单纯增加任务数量所带来的收益。
合成训练数据的构成比例——而不仅仅是其规模大小——决定了工具使用型智能体在新基准测试上的泛化能力。
团队在合成环境中训练工具使用型智能体,大多数流程都专注于生成更多任务。此前尚不清楚新工具、新任务还是新的初始数据最为关键。
他们构建了 SynthAPI,利用 LLM 代码生成带有真实 Python 工具和数据库的合成应用,并编写具有自动成功检查机制的任务。他们在 849 个训练模型中改变了应用、任务和数据库版本。
在固定 32,768 个任务的预算下,增加应用数量和数据库版本使一个 4B 参数模型在 AppWorld 挑战集上的表现从 38.4% 提升至 45.0%。他们的缩放定律(scaling law)追踪了数据混合情况,以 0.0285 的误差预测了更大的留出集运行结果,而仅基于任务数量的定律误差为 0.1706。