LangChain Blog · 2026/10/14 00:04:23
LangChain 披露 Harness 工程方法论:仅优化执行框架使编码智能体在 Terminal Bench 2.0 排名从 Top 30 跃升至 Top 5
LangChain 团队通过“Harness 工程”(围绕模型的执行框架优化)而非更换底层模型,成功将其编码智能体在 Terminal Bench 2.0 的排名从第 30 位提升至前 5。核心方法包括利用 LangSmith Traces 大规模分析失败模式、引入自我验证机制以及优化系统提示与工具调用流程,证明了在模型能力固定的情况下,精细化的外部脚手架设计能显著释放智能体潜能。
报道全文原始报道全文
本文目录12 个章节
Deep Agents可观测性与评估Agent 架构
通过 Harness Engineering 提升 Deep Agents 性能
TLDR:我们的编码 Agent 在 Terminal Bench 2.0 上的排名从 Top 30 跃升至 Top 5。我们仅修改了 harness(执行框架)。以下是我们在 harness engineering 方面的方法(剧透:自我验证与追踪帮助很大)。
Harness Engineering 的目标
Harness 的目标是将模型本质上“尖峰状”(spiky)的智能,塑造成适用于我们关注任务的能力。Harness Engineering 侧重于系统层面,即围绕模型构建工具链,以优化任务表现、token 效率、延迟等目标。设计决策包括系统提示词、工具选择以及执行流程。
但你应该如何调整 harness 来提升你的 agent?
在 LangChain,我们利用 Traces 来大规模理解 agent 的失败模式。当今的模型在很大程度上是黑盒,其内部机制难以解读。但我们可以在文本空间中观察它们的输入和输出,并将其用于改进循环中。
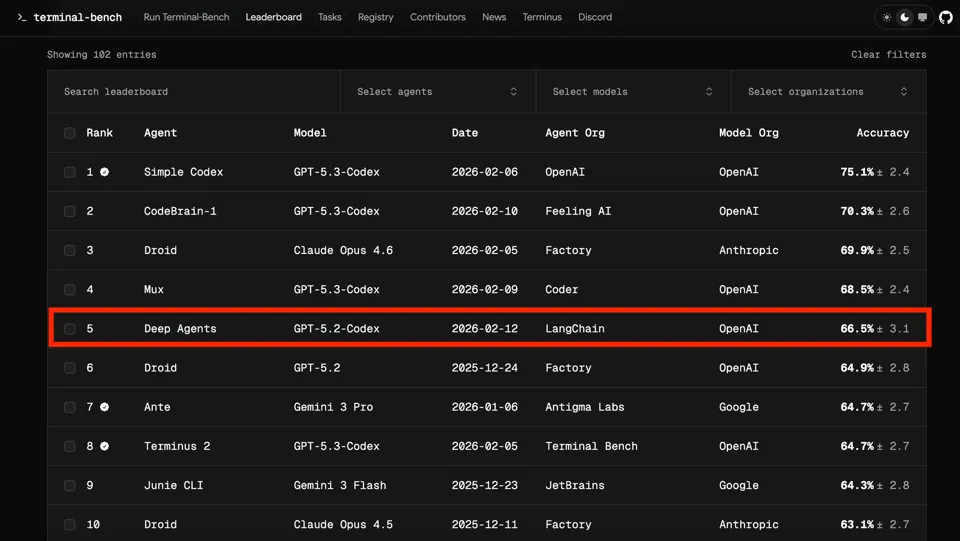
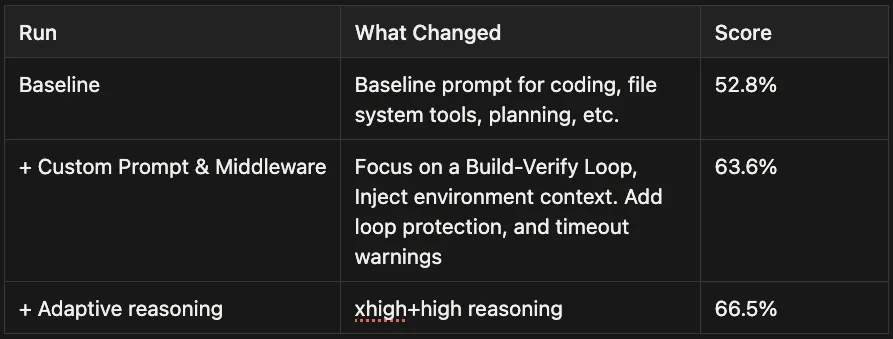
我们采用了一套简单的方案,迭代式地改进了 deepagents-cli(我们的编码 agent),使其在 Terminal Bench 2.0 上的得分提升了 13.7 分,从 52.8 提高到 66.5。我们只调整了 harness,而保持模型固定为 gpt-5.2-codex。
实验设置与 Harness 的可调参数
我们使用了 Terminal Bench 2.0,这是一个目前用于评估 agentic coding 的标准 benchmark。它包含 89 个任务,涵盖机器学习、调试和生物学等领域。我们使用 Harbor 来编排运行过程。它会启动沙箱环境(Daytona),与我们的 agent 循环交互,并执行验证 + 评分。
每个 agent 的动作都存储在 LangSmith 中。其中还包括延迟、token 数量和成本等指标。
我们可以调整的参数
Agent 框架(harness)包含大量可调参数:系统提示词、工具、钩子/中间件、技能、子 Agent 委派、记忆系统等。我们有意压缩优化空间,仅聚焦于三个核心维度:系统提示词、工具以及 中间件(即围绕模型调用和工具调用的钩子机制)。
我们从默认提示词和标准工具+中间件配置起步。该基线在 GPT-5.2-Codex 上取得了 52.8% 的得分——这是一个相当不错的成绩,虽未进入当前排行榜的前 30 名,但仍有提升空间。
Trace Analyzer Skill(轨迹分析技能)
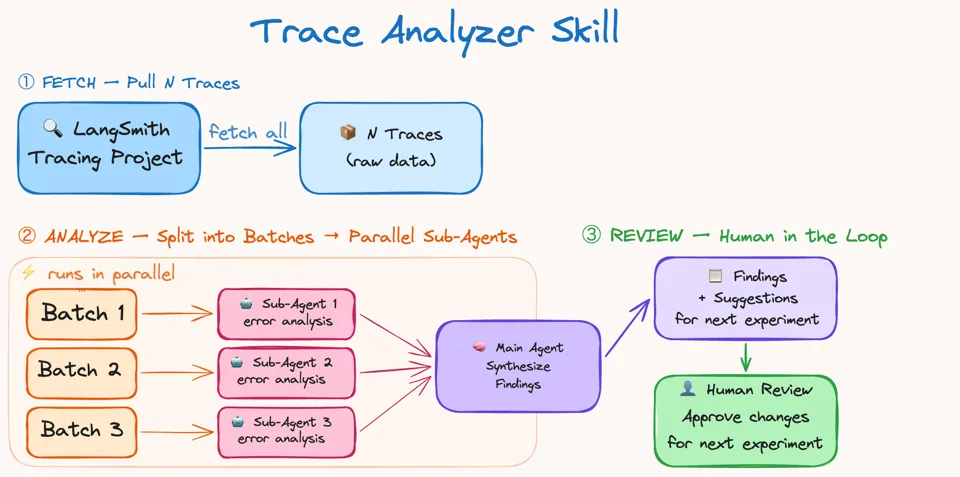
为了让轨迹分析具备可重复性,我们将其封装为一个 Agent Skill。该技能充当我们的“配方”,用于 跨多次运行分析错误并改进 Agent 框架。其工作流程如下:
- 从 LangSmith 获取实验轨迹数据
- 启动并行错误分析 Agent → 由主 Agent 综合发现结果并提出建议
- 汇总反馈并对 Agent 框架进行针对性修改
这一机制类似于 Boosting(提升法),重点关注前序运行中出现的错误。在第 3 步中,人工介入会非常有帮助(尽管并非必需),可用于验证和讨论拟议的修改方案。需要注意的是,过度拟合特定任务的修改不利于泛化能力,可能导致其他任务上的性能回退。
自动化轨迹分析节省了数小时的人工时间,并使快速尝试各类实验变得轻而易举。我们将很快发布此技能,目前正将其测试范围扩展至通用的提示词优化场景。
真正提升 Agent 性能的关键因素
自动化轨迹分析帮助我们 定位 Agent 出错的具体环节。发现的问题包括推理错误、未遵循任务指令、缺少测试与验证步骤、超时等。下文将详细阐述这些改进措施。
Build & Self-Verify(构建与自我验证)
当今的大模型是卓越的自我改进引擎。
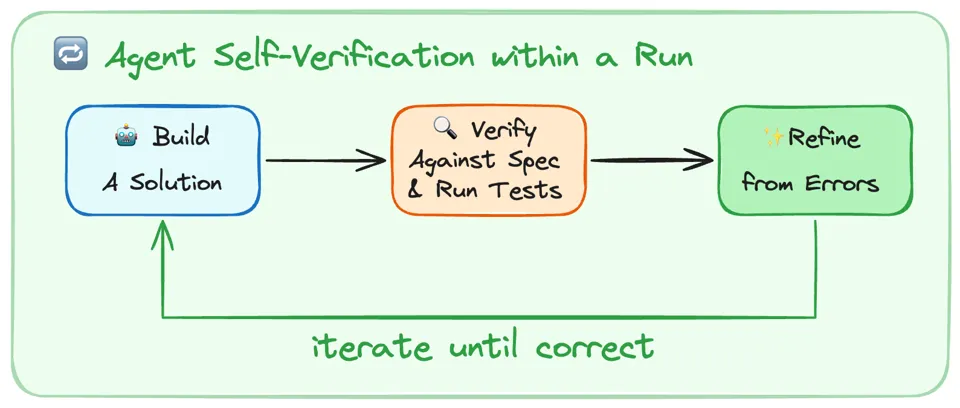
自我验证使 Agent 能够在单次运行内通过反馈实现自我提升。然而,它们并不天然倾向于进入这种 构建-验证循环。
最常见的失败模式是:Agent 写完解决方案后,重新阅读自己的代码,确认看起来没问题,然后就停止了。测试是自主 Agent 编程的关键组成部分。它不仅能帮助验证整体正确性,还能为 Agent 提供用于“爬山式”优化(hill-climb)的信号。
我们在系统提示词中增加了关于如何解决问题的指导原则。
- 规划与发现: 阅读任务说明,扫描代码库,并根据任务规范以及如何验证解决方案来构建初步计划。
- 构建: 在实施计划时始终将验证纳入考量。如果不存在测试,则编写测试,并覆盖正常路径和边缘情况。
- 验证: 运行测试,阅读完整输出,并与原始需求进行对比(而不是与自己的代码对比)。
- 修复: 分析任何错误,回顾原始规范,并修复问题。
我们高度重视测试,因为它驱动着每一次迭代的改进。我们发现,除了提示工程外,确定性的上下文注入也有助于 Agent 验证其工作成果。我们使用了一个 PreCompletionChecklistMiddleware,它在 Agent 退出前进行拦截,并提醒其对任务规范执行一次验证流程。这类似于 Ralph Wiggum Loop,即通过钩子强制 Agent 在退出时继续执行;我们将此机制用于验证环节。
为 Agent 提供环境上下文
Harness 工程的一部分是构建良好的上下文工程交付机制。 Terminal Bench 的任务包含目录结构、内置工具以及严格的超时限制。
- 目录上下文与工具链:
LocalContextMiddleware在智能体启动时运行,用于映射当前工作目录(cwd)及其父级和子级目录。我们执行bash命令来查找诸如Python安装等工具。由于上下文发现和搜索容易出错,注入上下文可以减少这种错误面,并帮助将智能体接入其环境。 - 教导智能体编写可测试代码: 智能体并不了解其代码需要满足何种可测试性要求。我们通过提示词告知它们,其工作成果将通过程序化测试进行评估,类似于提交代码时的流程。例如,任务规范中提到的文件路径必须严格遵循,以确保解决方案能在自动评分步骤中正常工作。强调边缘情况(edge-cases)的提示有助于避免智能体仅检查“正常路径”(happy path)的情况。强制模型符合测试标准是一种强大的策略,可以避免随着时间推移产生的“低质量代码堆积”(slop buildup)。
- 时间预算控制: 我们注入时间预算警告,以促使智能体完成工作并转向验证阶段。众所周知,智能体不擅长时间估算,因此在这种环境中,这一启发式方法很有帮助。现实世界的编程通常没有严格的时间限制,但如果不添加任何关于约束条件的知识,智能体将无法在时间范围内完成任务。
智能体对其环境、约束条件和评估标准了解得越多,就越能自主地自我引导其工作。
Harness 工程师的目的:准备并交付上下文,以便智能体能够自主完成工作。
鼓励智能体退一步并重新考虑计划
一旦确定了计划,智能体往往会变得短视,导致陷入“死循环”(doom loops),即对同一错误方案进行微小变体尝试(在某些轨迹中重复 10 次以上)。
我们使用 LoopDetectionMiddleware,通过工具调用钩子跟踪每个文件的编辑次数。当对同一文件进行 N 次编辑后,它会添加诸如“……请考虑重新审视你的方法”之类的上下文。这有助于智能体从死循环中恢复,尽管如果模型认为自己的方法是正确的,它仍可能继续沿相同路径执行。
重要说明。这是一种设计启发式方法,旨在规避当前感知到的模型问题。随着模型的改进,这些护栏很可能不再必要,但在今天,它们有助于智能体正确且自主地执行任务。
选择推理计算资源的投入程度
推理模型可以自主运行数小时,因此我们必须决定在每个子任务上投入多少算力。你可以对每个任务都使用最大推理预算,但大多数工作都能从优化推理算力支出中获益。
Terminal Bench 的超时限制带来了一种权衡。更多的推理有助于智能体评估每一步,但可能会消耗超过 2x 的 token/时间。gpt-5.2-codex 提供了 4 种推理模式:low、medium、high 和 xhigh。
我们发现,推理有助于制定计划以充分理解问题,因为某些 Terminal Bench 任务非常困难。一个好的计划能帮助我们更快地得到可行的解决方案。
后期阶段的验证也从更多的推理中受益,以便发现错误并提交解决方案。作为一种启发式方法,我们选择 xhigh-high-xhigh 的“推理三明治”作为基线。
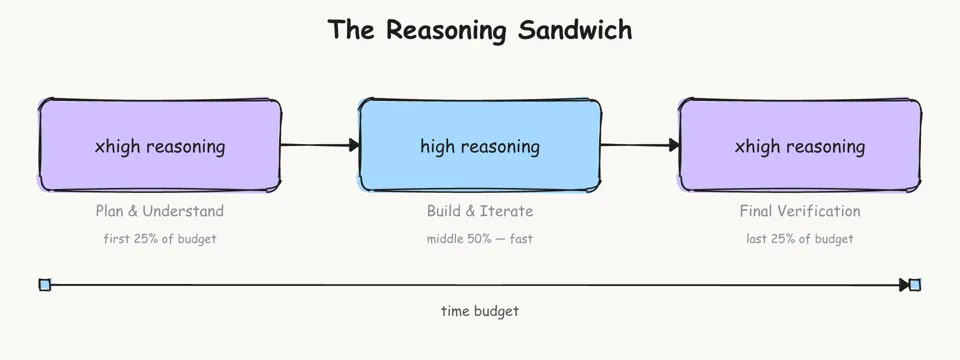
在规划和验证阶段投入更多推理算力
仅使用 xhigh 模式得分较低,为 53.9%,原因是智能体超时;相比之下,high 模式的得分为 63.6%。在不同推理预算分配下的试验运行之间没有显著差异,因此我们坚持采用我们的方法,将得分提升至 66.5%。
对于模型而言,自然的方法是 自适应推理(Adaptive Reasoning),这在 Claude 和 Gemini 模型中已有体现,即由模型自行决定在推理上投入多少算力。
在多模型框架中,平衡推理预算可能表现为使用大模型进行规划,并交接给较小的模型进行实现。
构建智能体框架的实践要点
智能体的设计空间很大。以下是我们从实验以及构建 deepagents 过程中总结出的一些通用原则。
-
为 Agent 进行上下文工程(Context Engineering)。 对于当前的 Agent 而言,上下文组装仍然是一项挑战,尤其是在未见过的环境中。通过向模型提供目录结构、可用工具、编码最佳实践以及问题解决策略等上下文信息,有助于缩小因搜索不佳和规划中可避免错误导致的误差范围。
-
帮助 Agent 自我验证工作成果。 模型往往倾向于其首个看似合理的解决方案。应强烈提示模型通过运行测试和改进方案来验证其工作。这对于没有人类介入(human-in-the-loop)的自主编码系统尤为重要。
-
将追踪(Tracing)作为反馈信号。 追踪记录允许 Agent 进行自我评估和调试。同时调试工具链和推理过程至关重要(例如:模型走错路径可能是因为缺乏某个工具或相关操作指令)。
-
在短期内检测并修复不良模式。 当前的模型并不完美。Harness(执行框架/外壳)设计者的任务是在围绕当前模型的不足进行设计的同时,也为未来更智能的模型做好规划。盲目重试和不验证工作成果就是典型的例子。这些护栏机制几乎肯定会随着时间推移而逐渐消失,但为了构建当今稳健的 Agent 应用,它们仍是值得尝试的有效工具。
-
针对特定模型定制 Harness。 Codex 和 Claude 的提示词指南表明,不同模型需要不同的提示策略。在使用早期版本 Harness 对 Claude Opus 4.6 进行测试时,得分为
59.6%,虽具竞争力但不如 Codex,因为我们未对 Claude 运行相同的改进循环(Improvement Loop)。许多原则具有通用性,如良好的上下文准备和对验证的重视,但针对你的任务进行几轮 Harness 迭代优化,有助于最大化 Agent 在各任务上的性能。
Harness 设计领域仍有大量开放研究空间。有趣的探索方向包括多模型系统(结合 Codex、Gemini 和 Claude)、用于持续学习的记忆原语(使 Agent 能够自主提升任务表现),以及跨模型衡量 Harness 变更的影响。
在改进 Agent 的外层循环中,我们正在探索 RLMs 等方法,以更高效地挖掘执行轨迹(traces)。我们将继续优化 harness,并公开分享我们的研究成果。
我们创建了 一个 Traces 数据集,以供社区共享。
Deep Agents 是开源项目,提供 Python 和 Javascript 版本。
致力于更多的爬山式优化与开放研究。

洞察你的 Agent 究竟在做什么
LangSmith 是我们的 Agent 工程平台,帮助开发者调试每一个 Agent 决策、评估变更,并实现一键部署。