Hugging Face 详解 Wav2Vec2 长音频分块推理策略
Hugging Face 发布技术博客,深入解析如何利用 CTC 架构特性解决 Wav2Vec2 在长音频文件及实时流式推理中的内存与延迟瓶颈。文章对比了简单分块、重叠分块及滑动窗口等策略,提供了实现高质量自动语音识别(ASR)的具体工程方法。
报道正文
本文目录5 个章节
利用 🤗 Transformers 中的 Wav2Vec2 实现大文件自动语音识别
发布于 2022 年 2 月 1 日 在 GitHub 上更新 点赞 16
Tl;dr: 本文解释了如何利用连接时序分类(CTC)架构的特性,即使在处理任意长度的文件或进行实时推理时,也能实现高质量的自动语音识别(ASR)。Wav2Vec2 是一款流行的预训练语音识别模型。该模型由 Meta AI Research 于 2020 年 9 月发布,其新颖的架构极大地推动了语音识别领域自监督预训练的进展,例如 G. Ng et al., 2021、Chen et al, 2021、Hsu et al., 2021 和 Babu et al., 2021。在 Hugging Face Hub 上,Wav2Vec2 最受欢迎的预训练检查点目前每月下载量已超过 250,000 次。
Wav2Vec2 本质上是一个 Transformer 模型,而 Transformer 的一个主要限制是它通常只能处理有限长度的序列。这要么是因为使用了位置编码(此处并非如此),要么仅仅是因为 Transformer 中注意力机制的计算复杂度实际上是关于 sequence_length 的 O(n²),这意味着使用非常大的 sequence_length 会导致复杂度和内存消耗急剧爆炸。因此,你无法在有限的硬件资源上(即使是像 A100 这样的大显存 GPU)直接对长达一小时的音频文件运行 Wav2Vec2。你的程序会崩溃。让我们试试看!
pip install transformersfrom transformers import pipeline
pipe = pipeline(model="facebook/wav2vec2-base-960h")
pipe("very_long_file.mp3")
pipe("very_long_file.mp3", chunk_length_s=10)简单分块
实现超长文件推理最简单的方法,是将初始音频直接切分为较短的片段(例如每段 10 秒),对这些片段分别进行推理,最后再重建完整结果。这种方法在计算上效率很高,但通常会导致效果不佳。原因在于,为了获得高质量的推理结果,模型需要一定的上下文信息,因此在分块边界处的推理质量往往较差。
请看下图:
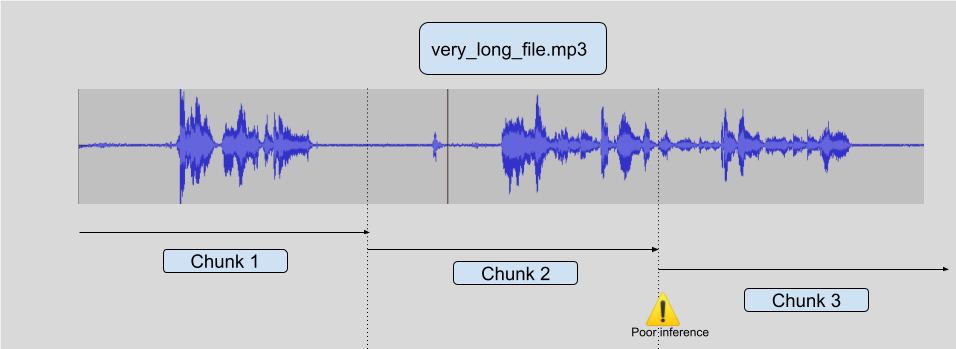
虽然有一些方法试图以通用方式解决这一问题,但它们从来都不是完全稳健的。你可以尝试仅在遇到静音时进行切分,但可能会遇到长时间非静音的音频(如歌曲或嘈杂咖啡馆的背景音)。你也可以尝试仅在无人声时切断,但这需要引入另一个模型,且该问题尚未得到彻底解决。此外,还可能存在人声持续非常久的情况。
事实证明,Wav2Vec2 所使用的 CTC 结构可以被利用,从而即使在处理超长文件时也能实现非常稳健的语音识别,避免上述陷阱。
带步长的分块
Wav2Vec2 使用 CTC 算法,这意味着每一帧音频都被映射到一个单独的字母预测(logit)。
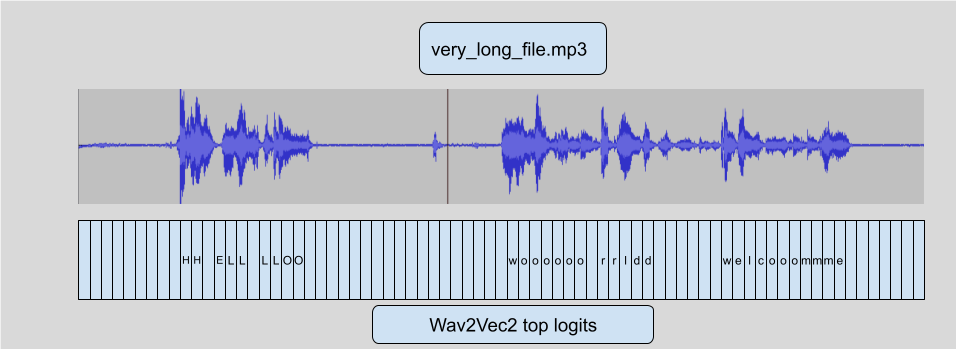
这正是我们将用来添加 stride(步长)的主要特性。这个链接解释了其在图像上下文中的含义,但在音频领域概念相同。基于这一属性,我们可以:
- 对重叠的分块进行推理,以便模型在中心区域拥有适当的上下文。
- 丢弃边缘部分的推理 logits。
- 将保留下来的 logits 串联起来,从而恢复出与模型在全长度音频上预测结果极其接近的输出。
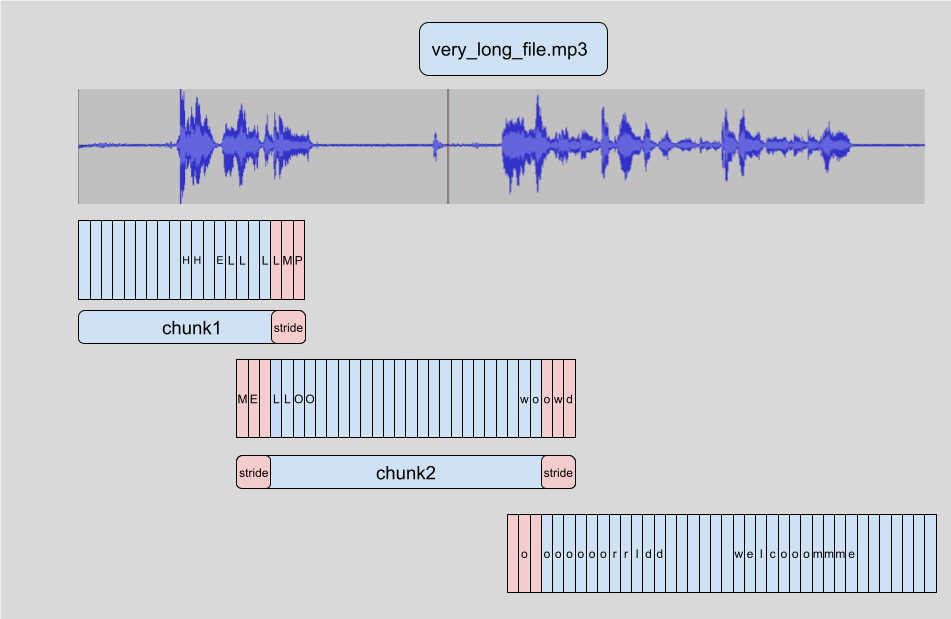
这在技术上并不完全等同于在整个文件上运行模型,因此默认情况下并未启用。但正如你在前面的示例中所见,只需在 pipeline 中添加 chunk_length_s 参数即可使其正常工作。
在实践中,我们观察到大部分不良推理结果都保留在步长(stride)区域内,而这些区域会在推理前被丢弃,从而实现对完整文本的正确推理。
请注意,你可以自由选择该技术的各个参数:
from transformers import pipeline

pipe = pipeline(model="facebook/wav2vec2-base-960h")

output = pipe("very_long_file.mp3", chunk_length_s=10, stride_length_s=(4, 2))
结合语言模型增强模型的带步长分块处理
在 transformers 中,我们还添加了对 Wav2Vec2 集成语言模型(LM)的支持,以便在不进行微调的情况下提升模型的词错误率(WER)性能。请参阅这篇优秀的博客文章以了解其工作原理。
事实证明,语言模型直接作用于 logits 本身,因此我们可以完全沿用之前的相同技术而无需任何修改!这意味着在这些经过 LM 增强的模型上对大文件进行分块处理依然开箱即用。
实时推理
使用像 Wav2vec2 这样的 CTC 模型的一个显著优势在于它是单遍(single pass)模型,因此速度非常快,尤其是在 GPU 上运行时。我们可以利用这一特性来实现实时推理。
其原理与常规的步长处理完全相同,但这次我们可以将数据在传入时就馈送给 pipeline,并简单地使用长度为 10 秒的完整块配合 1 秒的步长来获取适当的上下文。
这比简单的文件分块需要执行更多的推理步骤,但它能显著提升实时体验,因为模型可以在你说话的同时输出内容,而无需等待数秒钟才能看到显示结果。