vLLM 官方博客 · 2026/10/14 08:00:00
vLLM 引入无置信头自适应验证:在线拟合估算器优化投机解码算力效率
vLLM 在 PR #52228 中为缺乏显式置信度头的草稿模型引入了基于 logits 的在线拟合估算器,以支持自适应验证(Adaptive Verification)。该机制通过实时预测目标模型的接受概率来动态修剪低置信度 token,从而在不牺牲无损保证的前提下显著降低大 batch 场景下的计算开销。
报道全文原始报道全文
本文目录15 个章节
基于在线拟合接受度估计器的自适应验证
TL;DR
现在,所有基于草稿模型(draft-model-based)的推测解码器类型均支持置信度评分。在缺少置信度头(confidence head)的情况下,在线拟合估计器会从草稿模型的 logits 中提取特征,以预测目标模型接受该 token 的概率,并将此概率直接用作自适应验证(Adaptive Verification)的置信度分数。该估计器的系数会持续进行拟合,从而适应传入的数据流量。此功能已在 PR #52228 中合并,对于没有置信度头的草稿模型,可通过启用 enable_adaptive_verification 来使用此功能。
背景
vLLM 的 自适应验证 (AV) 允许在推测解码过程中仅对部分草稿 token 进行验证。那些被目标模型接受概率较低的草稿 token 会在运行目标模型的前向传播之前从批次中剔除,从而节省计算资源。这一优化在服务大批量数据时尤为有益,因为在该场景下 GPU 会成为计算瓶颈。更多细节请参阅 这篇 vLLM 博客文章。
AV 需要针对每个 token 的接受概率估计值,这也是为什么它此前仅支持 DSpark 草稿模型的原因。DSpark 模型通常自带一个置信度头:这是一个位于草稿模型隐藏状态之上的小型线性层,针对每个位置训练为一个二分类器,用于判断“目标模型是否会接受这个 token?”
问题
缺乏置信度头的草稿模型,例如 EAGLE、MTP、DFlash 以及部分 DSpark 检查点,完全无法使用 AV。若要使用 AV,这些草稿模型需要提供逐 token 的接受度估计值,而添加置信度头意味着需要重新训练草稿模型,这对于许多用户已经在部署的现有检查点来说是不可行的。
相关工作
利用 drafter 自身的置信度作为接受率的代理指标,这一做法已有充分依据。EAGLE-2 表明,EAGLE 的 draft 概率与接受率高度吻合,并据此动态扩展和重排 draft tree。Draft & Verify 及若干后续工作则在 drafter 的概率低于固定阈值时停止生成 draft。SpecDec++ 转而训练一个专用的接受率预测头,其思路与 DSpark 的置信度头类似。在上述每种方法中,从 draft 置信度到接受率的映射要么直接沿用,要么通过离线学习获得。
AV 需要的不仅仅是一个良好的排序结果。其预算决策需汇总预测的接受概率,并将其与实测成本进行权衡,因此预测值必须针对所服务的具体模型组合和工作负载进行校准——这正是下一节所述在线拟合估计器所提供的功能。
解决方案:在线拟合的接受率估计器
我们添加了一个轻量级的 logistic regression,用于根据从 draft 分布中提取的一个标量特征来估计每个 draft token 的接受概率,该特征为 drafter 最可能 token 的对数几率(log-odds)。该模型在每个 draft 位置上共享一个斜率和一个截距,因此对于 K-token 的 drafter,总共仅需 K + 1 个参数。这些参数通过目标模型在正常验证过程中已产生的接受/拒绝决策在线拟合得到。任何现有的 draft checkpoint 均可免费启用 AV。
本节其余部分涵盖设计的两个核心方面:估计器对哪个量进行评分,以及如何在服务过程中拟合其系数。
分布评分
给定 draft token 的置信度分数通过逐位置的 logistic regression 估计:
其中 ω 是在所有 draft 位置间共享的拟合斜率,βi 是逐位置的拟合截距,q 为 draft 分布。另一种对数几率形式使关系更加清晰:
logit(qmax) 是该估计器的特征,即 draft 中最可能 token 的对数几率。直观而言,它反映了 draft 模型对其预测的信心程度。该值经系数 ω 和 βi 线性变换后,用于预测 draft 被目标模型接受的对数几率。对该结果取 sigmoid 函数即得 p,也就是估计的接受率,用作 AV 的置信度分数。
其他考虑过的特征
在考虑过若干替代特性后,我们因各种原因将其全部否决。在评估某项特性时,我们最关注的四个核心指标如下:
- 无损性(Losslessness) — 该特性是否在推测解码(speculative decoding)过程中使输出分布产生偏差。
- 曲线下面积(AUC) — 随机选取一个被接受的草稿得分高于随机选取的被拒绝草稿的概率。这一指标衡量的是应当被接受与被拒绝的草稿之间的区分能力。数值越高,表明区分能力越强;0.5 代表随机猜测水平。
- 对数损失(Log-loss) — 预测接受概率的平均负对数似然值,该指标会对高置信度的错误预测施加惩罚,并奖励良好的校准效果。数值越低,表明模型预测给定草稿真实接受概率的能力越强。
- 期望校准误差(ECE) — 根据预测的接受概率将草稿分箱,然后计算每个箱内平均预测值与平均观测频率之间的误差,并按箱内样本占比加权。这一指标衡量的是校准程度,数值越低,表明模型为草稿分配的概率越能准确反映具有相似评分草稿的真实接受频率。
无损性是这些特性必须具备的不可妥协属性。否则,我们将破坏推测解码的核心保证——即输出目标模型的精确分布。AUC 和 ECE 对于 AV 的修剪决策都很重要,但作用方式不同。AUC 关乎存活概率的局部排序:
survival = confidence_probs[idx_mapping].cumprod(dim=1)
...
winners = flat.topk(draft_budget).indices
AUC 确保更可能被接受的草稿 token 优先于较不可能被接受的 token 入选。另一方面,ECE 关乎全局预算决策:
num_tokens_to_estimated_accepted_tokens = np.concatenate(
    ([num_sampling_requests], num_sampling_requests + np.cumsum(scores))
)
costs = draft_cost_ms[...] + verify_cost_ms[...]
...
draft_budget = int(np.argmax(num_tokens_to_estimated_accepted_tokens / costs))
此处将概率求和后除以实测成本表。ECE 确保估算的接受 token 数量与实际相符。
下表列出了各种实验特征及其在四个类别中的得分。这些指标是在服务 DeepSeek-V4-Flash + DSpark 过程中收集的约 450 万条标注草稿上测得的(参数设置:temp=1, top-p=0.95, conc=64,未启用 AV),涵盖五个数据集:SPEED-Bench 2k 低/高熵子集、GSM8K、HumanEval 和 MT-Bench。最后两行并非拟合特征,而是作为参考基准:分别是直接将起草器(drafter)的 qmax 用作接受概率(无拟合),以及训练得到的置信度头(confidence head)的得分。
| feature | lossless | AUC | log-loss | ECE |
|---|---|---|---|---|
| log(qmax) | yes | 0.8069 | 0.4813 | 0.0592 |
| log(qmax) − log(q2nd) (top-2 margin) | yes | 0.8156 | 0.4437 | 0.0105 |
| H(q) (entropy) | yes | 0.8321 | 0.4577 | 0.0638 |
| −log(−log(qmax)) | yes | 0.8336 | 0.4289 | 0.0103 |
| logit(qmax) (shipped) | yes | 0.8336 | 0.4284 | 0.0100 |
| logit(qsampled) | no | 0.8553 | 0.4040 | 0.0152 |
| −log(−log(qsampled)) | no | 0.8554 | 0.4075 | 0.0193 |
| qmax (no fit, used directly as the probability) | yes | 0.8259 | 0.4880 | 0.0736 |
| trained confidence head | yes | 0.8191 | 0.4449 | 0.0052 |
虽然 logit(*q*sampled) 和 −log(−log(*q*sampled)) 在 AUC 指标上明显优于表中选定的特征,但并未被采用,因为基于它们进行裁剪会导致输出分布产生偏差。这两个特征都读取了 qsampled,即起草器实际采样出的 token 的概率。基于该值的函数对草稿进行裁剪,会使在第 i 个位置是否进行验证的决策依赖于 xi 本身,导致经过裁剪后幸存的草稿不再符合分布 q。标准的拒绝采样以 min(1, p/q) 的概率接受一个 token,并预期 q 是草稿 token 的采样分布。然而,基于 qsampled 的裁剪会使生成的分布偏向于起草器置信度较高的 token。1
qmax 的“无拟合”行揭示了为何我们需要进行拟合,而不是像 EAGLE-2 在构建草稿树时那样直接使用草稿模型自身的概率。如果直接使用,草稿模型的 top-token 概率实际上比训练好的置信度头能更好地对草稿进行排序(AUC 为 0.8259 vs 0.8191)。然而,它的校准效果并不好。其在标注草稿上的平均预测值为 0.784,而实际观测到的接受率为 0.723,其 ECE(期望校准误差)比已部署的 logit(qmax) 特征差 7 倍(0.0736 vs 0.0100)。草稿模型的 top-token 概率仅反映了草稿模型对其自身预测的信心程度,而非目标模型是否会同意该预测。这种一致性还进一步受到采样设置和工作负载的影响。在线拟合直接从目标模型的接受/拒绝决策中学习这一映射关系,从而获得更好的校准效果,而这正是预算决策所依赖的关键因素。
我们最终选择了 logit(qmax) 特征,因为它在 AUC 和 ECE 之间取得了良好的平衡,且成本合理。这也是一个自然的选择,因为它与我们试图估计的量共享相同的对数几率尺度(log-odds scale)和分辨率。
与训练好的置信度头对比
如上表所示,对于 DeepSeek-V4-Flash + DSpark,估计器在 AUC 和对数似然损失(log-likelihood loss)方面均优于置信度头,但在 ECE 方面表现稍逊。下表总结了具体差异:
然而,一旦我们在计算平均值时排除第一个草稿,情况发生了显著变化:
此时,置信度头和估计器在校准性能上几乎持平。按位置划分的 AUC 细分有助于解释这一现象:
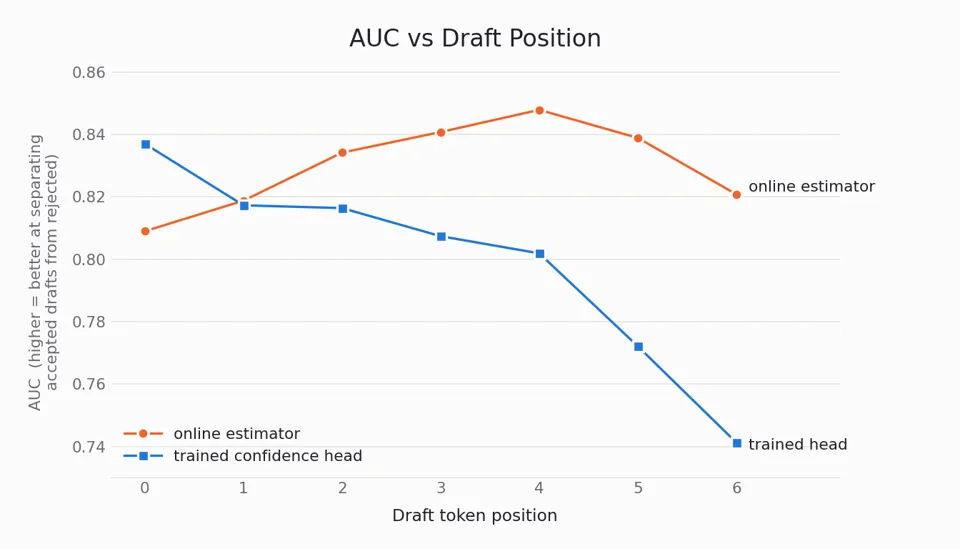
在线估计器与训练好的置信度头在 DeepSeek-V4-Flash + DSpark 上针对 7 个推测性 token、基于 447 万个标注草稿的逐位置 AUC。置信度头在第一个位置领先;从第二个位置开始,估计器领先;两者在第五个位置之后均出现性能下降。
置信度头在第一个草稿位置上具有更好的预测能力,但从第二个位置开始,估计器占据优势。随着深度增加,差距不断扩大,到最后一个位置时,估计器的 AUC 领先 0.08。两个预测器在第五个位置之后也均出现性能下降。这可能是因为 DSV4-Flash 的 DSpark 声明的块大小为 5,且草稿生成器从未在此范围之外进行训练,导致这些位置的草稿质量本身较差。
由于存活率是一个累积乘积,且第一个草稿位置始终承载请求的最高得分,因此它较少成为被预算裁剪掉的 token。估计器的优势恰好体现在发生裁剪的位置,这也解释了为什么估计器能够在端到端性能上与置信度头相媲美。
拟合系数
系数 ω 和 βi 在请求的实时服务过程中持续重新拟合。在上一个解码步骤中提出的草稿 token 会在下一个解码步骤中由目标模型进行验证。只有直到第一次拒绝(如果有的话)之前的草稿 token 才符合训练条件,因为目标模型已明确对其进行了标注(接受或拒绝)。
我们使用迭代加权最小二乘法(IRLS)来最小化预测值与标签之间的对数似然损失。该最小化过程是在对数似然损失的二阶泰勒近似上进行的。ω 和 βi 的优化步骤通过求解以下方程组获得:
其中 Δθ 是共享斜率 ω 和逐位置截距 βi 的增量,H 是形状为 (K + 1) × (K + 1) 的损失函数 Hessian 矩阵,g 是大小为 K + 1 的损失函数梯度。
每经过固定轮数的 N 个解码步骤后进行一次重新拟合。在该区间内的每个解码步骤中,我们累积根据本轮收集的系数、特征和标签推导出的 Hessian 矩阵和梯度值。这样做将一轮内的内存占用上限控制在 O(K²),而如果改为收集原始标签,则内存占用将为 O(N × B × K)。在本轮的最后一个步骤,系统被求解,并更新系数。
不出所料,较深的草稿位置被接受的频率低于较浅的位置。因此,在一轮迭代中,较深的草稿位置可能因标签稀疏而缺乏足够的训练数据。为了减轻这一现象对重新拟合过程的影响,我们做出了两项设计决策:
- 共享斜率(Shared Slope):所有草稿位置共享同一个斜率,以防止因深层数据稀疏导致的噪声更新。预测结果对斜率误差远比截距误差敏感,因此共享斜率能使牛顿步长(Newton step)的求解更加稳定。此外,实证测量表明,共享斜率几乎不会造成精度损失(仅导致 AUC 下降 0.0002,log-loss 增加 0.0003)。
- 步长阻尼(Step Damping):每个系数的更新量会根据支持证据的数量进行缩放,公式为 n / (n + constant),其中 n 是已评分草稿的数量。这确保了标签较少的深层位置以更保守的方式移动,从而防止基于噪声的更新。
斜率与截距的作用
我们在多个模型/数据集组合上追踪了拟合系数,发现这两类参数的行为截然不同。
固定模型对,改变工作负载:在五个不同的工作负载上独立拟合 DSV4-Flash + DSpark 时,斜率变化极小(介于 0.51 到 0.55 之间),且与工作负载的难度无关(与平均草稿熵的相关系数 r = −0.08)。截距则表现出相反的趋势:第一个草稿位置的截距与草稿熵高度相关(r = −0.89),其数值从可预测性较高的工作负载上的约 0.5–0.6,降至最难预测工作负载上的负值。
| 数据集 | 接受率 | 平均草稿熵 | 斜率 ω | 截距 β0 |
|---|---|---|---|---|
| gsm8k | 0.781 | 0.562 | 0.5365 | +0.478 |
| humaneval | 0.751 | 0.669 | 0.5135 | +0.486 |
| speed-bench 2k low-entropy | 0.755 | 0.703 | 0.5087 | +0.610 |
| mt-bench | 0.714 | 0.800 | 0.5495 | +0.181 |
| speed-bench 2k high-entropy | 0.642 | 1.077 | 0.5197 | −0.089 |
现在改变模型对:不同模型对之间的斜率范围在 0.45 到 0.59 之间,但在同一模型对内保持紧凑。截距在不同模型对之间也存在差异,因此与斜率不同,它并非仅由单一维度决定。
| 模型 | nspec | 斜率 ω | ω 标准差 | 截距 β0 |
|---|---|---|---|---|
| DeepSeek-V4-Flash + DSpark | 5 | 0.5013 | 0.0250 | +0.279 |
| MiMo-V2.5-Pro-FP4 + DFlash | 8 | 0.5197 | 0.0415 | −1.000 |
| Inkling-NVFP4 + MTP | 8 | 0.5859 | 0.0349 | −0.572 |
| Muse-Glimmer-30B + DFlash2 | 7 | 0.4450 | 0.0323 | +0.167 |
将两张表结合起来看,可以揭示出一种分工机制。斜率衡量的是草稿模型对自身正确性的判断能力。这是目标/草稿模型对以及草稿采样方法的固有属性,因此当仅改变工作负载时,该值几乎保持不变。截距则吸收了其余因素:即每个草稿位置的基础接受率,该比率随深度增加而下降,并且在可预测性较低的内容上下降幅度更大。基础接受率既取决于模型组合,也取决于工作负载,这解释了为何截距在两个轴向上都会变化,而斜率仅在一个方向上变化。
基准测试
我们对三个此前完全无法使用自适应验证(AV)的检查点进行了基准测试(MiMo-V2.5-Pro-FP4 + DFlash、Inkling-NVFP4 + MTP 和 Muse-Glimmer-30B + DFlash2),并以 DSV4-Flash + DSpark + 估计器以及 DSV4-Flash + DSpark + 置信度头作为参考。以下收益数据是在四个数据集上,通过对比 AV 关闭与开启的状态获得的,设置参数为温度 1.0、top-p 0.95 以及并发数 64。
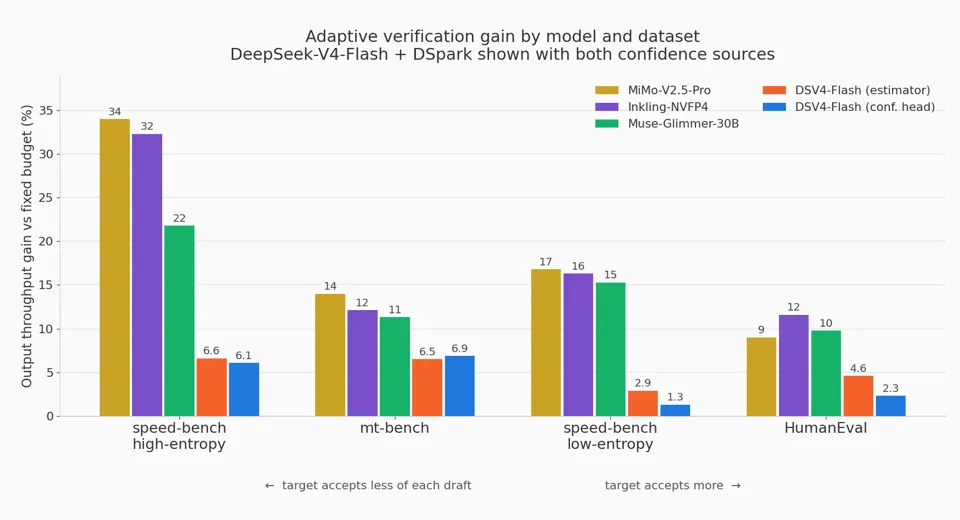
自适应验证带来的输出吞吐量提升:对比 AV 关闭与开启状态,涵盖 MiMo-V2.5-Pro、Inkling-NVFP4、Muse-Glimmer-30B 以及 DeepSeek-V4-Flash + DSpark(分别结合在线估计器和置信度头),基于四个数据集,并发数为 64。
与固定长度验证相比,在相同的推测长度下,在线估计器在所有基准测试数据集中均表现出优势。然而,仅凭这一增益并不能说明全貌。在许多情况下,在特定的并发水平下,可以找到更小的固定长度,其性能优于在最大推测长度下的自适应验证(AV)。下方的帕累托曲线展示了 DSV4 + DSpark 在不同固定推测长度扫描范围以及与最大推测长度下的 AV 之间的表现:
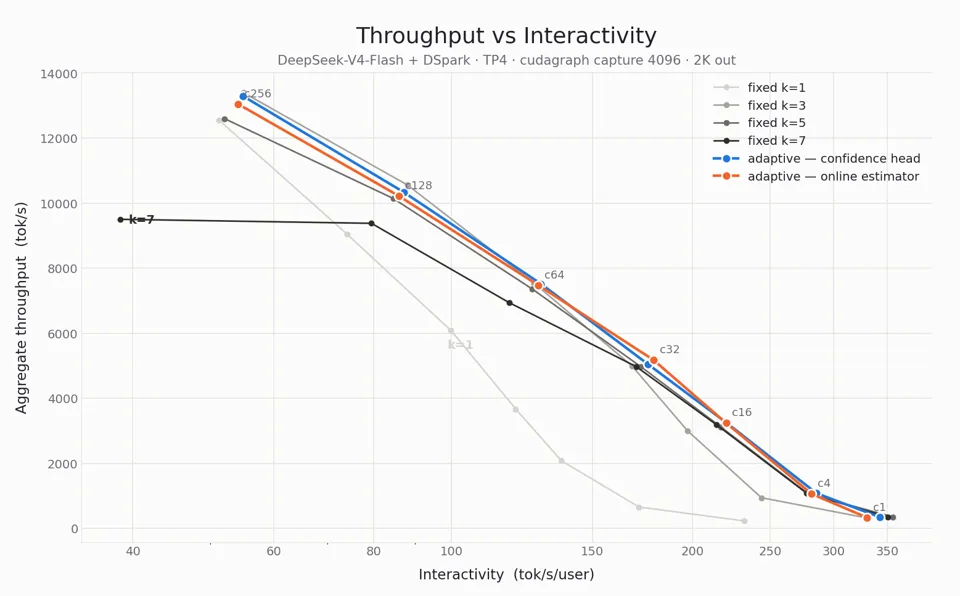
DeepSeek-V4-Flash + DSpark 的吞吐量与交互性对比:涵盖不同固定推测长度以及结合在线估计器和置信度头的自适应验证
在线估计器与置信度头在所有测试的并发级别下,性能大致相当。然而,在线估计器并非旨在取代置信度头,而是在缺乏置信度头时的即插即用替代方案。让我们看看它在一个目前缺少置信度头的模型组合上的表现。以下是 MiMo-V2.5-Pro-FP4 + DFlash 在不同固定推测长度和自适应验证(AV)参数扫描下的帕累托曲线:
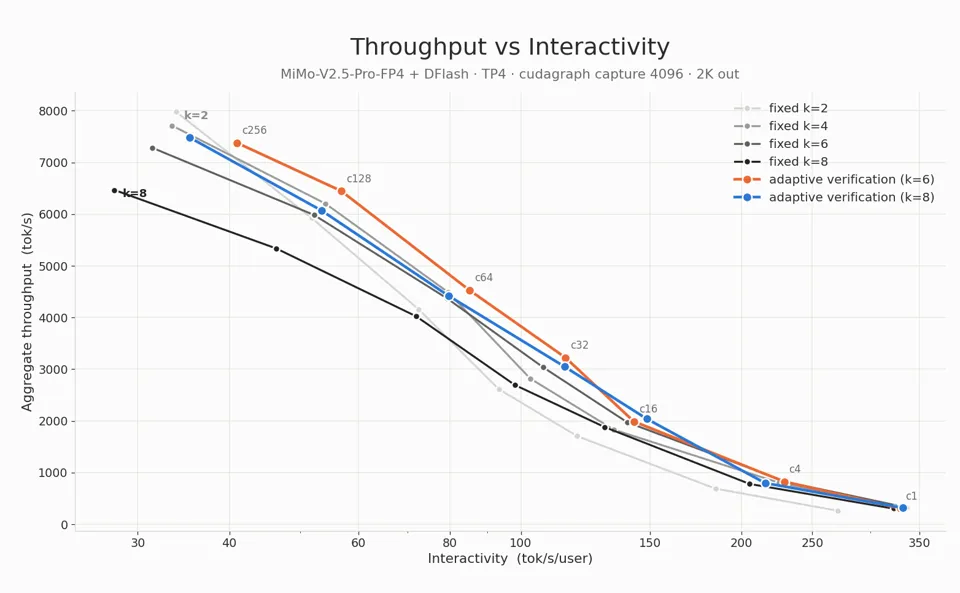
MiMo-V2.5-Pro-FP4 + DFlash 在不同固定推测长度和带在线估计器的自适应验证下的吞吐量与交互性对比
在 7 个并发级别中的 5 个上,自适应验证(AV)位于吞吐量-交互性前沿。
局限性
- 目标模型的注意力后端必须支持变长验证。这与 DSpark AV 已有的前提条件相同。
- MTP 和 EAGLE 从 AV 中获得的收益不如 DFlash 和 DSpark。这是因为这些自回归推测器在起草可能被修剪的 token 时,需承担比例更高的成本。
vLLM 用法
通过推测配置启用 AV。对于满足以下条件的草稿模型:(1) 没有置信度头,且 (2) 其所有后端均支持变长注意力,系统将自动选择在线估计器:
vllm serve <target_model> \
  ...
  --speculative-config '{
    "model": "<draft_model>",
    "method": "<method>",
    "num_speculative_tokens": <num_speculative_tokens>,
    "draft_sample_method": "probabilistic",
    "enable_adaptive_verification": true
  }'
致谢
这项工作由 Giancarlo Delfin(Inferact)完成,并直接建立在 Lucas Wilkinson(Red Hat)和 Benjamin Chislett(NVIDIA)提出的自适应验证工作之上。
脚注
- 可以使用一个简单的双词表示例 [a, b] 来说明这种偏差。假设 p = [0.5, 0.5],q = [0.2, 0.8],并且当 q(x) < 0.5 时,草稿 token 会在验证阶段被裁剪(trimmed)。如果采样得到 a,则会被裁剪,目标模型从其自身分布 p(x) 中重新采样一个 token。然而,如果采样得到 b,则进入验证流程:该 token 以概率 min(1, p(b)/q(b)) = 0.625 被接受;否则被拒绝,并从残差分布 norm(max(0, p − q)) = [1, 0] 中重新采样,从而得到 a。在拒绝采样过程中,我们得到 pout(a) = q(a)·p(a) + q(b)·(1 − 0.625) = 0.4,以及 pout(b) = q(a)·p(b) + q(b)·0.625 = 0.6。这与目标模型的分布 [0.5, 0.5] 不同,违反了推测解码(speculative decoding)的无损保证。↩