腾讯发布 TGR 生成式推荐技术栈,重塑工业级推荐系统架构
腾讯推出 TGR(Tencent Generative Recommendation)技术栈,旨在解决传统级联推荐系统的规模效应缺失、列表质量刻画不足及冷启动瓶颈。该方案通过 GenRank、GenRec 和 Reason 三大方向,引入 CCFormer 排序模型、端到端列表生成及大模型推理增强,已在新闻、视频等 10+ 场景落地并显著提升核心指标。相关成果发表于 AAAI、ACL 等顶会,标志着推荐系统从判别式向生成式范式的重大演进。
报道正文
本文目录63 个章节
从生成式排序、端到端生成到大模型推理增强,迈向Agentic自进化
工业级推荐系统长期依赖"召回–粗排–精排–重排"级联架构,却面临三大结构性瓶颈:模型缺乏规模效应,算力与参数增加后效果饱和;逐条打分、逐级截断,难以刻画整屏列表质量;冷启动、长尾和意图模糊场景表现欠佳。为此,我们提出生成式推荐技术栈 TGR,沿生成式排序(GenRank)、端到端生成(GenRec)、推理增强(Reason)三个方向推动级联架构演进:CCFormer 替代传统排序模型,BARGE、HiGR 端到端生成物品与整屏列表,大模型隐式推理注入在线生成模型。TGR 已在新闻、视频、小说等 10 多个场景落地,核心指标显著提升,多篇论文发表于 AAAI、ACL、CIKM 等顶会。
引言
传统推荐系统长期沿用一套级联架构——召回、粗排、精排、重排——每一级由独立优化的深度学习推荐模型(DLRM)驱动。这套架构正同时面临三个结构性挑战。第一,碎片化的 DLRM 架构用分别设计的模块处理高基数、异构的特征,不具备 LLM 式的 scaling law:模型容量与算力增长之后,效果趋于饱和。第二,分阶段优化与逐级候选截断把决策过程切碎,逐 item 的 pointwise 打分忽略了决定整屏列表质量的 item 间依赖与位置效应。第三,协同信号驱动的模型在多模态语义理解、世界知识与推理能力方面能力不足,而这些能力恰是应对冷启动、长尾及用户意图模糊等场景的关键。这三大挑战正在推动整个行业从级联范式转向生成式范式:统一、可扩展的序列建模带来排序模型可预测的 scaling,端到端生成把整屏列表作为一个整体来决策,用大模型先验引入世界知识与推理能力。
面向 PCG 业务中内容模态、用户群体、候选规模与延迟要求各不相同的异构业务场景,我们构建了 TGR(Tencent Generative Recommendation),主要沿三大方向(GenRank / GenRec / Reason)把推荐系统从传统级联推进到生成式范式。第一,TGR-GenRank 方向把排序阶段升级为生成式范式的排序:CCFormer 模型以统一特征 token 化与可扩展的 Transformer 骨干为基础,引入特征域分离的 cross attention、长序列子空间 token mixing 与层级序列压缩,以约为 HSTU 一半的算力取得更优的排序效果,并沿模型参数量与序列长度持续 scaling。第二,TGR-GenRec 方向以两种互补的生成范式探索对级联决策阶段的端到端替换:在 next-token prediction(NTP)范式下,BARGE 通过引入上下文感知注意力、层级路径重排与正交双路解码,弥合了层级语义 ID 生成中的两个结构性缺口——多 token 物品展平后 item 边界丢失、早期前缀出错引发的语义漂移;在 next-slate prediction(NSP)范式下,HiGR 把推荐从逐 item 解码重构为整屏 slate 生成,协同设计了可控规划所需的前缀结构化语义 ID、把全局 slate 规划与局部 item 生成分离的粗到细解码器,以及兼顾列表顺序、真实兴趣与多样性的 ORPO 列表级偏好对齐。第三,TGR-Reason 方向以“隐式推理、在线注入”增强端到端生成:推理成本经隐空间多步监督在训练期摊销,Think 模型的推理结果离线物化为 reason tokens,再由 Direct Reasoning Injection 作为层级对齐的 prompt 条件化在线解码。
腾讯 TGR 已在真实业务流量上规模化部署,覆盖新闻、视频、网络小说等业务的10多个场景,助力相关业务在观看时长、广告收入与新用户转化等核心指标取得显著提升,TGR 相关创新成果已在AAAI、ACL、CIKM等国际顶级会议发表多篇论文。
一、传统推荐系统的结构性瓶颈
如上图所示,业界大多数推荐系统采用多阶段级联架构,而且每一层的模型基本都是典型 DLRM 范式:底层针对sparse、dense和多域异构行为序列单独做特征抽取,中间层做特征交互网络(DeepFM、DCN、DIEN等),最后多任务输出层网络(MMoE、PLE等)。这套架构至今仍是业界主流范式,但有三个结构性瓶颈已经显现,限制了系统进一步提升的空间:1)DLRM 范式不具备 LLM 式的 scaling law——模型容量与算力增长之后,效果趋于饱和;2)级联架构的分阶段决策带来结构性错位;3)协同信号驱动的模型缺乏多模态语义理解、世界知识与推理能力,在冷启动、长尾与意图模糊场景上效果欠佳。
如上图所示,基于 Transformer 的大语言模型在NLP、CV等领域取得了很大的成功:效果随算力、数据、参数量可预测地持续提升,并具备多模态理解与复杂推理能力。因此业界正积极探索"生成式范式":把推荐建模为序列生成,让召回、排序、重排都能享受 LLM 式的 scaling 与推理。但直接把 LLM 的建模方式照搬并不可行,主要面临如下三个结构性问题的挑战。
1.1 排序模型的算力效率瓶颈:特征交叉与长序列建模
如上图所示,生产环境中的排序模型面对的是异构、高基数、分布实时变化的特征空间:sparse 特征的基数可达百亿规模,dense 特征依赖人工设计的数值统计,用户行为序列来自多个业务域和场景,序列可达万级。这套架构的天花板在于它不具备 LLM 式的 scaling law:embedding 查表加人工设计的交叉结构受内存带宽限制,模型算力利用率低,增加参数和算力之后效果不再持续提升。Meta提出的 HSTU 是生成式范式的第一次可信突破——把特征与行为序列统一 token 化,由单个 Transformer 完成交叉,排序模型首次呈现出随参数量与序列长度可预测提升的 scaling 特性:HSTU 把序列转导模型扩展到万亿参数量级,线上 A/B 取得 +12.4%。
但新的瓶颈随之出现:self-attention 的计算开销随序列长度平方增长,在数十到百毫秒的延迟预算下,长序列只能截断或预压缩,细粒度的跨域交互被牺牲掉,而这是 TGR-GenRank 方向要解决的问题出发点。
1.2 级联架构的目标割裂:阶段代理目标与列表级目标的不一致
如上图所示,级联架构下系统是逐 item 做决策的:召回、粗排、精排、重排每一级都用判别式打分和截断阈值做局部决策,候选从海量逐级截到千级、百级,最后拼成一屏。级联架构主要存在以下瓶颈:
1)各级独立优化、独立截断,上游截掉的 item 下游看不到,信息逐级损失、样本偏差累积,算力也被切成碎片;
2)各阶段目标彼此不一致,跨阶段的联合优化在级联结构下难以协同,各阶段效果提升的边际收益递减;
3)用户体验到的是一屏有序的列表:列表质量取决于 item 之间的兼容性、多样性与位置效应,而各阶段判别式打分刻画不了这些关系,局部最优的拼接不等于全局最优。
快手提出的 OneRec 是端到端生成范式的第一次工业化落地——把 item 编码为层级语义 ID,用单个 encoder-decoder 模型以 session 为单位直接生成推荐列表,并用基于奖励模型的迭代偏好对齐取代多阶段打分,在工业场景验证了用一个生成模型替换级联判别式阶段的可行性。
但新的瓶颈随之出现:自回归解码整屏意味着 M 个 item × D 层 SID 共 M×D 个 token 的逐 token beam search,在实时约束下太慢;多 token 的 item 展平后 item 边界丢失,前缀一旦出错便引发语义漂移;逐 token 的生成目标也刻画不了列表层面的顺序与多样性,而这些正是 TGR-GenRec 方向要解决的问题出发点。
1.3 协同信号的覆盖边界:冷启动、长尾与意图模糊
如上图所示,协同信号驱动的推荐模型学到的是行为共现模式:看过 A 的人接着看了 B。这套机制在绝大多数请求上有效,却恰好在最需要推理的三类请求上失效:
1)新用户,历史序列为空或极短,没有共现证据可供匹配;
2)长尾 item,协同信号稀疏,交互集中在热门 item 上,长尾几乎没有交互边可学;
3)意图模糊的请求,历史同时指向多个方向,用户下一步想做什么需要推断而不是匹配。
这三类请求需要的是多模态语义理解、世界知识与意图推断,而基于协同信号的模型却缺乏这方面的能力——模式匹配不等于推理,这就是协同信号的覆盖边界。引入大模型先验是自然的解法,业界已有两条路径:显式推理(OneRec-Think/OneReason)让模型在生成推荐前先显式输出思维链,隐式推理(ReaRec / STREAM-Rec)在隐空间多走几步 rollout 再生成。
但两者都把推理放在了请求路径上:显式推理每个请求多出数百个 CoT token,隐式推理每个请求多出 K 步前向,在数十~百毫秒的延迟预算下放不进去;推理容量与每请求计算绑定,想多推理一步就要为每个请求多付一步延迟,把推理搬到离线也只是转移成本——推理结果随请求产出,每次曝光仍要算一次,而这些正是 TGR-Reason 方向要解决的问题出发点。
1.4 TGR 演进路线与技术栈全景
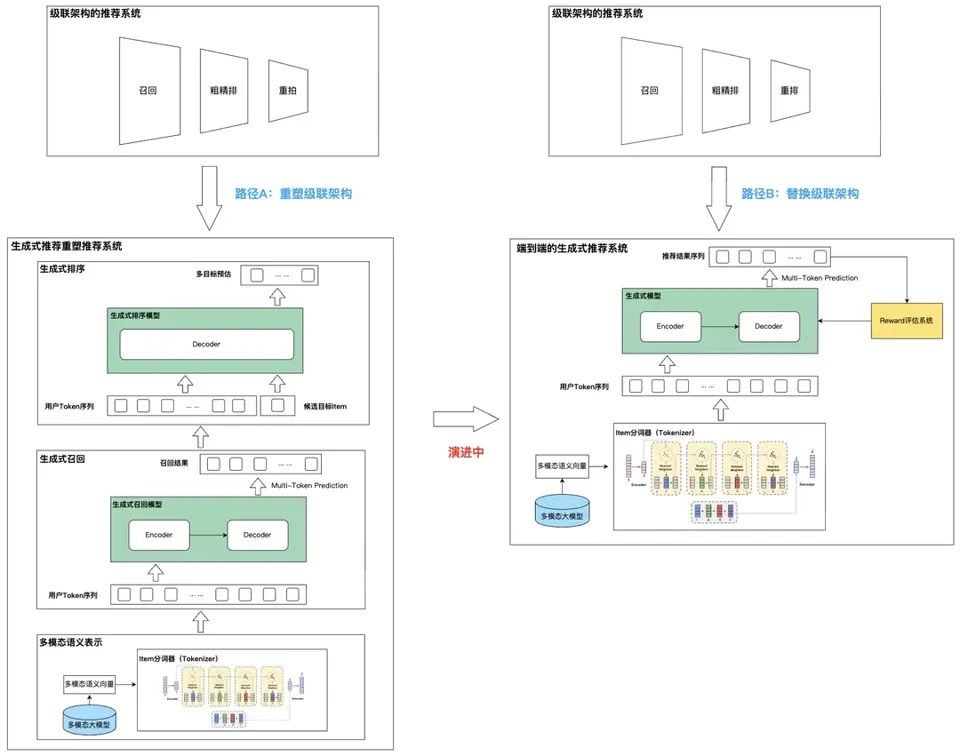
如上图所示,生成式范式改造推荐系统主要有两条路径。一条是重塑级联架构:基本还保留级联架构,借鉴生成式范式的建模技术来重塑各层的模型,包括生成式范式下的重排、精排、召回模型等。另一条是替换级联架构:探索用单一生成模型替换召回、排序、重排等学习型决策阶段,直接输出 item 或整屏 slate。
我们认为这两条路径并不互斥,短期内两者都会同时存在并继续演进,根据实际场景的数据规模、成本等因素来做路线选择,所以TGR-GenRank 走重塑路线,TGR-GenRec 与 TGR-Reason 探索替换路线。因此,TGR 技术栈由排序层(TGR-GenRank)、生成与推理层(TGR-GenRec、TGR-Reason、TGR-Memory)和基础层(Numerous-Torch、用户建模、多模态理解、SID 模型)组成,如下图所示。
如下图所示,TGR 沿"统一语义表示的基础设施 → 重塑 / 替换级联的生产模型 → 推理增强与 Agentic 自进化的前瞻探索"三个层次,把推荐系统逐环节升级或替换,形成五个方向:
1)TGR-SID:全场景统一的语义 SID,既是推荐内容理解与统一语义表示的基础设施,也是各方向共享的解码空间,目前已接入多个业务。
2)TGR-GenRank 以生成式范式"重塑"排序,我们提出 CCFormer 作为排序模型 backbone,用特征域分离交叉注意力、子空间相对时空编码与层级序列压缩降低序列建模复杂度,已在多个业务场景全量上线;
3)TGR-GenRec 以端到端生成"替换"级联中的判别式决策阶段,NTP 路线的 BARGE 修复层级语义 ID 生成的结构性缺口,NSP 路线的 HiGR 把“编码 → 规划 → 生成 → 对齐”做成一体化的列表级生成框架,同样已在多个业务场景全量上线。
4)TGR-Reason 以大模型推理“增强”端到端生成:我们提出 LatentRec,用连续隐向量替代文本 CoT,在隐空间把“思考”与“生成”合为一体,推理成本在训练期摊销;推理结果通过离线 / 近线机制物化为 reason tokens,经 DRI 注入在线生成器,实现服务时零推理 rollout,线上 A/B 在新用户指标上显著提升;
5)TGR-Loop 把演进本身交给多智能体,让 LLM 智能体自主提出、验证并迭代推荐模型,目前处于研究探索阶段。
接下来,我们分别重点介绍 TGR-GenRank、TGR-GenRec 与 TGR-Reason三个方向,TGR-Loop 在最后的展望中介绍。
二、TGR-GenRank:排序模型的范式迁移
TGR-GenRank 方向的目标是在级联结构下替换排序 backbone——用生成式范式"重塑"排序,让排序模型既能随参数量与序列长度可预测地提升效果,又能把算力开销控制在预期范围内。
2.1 传统排序模型的局限性与排序范式的业界演进
如上图所示,推荐排序模型面对的输入是异构、高基数、分布实时变化的特征空间——sparse 特征基数接近百亿,多域行为序列的类型、时间尺度与长度差异很大、可达万级——训练上还要求在超大规模数据上实时更新。
DLRM范式的排序模型是典型的三层架构:
1)底层是特征抽取层:用户行为序列与候选 item 经 target-aware 的 pairwise attention 得到序列表示,ID 类 sparse 特征经 embedding 查表与池化得到 pooled embeddings,外部 embedding 特征与人工设计的 float 统计特征各走一条支路;
2)中间是特征交互层,由 DCN 一类的显式交叉结构把各支路表示组合起来;
3)顶层是任务转换层,以 MoE 形式输出多个任务的预估分数。
DLRM范式的根本局限在于扩展性:随着训练数据量、模型规模或计算量的提升,效果未能持续提升,排序模型缺少可预测的 scaling 路径。
如上图所示,业界近两年的排序模型演进可归为两条路线(范式 A 与范式 B):
1)特征交互型模型(Wukong、RankMixer 等)延续 DLRM 的分层思路:序列先由前置模块压缩成少量表示,再与非序列特征一起送入可堆叠、可 scaling 的交互骨干。Wukong 用堆叠的 FM block 做高阶点积交互并配合线性压缩,在排序模型上报告了跨两个数量级算力的 scaling law;RankMixer 用无参数化的 token mixing 替代 self-attention,主要计算落在 per-token FFN 上,算力利用率高。这条路线的共同短板是序列信息在压缩时有损,跨域交叉发生在压缩之后、位置滞后;
2)统一 token 化 + 注意力交互的模型(HSTU、ULTRA-HSTU、OneTrans 等)把用户画像、行为序列与候选物品统一编码成一条 token 序列,用 attention 一次完成序列内与跨域交叉,效果随参数量与序列长度可预测提升。代价是原生 self-attention 对序列长度是 O(L²),万级长序列在工业延迟预算下计算量与显存开销巨大,后续工作都在注意力本身上做减法:ULTRA-HSTU 引入半局部稀疏注意力与注意力截断,OneTrans 用金字塔式缩减 query 数并跨请求缓存 KV——它们以限制注意力范围或减少参与交互的 token 数为代价换取次二次开销。
总结一下,范式 A 的优势是算力利用率高——交互骨干只处理少量压缩后的表示;但不足是序列先压缩、后交叉,细粒度的序列信息和候选与历史行为之间的精细匹配在进入骨干之前就已丢失。范式 B 的优势是交互充分——用户画像、行为序列与候选统一在一条 token 序列里,self-attention 一次完成序列内与跨域的全部交互,效果随参数量与序列长度可预测提升;但不足是 self-attention 对万级长序列在工业延迟预算下计算量与显存开销巨大,后续的稀疏化、截断、金字塔堆叠都是在为这一个算子减负。
如何既保留范式 B 在完整序列上做充分交互的效果,又获得范式 A 的算力效率,这正是 CCFormer 的设计出发点:把跨域交叉与序列内交互解耦,各用最合适的算子(如上图中的范式 C)——跨域交叉用特征域分离的 cross attention,让非序列特征直接查询完整序列,复杂度随序列长度线性;序列内交互在子空间内用 token mixing 与 per-token FFN 完成,避开二次开销;序列压缩不再前置于交互,而是在骨干内部逐层、层级化地进行,让细粒度信息先参与交叉再被压缩。
2.2 CCFormer:跨域交叉注意力、子空间序列交互与层级序列压缩
如上图所示,CCFormer 把输入特征划分为用户侧(user tokens)、用户历史行为序列(sequence tokens)、候选目标物品(target item tokens)三个异构特征域,并把排序模型的特征提取环节解耦为四个模块:
1)特征域分离的 Cross Attention。如下图所示,特征域分离的 Cross Attention 把排序任务拆成三个域之间的关系——用户与历史序列之间的偏好性检索、目标物品与历史序列之间的相关性匹配、目标物品与用户之间的兼容性建模——Cross Attention 适合做异构域之间的相关性建模,且复杂度为 O(L)。
2)子空间相对时空位置编码(Subspace Relative Time and Position Encoding)。如下图所示,长序列子序列的相对时空位置编码把长序列划分成多个相邻 m 个 token 的子序列,在子序列上分别计算相对时间与相对位置的参数矩阵并注入序列 token,复杂度从全局的 O(L²) 降为 O(Lm)。
3)子空间 Token Mixing(Subspace Interaction)。如下图所示,长序列子空间 Token Mixing 把序列 token 划分成 m×n 维度的子空间,每个子空间的 embedding 展开后经过参数独立的 PFFN 再做维度 revert,完成子空间内的特征交叉。
4)层级卷积压缩(Convolutional Compression)。如下图所示,分层长序列 Token 卷积压缩用逐层有重叠的一维卷积聚合相邻行为 token,卷积核自适应地学到聚合模式,逐层压缩使每一层序列 token 的感受野逐层变大,模型获得多序列尺度的特征建模能力,层级堆叠下的计算量大幅降低。
2.3 实验效果
2.3.1 对比实验分析
公开数据集上,CCFormer 在 Taobao 与 KuaiRec 上均优于 DIN、DeepFM、SASRec、MIMN、HSTU、OneTrans、STCA;
在 40 亿样本的真实业务数据集上,AUC 77.94%、GAUC 71.36%,相对 HSTU(77.66% / 70.86%)分别提升 0.28 和 0.50 个百分点,相对提升 1.01% 与 2.40%(表 1)。Scaling 实验表明 CCFormer 沿特征维度(128 → 512)和序列长度(0.5K → 2K)都持续提升且始终优于 HSTU;CCFormer 仅用 0.5K 序列就达到了 HSTU 用 2K 序列的 AUC,并超过其 GAUC(见 2.3.3)。
表 1 | CCFormer 在两个公开数据集与真实业务数据集上的效果对比
2.3.2 消融实验分析
消融实验给出了各模块的贡献(表 2):完整 CCFormer 在真实业务数据集上 AUC / GAUC 为 77.94 / 71.36,训练加速 2.21×;移除相对时空位置编码后 GAUC 降至 71.13;长序列 token mixing 换成 self-attention 后 GAUC 降至 71.21,训练加速降为 1.41×;移除 token mixing 降至 71.02;移除序列压缩后训练加速降为 1.29×。
表 2 | CCFormer 消融实验:各模块对 AUC / GAUC 与训练加速比的贡献(对比 HSTU)
2.3.3 模型scaling效果分析
如上图所示,CCFormer 在模型规模和序列长度两个维度上都表现出可预测的 scaling 特性,并且在每个规模点上都以更低的算力取得更好的效果。
先看模型规模:特征维度从 128 增加到 256、512,HSTU 与 CCFormer 的 AUC、GAUC 都单调上升,但 CCFormer 的领先幅度随规模扩大而拉大(ΔAUC 从 0.84% 升到 1.22%,ΔGAUC 从 1.02% 扩大到 2.4% 左右),同时每个维度下的 GFLOPs 仅为 HSTU 的三至六成——256 维的 CCFormer(18.28 GFLOPs,AUC 77.94%)已经超过 512 维的 HSTU(63.47 GFLOPs,AUC 77.79%),算力不到后者的三分之一。
再看序列长度:在真实业务数据集上把用户序列从 0.5k 拉长到 2k,两者的 AUC、GAUC 都随长度近似线性提升,但 CCFormer 的拟合斜率明显更陡,序列每翻倍一次获得的增益更大,0.5k 长度下的效果已与 HSTU 在 2k 长度下大致相当。公开数据集 KuaiRec 上的结论一致:序列长度从 200 增至 1000,CCFormer 在每个长度上都领先 HSTU、STCA 与 OneTrans,200 长度下的 AUC 已接近或超过其他方法在 1000 长度下的水平。这两组结果说明,CCFormer 不只是在固定预算下更优,把算力投入换成效果的效率也更高。
2.4 业务应用效果
CCFormer 模型已在 5 个真实业务场景上取得显著的效果收益,具体数据如表 3 所示。
表 3 | CCFormer 五个业务场景的离线效果与在线 A/B 实验效果
2.5 小结与展望
TGR-GenRank 方向把传统 DLRM 范式的排序模型迁移到统一 token 化加 Transformer 骨干的生成式范式。CCFormer 把跨域交叉与序列内交互解耦,以特征域分离的 cross attention、子空间序列交互和层级卷积压缩替换了 DLRM 的特征抽取层与特征交互层。在模型效率上,相比 HSTU 等业界方案,CCFormer 以约一半的算力取得更优的离线效果,训练提速 2.21×,并在模型规模与序列长度两个维度上表现出更陡的 scaling 曲线;在模型效果上,CCFormer在5个业务场景的 A/B 实验取得统计显著的效果收益,并已在多个场景推全上线。此外,CCFormer论文《CCFormer: Efficient Cross-Field Interaction and Hierarchical Sequence Compression for Industrial Recommendation at Tencent》已投稿至顶会。
展望未来,TGR-GenRank 方向将沿三条线继续推进:一是跨场景的 backbone 模型基座,让同一个排序骨干服务多个业务场景;二是终身序列建模,覆盖更长时间跨度的用户行为,并探索更贴合推荐任务的特征交叉结构;三是持续优化模型 scaling 的斜率,通过稀疏注意力、输入序列与模型拓扑等模型—系统协同设计,在固定的延迟与 GPU 预算内换取更多效果。
三、TGR-GenRec:从 next-item 到 next-slate 端到端生成
TGR-GenRec 方向的目标是用端到端生成模型“部分替换”或“完全替换”级联中的判别式决策阶段,由一个生成模型直接产出用户要看的 item 乃至整屏列表。本章按两种生成范式展开:NTP(next-token prediction)范式的 BARGE 模型,NSP(next-slate prediction)范式的 HiGR 模型。
3.1 从 Next-Token 到 Next-Slate:推荐自回归的结构差异与业界演进
3.1.1 语义 ID 与推荐自回归:与语言自回归的结构差异
如上图所示,端到端生成式推荐的一般流程是:item 的内容(文本 / 图像 / 视频)先编码为语义向量,再经 RQ-VAE 残差量化为 D 层 coarse-to-fine 的层级语义 ID(SID),语义相近的 item 共享高层前缀、叶子层区分个体;用户历史展平为 SID 序列输入 encoder–decoder Transformer,由 beam search 逐 token 生成目标 item 的 SID,只在码本树上存在的路径中搜索,生成的 SID 再映射回 item 或作为检索 query。
这条路与 LLM 同构:不再对全库逐一打分,可以复用 Transformer 骨干、scaling 规律与训练 / 推理基建。但语言自回归不等于推荐自回归,上图下方的对照表列出了七个维度的差异,这七个差异决定了 LLM 的自回归不能原样搬到推荐上,也引出了 TGR-GenRec 的设计出发点:BARGE 在 NTP 范式下修复 token 语义与序列结构带来的缺口,HiGR 在 NSP 范式下把生成单元升级为整屏 slate,并在训练目标与解码上做列表级的协同设计。
3.2 BARGE:面向推荐的自回归生成适配(NTP 范式)
3.2.1 两个结构性缺口:Item Boundary Gap 与 Semantic Drift
如上图所示,端到端生成式模型的标准链路是 item → SID → 自回归解码,这个链路中存在两个结构性缺口:
1)编码端丢失 item结构化信息(Item Boundary Gap):Item 的 SID 层级码字展平之后,同一 item 的 SID 缺少显式分组,Encoder 输入端丢失了 item 结构信息。模型看见的是 token,却没有物品归属信息;同一个 code index 在不同前缀路径下语义不同——如下图所示,第二层的码字 3 在 ⟨1,3⟩ 与 ⟨7,3⟩ 下原始 lookup embedding 相同,对应的却是不同的路径语义。这导致模型要同时承担三重编码负担:恢复边界(哪些 token 属于同一 item)、消歧语义(同一码字在不同前缀下如何解释)、建模偏好(用户行为最终仍以 item 为单位)。
2)解码端的语义漂移(Semantic Drift):如下图所示,层级解码一旦在某一层走岔,之后每一层都只能在错误子树里继续搜索,目标 item 被永久排除。对第三层目标预测质量的量化显示,teacher forcing 下目标概率 0.787、排名 7.4、准确率 80.5%;自回归整体只有 0.015、119.5、1.6%,概率掉到约 1/52。按前缀是否正确拆开看,前缀正确时准确率为 77.0%,前缀一旦出错只剩 0.6%,相差 128 倍。
通过扩大 beam 来解决显然不大可行:更宽的 beam 只能留下更多路径,不能显式判断整条路径的语义是否仍与用户一致;推理时延近似随 beam 宽度线性增长,显存随 B×L 增长;工业场景候选库更大、分布更长尾,局部 token 概率更容易受稀疏反馈影响。
3.2.2 方法设计:OSQ-VAE、ICA、HPR 与 DPD
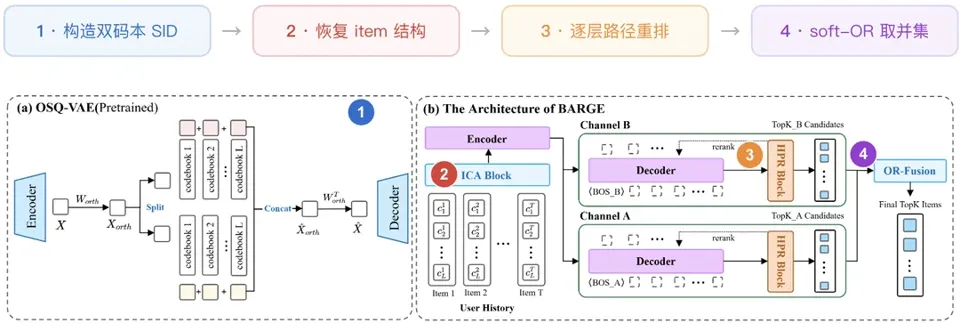
如下图所示,BARGE 在既有 NTP 范式上做结构性适配,分别在 SID 建模(OSQ-VAE)、编码器网络结构(ICA Block)、解码器网络结构(HPR Block)、解码策略(DPD)4 个方面提出了改进方案。
1)OSQ-VAE:正交旋转后一分为二,为每个 item 产出互补的两套 SID。同时,编码器输入两套 SID,两个解码器并行解码两套 SID。
2)ICA Block(Item Context-Aware Attention):如下图所示,在进入 encoder 前,用可学习的 query 对同一 item 的 L 个 SID token 做 cross-attention pooling 得到聚合表示,经 MLP 投影得到 item context,再以门控残差注回每个 token;实测门控强度处于中等区间,模型选择的是”补充”而非覆盖 SID 信息。
3)HPR Block(Hierarchical Path Reranking):用全局路径一致性重排局部 token 概率。如下图所示,在解码器内用累计路径与 decoder 初始隐状态 h₀ 打分,逐层重排 beam;训练用 InfoNCE:正样本是 h₀ 与真值 item 的累计前缀路径,负样本包括同批次内的其他路径、NTP 高概率错误前缀,以及已曝光未点击等业务负样本——针对的正是 PROMISE 负样本太”容易”的问题;推理时的分数是生成分数加 λ 倍的路径匹配分数;每层用 Top-N 扩展评分池,下一层仍只保留 Top-B,beam 宽度不变;h₀ 每层只算一次,候选共享同一个上下文塔。
4)DPD(Dual-Path Decoding):两条通路并行,共享 encoder,decoder 与 HPR 私有,在 item 空间做 soft-OR 融合,任一通路高分即可恢复;两条通路在经验上互补:双通路 Top-10 候选的 Jaccard 仅 0.172–0.183,前 10 名只有约 3 个重合;OR 命中中 15.6%–24.3% 仅由单一通路贡献。
如上图所示,对 HPR 的进一步探索给出了一个更一般的结论:仅增加判别式结构容易与 decoder 概率同质化,有效收益来自额外监督(曝光未点击、NTP 高概率错误前缀)与多目标信号;要把 target 侧特征引进来,需要另一条结构——User–Item 双塔在训练时用对比损失把 target 侧特征带进用户向量,推理时只需要用户向量以 soft prompt 注入 decoder 的起始位置,这个改进点在真实业务数据集上把 Hit@1 从 0.3749 提升到 0.4088(+9.0%)。
3.2.3 实验与部署
3.2.3.1 对比实验
如下图所示,在 Amazon Beauty 与 Sports 两个公开数据集上做全库评估,对比 TIGER、HSTU、COBRA、ActionPiece、APAO-pointwise 五个基线,BARGE 在全部报告指标上最佳:Beauty R@10 0.0927、N@10 0.0547,Sports R@10 0.0544、N@10 0.0308。Beauty R@10 相对最强列内基线提升 16.6%,相对 TIGER 提升 43.1%;Sports R@10 相对最强基线提升 8.8%,N@10 提升 16.7%。
表中的 BARGE-base 是一个对照变体:保留 ICA、HPR、DPD 三个结构模块,但把 BARGE 的 4 层学习码本换成与基线相同的 TIGER 3 层码本(外加一个随机的消碰撞 ID),用来把结构模块的收益与码本设计的收益分开。BARGE-base 在与基线同一套 tokenizer 下已经超过全部生成式基线(Beauty R@10 0.0896,Sports 0.0513),说明三个结构模块的收益不依赖特定数据集、可以跨数据集复现;从 BARGE-base 到 BARGE 的进一步提升(Beauty R@10 0.0896 → 0.0927,Sports 0.0513 → 0.0544)则来自码本设计。
如上图所示,在2个真实业务场景上的离线评估效果:场景 1 有数十万 item,线上召回模型为 GraphSAGE 与 NANN;场景 2 有数千万 item、百亿级交互,线上召回模型为 GraphSAGE 与 BERT-based;OneRec 为内部复现,作为生成式基线。
两个场景的 Hit@5 / @10 / @20 / @50 四项指标上 BARGE 全部最优:场景 1 的 Hit@5 从 OneRec 的 0.5459 提升到 0.6015(+10.2%),场景 2 从 0.0835 提升到 0.0976(+16.9%),而生成式的两条线整体都明显高于线上在用的召回模型。
值得注意的是:1)领先幅度在 Hit@5 上最大、随 K 增大逐渐收窄,说明结构修复主要把目标 item 推到了列表头部,这与 HPR 逐层重排的作用方式一致;2)候选库更大、分布更长尾的场景 2 增益反而更高,印证了 3.2.1 的判断——工业场景下局部 token 概率更容易受稀疏反馈影响,语义漂移更严重,路径级纠偏的价值也更大。
3.2.3.2 服务部署
如上图所示,线上 TGR-GenRec 服务支持两种 SID 到 item 的模式:同一个生成模型经 beam search 输出 50 组 SID 路径,方式 A 直接映射(一条 SID 路径 → 一个 itemID),适合少量精准候选,直接生成 50 个 item 作为一路召回,或直接送精排、替换”召回 + 粗排”链路;方式 B 走 ANN 检索(码本 embedding 求和后做 ANN),适合大 quota 的召回系统——quota=500 时直接 beam=500 性能不可承受,改为生成 50 个 SID 种子、每个种子做 ANN 扩展,去重后约 480、重复率约 4%。按链路 quota 选择:小 quota 用方式 A 精准直出,大 quota 用方式 B 种子扩展进入现有下游级联。
3.2.3.3 业务应用效果
BARGE 的线上 A/B 在小说推荐场景进行,为期两周、6% 线上流量,对照组是现网的多阶段召回系统:CTR +0.60%,点击 UV +1.34%,总阅读时长 +1.70%,三项提升均统计显著。此外,BARGE 模型全量上线后保留的长期反转组进一步显示,CTR 与总阅读时长的提升幅度比两周实验更大、效果更稳定。
如上图所示,把 BARGE 作为一路召回单独下钻,看两个指标:曝光采纳率衡量该通路召回的候选能否通过下游的粗排、精排与混排最终获得曝光;曝光后 CTR 衡量这些候选曝光后能否被用户点击。
对比线上3条代表性通路,BARGE 的曝光采纳率为 1.02%,与图召回的 1.03% 同处第一梯队;曝光后 CTR 为 9.93%,4条通路中最高。这说明 BARGE 带来了现有通路没有覆盖的增量,也正是前面 A/B 实验中 CTR、点击 UV 与总阅读时长同时提升的来源。
3.2.4 小结
BARGE 在 NTP 范式下对基于Transformer的生成式推荐模型做了四处结构性适配:OSQ-VAE 经正交旋转一分为二,为每个 item 产出互补的两套 SID;ICA 在进入 encoder 前聚合 item 级上下文,再以门控残差注回每个 SID token,修复展平后丢失的 item 边界;HPR 在解码器内用累计路径与 h₀ 逐层重排 beam,以 InfoNCE 加上 NTP 高概率错误前缀、曝光未点击等难负样本训练,修复沿前缀级联的语义漂移;DPD 以结构互补的第二条解码通路和 item 空间的 soft-OR 融合,找回单通路不可达的 item。
离线效果上,公开基准 Beauty 与 Sports 的全部指标最佳,Beauty R@10 相对最强基线 +16.6%;两个工业场景的 Hit@5 相对 OneRec 分别 +10.2% 与 +16.9%;在线效果上,线上 A/B 中 CTR +0.60%、点击 UV +1.34%、总阅读时长 +1.70%,作为单路召回的曝光采纳率 1.02% 处于第一梯队、曝光后 CTR 9.93% 为各通路最高,BARGE 目前已在小说推荐场景全量上线。此外,BARGE 的论文《Bridging the Structural Gap: Adapting Autoregressive Generation for Recommendation》已投稿至顶会。
3.3 HiGR:基于分层规划的列表级生成式推荐框架(NSP 范式)
3.3.1 从 item 级生成到 slate 级优化的三个断层
BARGE 解决了”如何生成一个 item”,尚未解决”如何生成一张好列表”。让模型直接生成推荐列表的挑战更大,推荐列表质量不只取决于每个 item 的相关性,还取决于列表级的排序位置,列表内关系与多样性。如下图所示,把 NTP 范式的 item 级 SID 生成直接扩展到工业级 slate 优化,存在三个断层:
1)纠缠的 SID 空间。标准残差量化得到的 SID 前缀既不反映 item 语义也不反映协同关系,前缀相同不一定代表类别相同,前缀不同的物品却可能相似;前缀不一致,就很难在 slate 内控制 item 的相关性与多样性。
2)低效的细粒度解码。M 个 item × D 层 SID 需要解码 M×D 个 token,全序列 beam search 在实时约束下推理耗时高,难以满足实时推荐要求;而且把 item 内的语义组合与 item 间的转移纠缠在一起,掩盖了全局 slate 结构。
3)目标错位。token 级似然并不优化用户感知的 slate 质量,即排序顺序、真实兴趣、列表内多样性等多个列表级目标。
HiGR的设计思路是通过tokenizer、解码器与训练目标协同设计,分别对应以上三个断层:PCRQ-VAE 给出结构化的前缀对齐 SID 空间,HSD 分离 slate 规划与 item 解码,ORPO listwise 对齐面向列表偏好。
3.3.2 方法设计:PCRQ-VAE、HSD 与 ORPO listwise 对齐
如上图所示,HiGR 的总体框架是”编码 → 规划 → 生成 → 对齐”:(a) PCRQ-VAE tokenizer 产出前缀对比的语义 ID;(b) 层次化 slate 解码器由粗粒度规划器和细粒度 item 生成器组成;(c) ORPO 做 listwise 多目标对齐。
3.3.2.1 PCRQ-VAE tokenizer 语义编码
在生成式推荐中,物品SID化(tokenization)的作用对模型效果影响很大,SID 质量在很大程度上决定了生成式模型的效果上限。传统的RQ-VAE模型虽然能降低词表大小,但在工业落地中暴露出了“前缀语义纠缠”与“残差坍塌”的两大核心问题,导致生成模型难以精准把控推荐意图,在列表级生成式推荐任务中这个问题尤为突出。
1)ID纠缠。在标准RQ-VAE中,量化仅由重构误差来驱动。这导致生成的Codebook缺乏语义拓扑结构——前缀相同不一定代表类别相同,而前缀不同的物品却可能非常相似。对于分层规划器来说,如果ID不具有明确的语义聚类特性,它就无法准确地规划出高层的“意图”。
2)残差坍塌。随着量化层数迭代,后续层级的残差向量往往趋近于零,导致深层码本实际上不承载信息,退化为噪声,浪费了编码容量。
如上图所示,我们引入对比学习对前缀做约束、引入全局量化抵抗残差消失现象,让语义ID的前缀成为可靠的语义锚点。
1)前缀对比约束
我们在量化器中的前D-1层引入InfoNCE loss,选择语义相似的item或共现率高的item作为正样本,选择批次内其他随机样本作为负样本。让前缀ID负责“聚类”,将相似物品拉到同一个ID前缀下;让最后一层ID负责“区分”,保持对具体物品的细粒度辨识能力。完美契合我们的“先规划,后生成”的分层策略。
2)全局量化损失
不同于传统逐层累计的量化损失,我们针对量化器前后的编码向量和量化重构向量构造全局损失,有效抵抗了残差消失现象,迫使深层码本必须承载有效信息,显著提升了ID的表达一致性。
3.3.2.2 层次化 slate 解码器 HSD
如上图所示,HSD 把 slate 的生成拆成"规划"和"生成"两层:
1)下层是粗粒度的 slate 规划器:一个 L_slate 层的 Transformer 以 BOS 和上下文 embedding 起步,在紧凑的偏好 embedding 空间里逐位置自回归——先输出第 1 位的偏好 î₁,把该位置生成的 item i₁ 回填为输入再输出 î₂,依此类推,每个 slate 位置对应一个 embedding,先把整屏的意图定下来。
2)上层是细粒度的 item 生成器:经过共享的 Projector 后,一个 L_item 层、所有位置共享参数的生成器把每个偏好 î_m 落成一条 D 个 token 的短 SID 序列(s¹_m, s²_m, s³_m),再映射回 item;因为参数在位置间共享,模型大小不随 slate 长度增长。
相比于标准的Transformer结构,HSD 不再像 NTP 平铺那样纠缠在一条 M×D 的长序列上,item 内的语义组合(D 步)和 item 间的转移(M 步)被分到两个模块里。
推理时规划器贪心解码,beam search 只在每个 item 的短 SID 序列内进行,搜索空间大幅缩小:解码复杂度从 O(B·M³·D³·l_slate·d) 降为 O(M³·l_slate·d + B·M·D³·l_item·d),beam 宽度 B 只作用在短的 item 级序列上,相比 NTP 平铺式解码再拼成列表,推理可提速数倍。
同时,多样性在规划阶段就可以控制:对规划器输出的各位置 embedding 施加多样性损失 L_ILD = −1/(M(M−1)) Σ_m Σ_{n≠m}(1 − cos(î_m, î_n)),最小化它等于拉大不同位置偏好之间的余弦距离,让整屏的意图在解码出具体 item 之前就彼此错开,而不是事后靠打散规则补救。
深度分配上,在固定总深度的条件下规划器 14 层加生成器 2 层是最佳生产配置,相比 12 的分配延迟降低 26%,NDCG@5 仅相对下降 0.6%——说明算力应主要投在规划整屏意图上,item 级解码用很浅的网络即可。
3.3.2.3 ORPO listwise 对齐:列表级的多目标偏好对齐
如上图所示,在生成式推荐的工业级落地中,直接照搬 LLM 领域的对齐算法面临显著的效率收益瓶颈:
1)DPO(Direct Preference Optimization)
1.1)机制痛点:DPO的损失包含一项参考模型的预测结果。这意味着训练过程中,必须始终加载冻结参数的参考模型进行同步推理。
1.2)工业阻碍:推荐模型的参数量虽然不如LLM巨大,但是数据量极大。参考模型的存在导致显存占用翻倍,训练吞吐量减半。在小时级更新的推荐业务中,这种训练延时是不可接受的。
2)GRPO(Group Relative Policy Optimization)
2.1)机制痛点:DeepSeek 提出的强化学习方法 GRPO,通过对同一prompt采样G组输出,计算组内相对优势,从而省去了critic model。其核心假设是环境能对每一次采样给予即时、准确的反馈。
2.2)工业阻碍:GRPO在数据、代码任务中有效,是因为有明确的答案检查器。但在推荐场景中,离线训练无法实时把生成的G个推荐列表推给用户,在没有高保真用户模拟器的情况下,GRPO很难直接应用于离线推理策略学习。此外,列表序列推理是token-by-token生成的,生成G组完整列表极其耗时,会导致训练时长爆炸。
ORPO(Odds Ratio Preference Optimization)无需参考模型,把偏好优化折叠进监督学习——监督项保精度、对比项拒绝差的 slate。
因此,HiGR 选择 ORPO :L_ORPO = L_SFT + λ·L_Odds,其中 L_SFT 是正样本列表的 token 级负对数似然,L_Odds 把正、负列表在每个位置上的生成赔率 π_θ/(1−π_θ) 取对数后沿序列累加、作差,再经 sigmoid 取负对数。 直观上,SFT 项负责让模型学会生成高质量列表,Odds Ratio 项让优势列表的生成赔率显著高于劣质列表;工程上它无需参考模型、无需在线采样,单模型、单向传播,一次前向同时完成监督与偏好对齐,训练速度与普通 SFT 几乎持平,显存占用大幅降低。
偏好对的构造采用"三元目标"策略,正样本三目标共用:用户真实观看且高停留时长的序列,按反馈强度重排;负样本按准、好、多样三个目标分别构造:
1)排序保真(Ranking Fidelity):把重排后的正样本随机打乱顺序,让模型学会"把好东西率先推出来";
2)真实兴趣(Genuine Interest):把正样本中的物品替换为用户曝光未点击或负反馈的物品,让模型学会剔除"标题党"和无效曝光;
3)列表多样性(Slate Diversity):以正样本的第一个物品为锚点、后续全部填充与锚点相似的 top-k 物品,让模型学会惩罚"信息茧房"、主动追求多样性。三类样本对全部从隐式反馈中挖掘,无需人工标注。
3.3.3 推理加速
为进一步降低训练和推理成本,我们还从多个角度对HiGR进行了系统性的工程优化,包括采用大语言模型中常用的加速手段,如Flash Attention,KV Cache等。此外,我们在实际落地中发现Beam Search仍是耗时最多的几个环节之一,因此我们也优化了Beam Search的整个流程,以及优化了整体的代码实现,减少不必要的重复计算和优化耗时操作,综合所有的优化手段,将推理速度提高了5倍以上。
| 加速方法 | 训练加速 | 推理加速 | 加速效果 |
|---|---|---|---|
| Flash Attention | ✅ | ✅ | 强,2-3倍提速 |
| KV Cache | ❌ | ✅ | 较弱 |
| Memory Beam | ❌ | ✅ | 强,2-3倍提速 |
| 其他工程优化 | ✅ | ✅ | 较强,1倍提速 |
1)Flash Attention:LLM中常见的加速手段:通过分块计算,极大减少了 GPU 显存(HBM)与片上高速缓存(SRAM)之间的数据读写次数(IO),从而突破显存带宽瓶颈,显著提升长序列推理的计算速度,在HiGR落地中加速效果明显。
2)KV Cache:通过缓存历史 Token 的 Key 和 Value 状态,使模型在自回归生成新 Token 时无需重复计算前文所有 Token 的 Key / Value,避免了冗余计算,降低解码阶段的延迟。但由于推荐场景中的序列长度远不及LLM中的序列长度,推理加速效果不如flash attention明显。
3)Memory Beam:利用GPU的GEMM并行计算能力,优化beam search的实现流程,避免了当beam width很大时,需要将序列复制beam width份输入到模型中带来的额外巨大计算量,在HiGR落地中加速效果明显。
4)其他工程优化:优化具体代码实现中的不合理实现,避免重复计算,优化耗时操作。
3.3.4 实验效果
3.3.4.1 对比实验分析
如上图所示,在真实业务数据集与开源数据集 KuaiRec 上,HiGR 与 ListCVAE、BERT4Rec、SASRec、TIGER、HSTU、OneRec-25M 对比:同为 25M 参数,HiGR 在工业数据集的 5 个指标上全部超过最强基线 OneRec-25M,Impressions Hit@5 +15.9%、Effective Views Hit@5 +21.3%、NDCG@5 +21.2%;KuaiRec 上 NDCG@5 +5.2%、有效观看 Recall@5 +16.4%。HiGR-25M-w/o RL 已超过 OneRec-25M,ORPO 之后进一步提升;100M 模型的 NDCG@5 达到 0.0831,较 OneRec-25M +41.1%,收益随模型容量继续增长。
3.3.4.2 消融实验分析
接下来,我们介绍下tokenizer、解码器与对齐三个模块的消融实验分析。
如上图所示,SID 质量用三个指标衡量:
1)碰撞率(Collision):是不同 item 被映射到同一 SID 的比例,越低越好;
2)集中度(Concentration):是共享同一前缀的 item 的类目纯度;
3)一致性(Consistency):是每个前缀组内 item 两两类目一致的比例,越高越好。
只对前 D−1 层施加对比约束的 prefix2 是最优配置:碰撞率降到 2.37%,集中度 93%,一致性 66.47%,较 RQ-VAE 提升约 10.7 个百分点——对比学习改善了码本空间的分布,而 D−1 的约束范围既保留了高层的语义层级,又把最后一层留给 item 的唯一身份。把约束延伸到叶子层(prefix3)则有"身份坍缩"的风险:一致性只有边际提升,碰撞率却升高近 4 倍(0.0237 → 0.0873)。因此,前缀级约束是在不损失细粒度 item 区分度的前提下获得语义一致性的关键。
如上图所示,HSD 的消融针对三个设计:多样性正则 L_ILD、上下文嵌入(CE)与 item 生成器的参数共享。
1)去掉 L_ILD 后,各项准确性指标几乎不变(NDCG@5 0.0753 → 0.0755),但列表内多样性 ILD 从 0.62 降到 0.59,说明这一项正则(最小化规划阶段偏好嵌入两两之间的相似度)确实在不牺牲准确性的前提下提升了列表内多样性;
2)去掉上下文嵌入后效果明显下滑,曝光 hit@5 从 0.2994 降到 0.2785,有效观看 hit@5 从 0.2012 降到 0.1837,NDCG@5 从 0.0753 降到 0.0664——上下文编码器产出的表示在规划与生成两个阶段都作为 cross-attention 的 key / value,是 SID 条件解码的依据,拿掉之后生成器失去了条件信息;
3)为每个 slate 位置单独配一个 item 生成器(Non-shared)并没有带来明确收益,各项指标与共享版本互有高低(NDCG@5 0.0748 vs 0.0753),因此 HiGR 采用跨位置共享的单个 item 生成器,既节省参数,也天然支持变长 slate 的生成。
如上图所示,偏好对齐的消融以列表内多样性 ILD 为指标,在工业数据集与 KuaiRec 上对比各模型:
1)即使不做偏好对齐,HiGR w/o RL 的 ILD 已经高于 TIGER、HSTU 与 OneRec(工业数据集 0.52 vs 0.38 / 0.42 / 0.48,KuaiRec 0.55 vs 0.40 / 0.43 / 0.50),说明在 slate 层面做层次化解码并施加多样性正则,结构本身就带来了多样性收益;
2)在此基础上做偏好对齐能进一步提升多样性,DPO 把 ILD 提高到 0.57 / 0.60,ORPO 则达到两个数据集上的最高值 0.62 / 0.63,优于 DPO——列表级多目标 ORPO 把"多样"作为显式的对齐目标,其效果在这里得到了直接验证。
如上图所示,在总层数固定的前提下比较 slate 规划器与 item 生成器的层数分配:
1)质量上,层数向规划器倾斜更有效:14+2 与 12+4 的 NDCG@5 最高(0.0631、0.0635),继续把层数挪给生成器后效果持续下降(10+6 为 0.0621,8+8 为 0.0605)——slate 规划是全局的列表级建模,需要足够深度,item 生成只是轻量的 SID 解码。
2)时延上,生成器每多一层代价都很高:12+4、10+6、8+8 的时延分别升至 1.355×、1.710× 和 2.065×,因为生成器的层数要与 beam 宽度和 SID 长度相乘,规划器的层则只在 slate 层面执行一次。
综合来看,14+2 是质量与时延的最佳折中:相比 12+4,推理时延降低 26%,NDCG@5 仅下降 0.6%;而 15+1 时延只再降一点(0.932×),NDCG@5 却掉到 0.0623。因此 HiGR 默认采用 l_slate = 14、l_item = 2。
3.3.4.3 模型 scaling 效果分析
如上图所示,在模型Scaling 效果上,参数量从 0.05B 到 2B,收敛 loss 逐渐降低、NDCG@5 上升,HiGR 具备 scaling law 性质。推理效率上,右图横轴是推理吞吐(每分钟处理的请求数,单位为万),纵轴是 recall@5,每个点对应一种模型与解码方式的组合。相对 OneRec 的 beam 解码,HiGR(无论是否启用 KV cache)都位于右上方——吞吐高出数倍、recall@5 也更高;相对 OneRec 的 greedy 解码,HiGR 在吞吐相近的情况下 recall@5 大幅领先(约 0.071 对 0.046)。综合来看,HiGR 实现了 5 倍左右的推理速度提升,同时推荐指标更高。
3.3.5 业务应用效果
如上图所示,HiGR 已在腾讯新闻、QQ浏览器小说等多个业务场景推全,已全流量上线的3个场景的收益各有侧重:场景 1 的参与度指标全面提升,人均停留时长 +1.03%、人均观看时长 +1.22%、人均视频播放 +1.73%、人均请求数 +1.57%;场景 2 用户响应与变现同时提升,CTR +0.68%、广告收入 +0.56%;场景 3 的观看时长提升,人均观看时长 +1.14%、人均视频播放 +0.88%。更重要的是,这些收益是在推理成本下降的前提下取得的:得益于层次化解码与 beam search 等推理加速优化,推理耗时与成本大幅降低。
3.3.6 小结
HiGR 的出发点是把 NTP 范式的 item 级 SID 生成直接扩展到 NSP 范式的 slate 生成,而推荐列表生成会遇到纠缠的 SID 空间、低效的细粒度解码与目标错位三个断层,HiGR 用 tokenizer、解码器与训练目标的协同设计逐一回应:
1)PCRQ-VAE 只对前 D−1 层码字施加前缀对比约束,高层前缀共享语义、叶子层保留 item 身份;
2)HSD 把 slate 规划与 item 解码分离,粗粒度规划器在偏好 embedding 空间逐位置规划整屏意图,共享的细粒度生成器把每个偏好落成短 SID 序列,beam search 只在 item 级短序列内进行;
3)ORPO listwise 对齐无需参考模型,从隐式反馈中构造排序保真、真实兴趣、列表多样性三类正负 slate 对,把列表级的多目标偏好折叠进一次监督训练。
此外,配合 beam 折叠进序列维的 K/V 投影优化、Flash Attention 与 KV cache,HiGR 推理速度提升 5 倍以上,训练速度提升 2 倍以上,成本降低 60%。
据我们所了解的公开信息,HiGR 是业界首个工业化落地的列表级端到端生成式推荐模型框架,HiGR 论文《HiGR: Industrial-Scale Hierarchical Generative Slate Recommendation Framework in Tencent》已被 CIKM 2026 录用(Oral Presentation)。
3.4 GenRec 方向总结与展望
TGR-GenRec 方向探索用生成式模型替换级联中的判别式决策阶段,沿 NTP 与 NSP 两种生成式范式分别提出了 BARGE 与 HiGR,并均已在线上业务落地。NTP 范式的 BARGE 做推荐自回归适配:ICA 恢复 item 边界、HPR 以路径一致性重排 beam、DPD 提供第二条解码通路,三个模块不改 NTP 骨架,已作为一路生成式召回在小说推荐场景全量上线。NSP 范式的 HiGR 把生成单元从 item 升级为 slate:PCRQ-VAE 结构化 SID 空间,HSD 分离规划与生成,ORPO 做列表级多目标对齐,同规模效果优于 OneRec,推理提速 5 倍以上,已在腾讯新闻、QQ 浏览器等多个场景推全。此外,BARGE 的论文已投稿至WWW 2027,HiGR 论文已被 CIKM 2026 录用(Oral Presentation)。
展望未来,TGR-GenRec 的下一步沿五个方向继续探索:
1)生成与排序合一:共享骨干的"生成 + item 级打分"头,用 item 级分数替代 beam 似然做最终排序,让一个模型逐步承担召回与粗排 / 精排的职责;
2)价值对齐与多目标可控:引入在线反馈 RL(时长 / 转化 / 商业价值奖励),用可控解码替代多路配额,加入业务价值感知 token;
3)tokenizer 统一升级:合并为一套协同感知 tokenizer,自适应碰撞处理、多维码本、跨场景统一码本;
4)推理原生的生成:latent thinking token 逐层引导 SID 解码,Looped Transformer 按请求自适应循环深度,测试时算力弹性伸缩;
5)scaling 效率的模型—系统协同设计:支持 2B 以上更大的在线推理模型,统一规划器与生成器,引入稀疏注意力与加速器友好的约束解码。
这五个方向中,"推理原生的生成"指向一个更根本的问题:如何把大模型的推理能力引入生成式推荐。下一章的 TGR-Reason 正是围绕这个问题展开。
四、TGR-Reason:大模型推理增强与快慢思考协同
前两章分别介绍了 TGR-GenRank 与 TGR-GenRec,解决的是排序模型的算力效率与端到端生成两个问题;但无论判别式打分还是生成式解码,模型学到的都是行为共现:协同信号密集处很强,稀疏处表现欠佳。冷启动用户、长尾 item 与意图模糊的会话正是协同信号的边界,也是大模型的世界知识与推理能力能够补位的地方。问题在于推荐系统每天数十~千亿次请求、数十~数百毫秒的延迟预算,大模型思考推理的成本和耗时都难以达到要求。TGR-Reason 方向的核心思路是”快慢思考”的分工:慢思考(大模型推理)在离线或训练期完成,快思考(在线生成式模型)毫秒级响应,两者通过共享的 SID 空间与 reason tokens 接口衔接。本章按两部分展开:训练期把推理摊销进模型参数的 LatentRec,以及把 Think 模型的推理结果物化为 reason tokens、在线零推理注入生成器的 TGR-Reason 系统。
4.1 协同信号的边界:冷启动、长尾与意图模糊
如上图所示,判别式与生成式推荐模型两者主要都在拟合行为共现:“看过 A 的人接下来看 B”——协同信号密集处很强,而在以下三类协同信号稀缺的场景效果欠佳:1)新用户 / 冷启动,历史序列为空或极短,没有共现证据可用;2)长尾 item,协同信号稀疏,几乎没有交互边可学;3)意图模糊的会话,历史指向多个方向,需要意图推断。
如上图所示,业界针对冷启动、长尾与意图模糊的既有解法可以归成两类:
1)借旁证,用替身代替缺失的行为。比如,人群先验(POSO,新用户组专属子模块加个性化门控,防止新用户特征被大盘”淹没”)、内容对齐(M3CSR,多模态 embedding 聚成可训练簇 ID,再与行为对齐进协同空间)、跨域迁移(EMCDR / MeLU,跨域映射或元学习”好初始化”,用几条交互快速适配)、探索采集(bandit 与兴趣选择页,主动采集反馈),最终都对齐进协同空间当作行为用。
2)多备选,判断不了就多路覆盖。比如,多兴趣向量(MIND / ComiRec,多向量分头覆盖多个可能意图)、解耦去偏(Google CDN / IPS,头尾解耦、重加权尾部样本,去流行度偏差)、情境约束与多样性(用时间 / 场景 / 多样性约束缩小候选范围)等。
两类解法的共同结构是一种补充证据加一种归纳偏置,但没有”推断”能力。
如上图所示,总结了业界把大模型接入推荐系统的五类常见方式,外加一层可叠加的推理:
A)表征增强,LLM 表征或语义码进协同模型当特征(如快手 LEARN、QARM,字节 HLLM,小红书 NoteLLM等);
B)离线推理产出知识或画像,缓存后作特征或召回通路(如淘宝 RecGPT,Amazon COSMO,美团 CoEA等);
C)模拟与数据增强,LLM 为冷物品、新用户”造”交互(如Google 数据增强器,阿里 ColdLLM / FilterLLM等);
D)物品 token 空间,LLM 扩 SID 词表,用行为序列继续预训练加 SFT,自己生成物品(如Google PLUM,Spotify GLIDE等);
E)自然语言空间,物品与行为写成文字,LLM 微调或零样本打分(如LinkedIn 360Brew,LLM-Ranker等);
推理叠加层可叠在任意骨干网络上、不限于 LLM,显式 CoT 如 OneRec-Think / OneReason,隐式 latent 多步如 ReaRec、LARES、LASAR、PauseRec等。
综上所述,协同信号在一定程度上是管”记忆”,而大模型是补”推断”能力,“协同 + 推断”的融合是业界积极探索的演进方向。
4.2 快慢思考:推理增强推荐的范式与业界路线
4.2.1 快慢思考:从双过程理论、LLM 到推荐系统
如上图所示,“快慢思考”在三个领域的运作机制:
1)认知科学中(Kahneman《思考,快与慢》),System 1 直觉、自动、并行,几乎不耗注意力,快但带系统性偏差;System 2 审慎、串行、耗费注意力,能做逻辑与反事实推理,但昂贵;两者的协作方式是默认 System 1,新奇、冲突、高风险时 System 2 介入纠偏,技能熟练化把慢的推理沉淀为快的直觉。
2)LLM 中,直接作答(non-thinking)一次前向逐 token 输出、延迟低,难题上容易”想当然”;思维链 / 长推理(thinking)用更多推理 token 换准确率(test-time scaling);协作方式是混合模式在同一模型内切换 thinking / non-thinking 并给推理设预算,以及蒸馏,把慢的输出蒸馏回快模型。
3)推荐系统中,快是一次前向直接匹配,编码历史后直接生成或匹配候选;慢是多步推理,显式 CoT 或隐空间 rollout;协作的核心问题是慢的一步放在哪里——请求内按需路由、离线 / 近线缓存、还是训练期摊销。沿这个思路,LLM 思考推理增强推荐的设计主要涉及两个关键问题:推理范式与部署方式。
4.2.2 推理范式:显式 CoT 与隐式 latent
如上图所示,推理范式的第一种是显式 CoT——用文字想,可读可解释,但推理开销较大,有两种形态:
1)在线 CoT 让每个请求都在请求路径上逐 token 写思维链,数百 token 的生成超出数十~百毫秒的延迟预算。
2)Think-Ahead 把思维链离线写好、只缓存结果,在线按前缀约束解码:离线做全量 OneRec-Think 推理,得到推理路径与首批 SID token,按用户缓存;在线读缓存前缀,由轻量 OneRec 做约束解码,请求路径不再写思维链——这是 OneRec-Think 的上线形态。
第二种是隐式 latent——在潜在空间内思考,开销降到 K 步前向。如上图所示,编码历史得到 h₀ 后做 K 步隐向量 rollout,h₁、h₂ … h_K 每步一次前向、不写 token,再预测或解码 SID。
4.2.3 部署方式:请求内快慢路由与离线 / 近线推理
如上图所示,部署方式的第一种是在线推理——请求内按需深思,慢思考仍在请求路径上。请求经编码后由路由决定这次要不要“慢思考”:大多数请求走快路径,单次前向直接解码;少数请求(新用户、低活用户、不确定时)走慢路径,K 步 latent 或 CoT 之后再解码。业界有四种常见做法决定要不要思考、要思考多深:学习到的 selector / planner 按样本路由;预测与反馈不一致时触发反思;收敛即停,多想一步预测不再变化就停;流量分层,按用户群或场景分流。
第二种是离线 / 近线推理——慢思考不在请求路径上,如上图所示有两种方式:
1)训练期摊销:慢思考(CoT 或多步 latent)经蒸馏或逐步监督内化到模型参数里,在进行“慢思考”时模型直接解码。
2)离线 / 近线物化:慢模型(LLM / Think 模型)逐用户或逐物品推理一次,把推理前缀、指令 / 标签、候选池或 reason tokens 等物化产物写入按用户或物品组织的存储,在线请求只做一次点查与注入,解码时零推理 rollout。
4.2.4 全景图:推理范式 × 部署方式与 TGR-Reason 的路线选择
如上图所示,以推理范式为纵轴、部署方式为横轴,可以把业界工作放进一张 2×2 的全景图,实线为已上线或线上 A/B 的系统,虚线为论文或离线评估。
TGR-Reason 的解决思路是:LatentRec 在训练期把推理摊销进参数(K=0),TGR-Reason 把 Think 模型的推理结果物化为 reason tokens,注入在线生成式模型。下面分两节展开介绍。
4.3 LatentRec:隐空间“思考–生成”一体化
4.3.1 研究背景:推荐推理的收益与生成成本
LatentRec 的出发点是把推理过程转化为推荐训练信号。如上图所示,业界三条线索各有启发:
1)文本推理与任务对齐——OneRec-Think 分 item 对齐、推理激活、推荐奖励 RL 三阶段:由用户历史与目标 item 事后构造偏好推理轨迹做 CoT-SFT,先激活推理与推荐的关联,再以此为冷启动用推荐奖励 RL 校准;
2)连续隐状态与知识蒸馏——COCONUT 把上一步末层 hidden state 作为下一步输入,以连续向量承载中间计算;CODI 共享 LLM、通过 LKD 对齐师生隐藏表示;
3)推荐中的逐步监督——ReaRec 逐步监督各推理步的状态并配合温度逐步降低,使中间状态直接获得推荐训练信号,启发是把这种监督迁移到 LLM 的 SID 预测头。
由此 LatentRec 聚焦两个问题:一是 latent 推理迁移到 SID 解码时,反馈输入与监督如何设计;二是推理期不做 latent rollout 时,训练收益能否保留。
4.3.2 方法设计:隐空间“思考–生成”一体化
如上图所示,LatentRec 的总体架构是训练期多步展开、生成期直接解码。
(a) 总体流程:用户行为历史经 LLM Encoder 得到 h₀,连续思考模块 CTM 迭代 K 次(初始 h_k = h₀),SID Decoder 输出完整 SID(s_a、s_b、s_c、s_d);
(b) STS(Soft Token Selection)构造每一步的反馈输入;
(c) PRL(Per-step Reasoning Loss)监督每个中间状态。
训练时 K_train = 2:用户历史产生 h₀,STS 构造反馈输入,LLM 结合 KV cache 得到 h₁、h₂,PRL 分别监督 h₁、h₂,完整 SID 序列接受自回归 CE。
生成时 K_eval = 0:用户上下文直接进入训练后的 LLM,自回归预测完整 SID,跳过 CTM 展开,保留训练中更新的共享 LoRA,以及标准的 SID 解码与候选搜索。
LatentRec 模型可训练参数很小:Qwen3-1.7B 底座,LoRA rank 16,STS 的 64 个 soft token 约 2.5M 参数,新增参数小于骨干的 0.2%,仅更新 LoRA、soft tokens 与 W_q,训练 3 个 epoch、batch size 64。
两个机制的细节如上图所示:
1)STS 解决的是反馈输入的表示不匹配:hidden state 的范数约 45,词表 embedding 的范数约 3,相差约 14 倍,直接把隐状态反馈回输入会改变下一步输入的尺度与方向。STS 维护 N=64 个可学习向量,由词表 embedding 初始化;当前隐状态经线性投影 W_q 形成 query q_k,对 token bank 做 softmax 加权求和得到 e_k,作为下一步的输入,再经 LLM 前向(带 KV cache)得到 h_{k+1}。
2)PRL 共享预测头、直接监督推荐目标:每个中间状态 h_k 经过同一个 LM head 预测目标的第一层 SID y¹,损失是各步 CE 的平均,总损失 L = L_CE + λ·L_PRL,λ = 0.1;温度逐步降低,T_k = T_b + T_s(1 − k/K),T_b = 1、T_s = 5,K=2 时 T₁ = 3.5、T₂ = 1.0,早期分布较软,最后一步更聚焦目标。
为什么只监督首层 SID:更深码字需要在每步提供目标 SID 前缀,会把 latent 轨迹与固定解码路径耦合;首层监督可以独立施加,完整序列仍由标准自回归目标学习。
4.3.3 实验效果:推荐收益、生成效率与消融分析
如上图所示,主实验在 Amazon Beauty、Toys、Sports 三个数据集上比较 GRU4Rec、SASRec、BERT4Rec、HGN、TIGER、ReaRec、LLM-CoT SFT 与 LatentRec(Qwen3-1.7B,全库排序,beam=50)。K=0 的 LatentRec 在三个数据集的 HR 与 NDCG 四项指标上均优于全部基线,HR@10 相对 CoT SFT 在 Beauty +5.0%、Toys +4.5%、Sports +4.0%。
推理成本上(Beauty 数据集,单张 H20,batch=1),CoT SFT 每个样本要额外生成 128 个文本 token,单样本耗时 10.80 秒;LatentRec K=0 不做 latent 展开,单样本耗时 0.59 秒,推理耗时降低到原来的约 1/18,HR@10 还从 0.0625 提高到 0.0656;K=1 耗时 0.61 s、HR@10 0.0660,但在三个数据集上没有一致的收益,默认采用 K=0。
接下来,通过消融实验分析来看收益来自哪里、展开多少步合适,如上图所示:
1)PRL 的效果增量:在 CoT SFT 的 0.0625 基础上继续 LoRA 训练到 0.0629,加 CTM 到 0.0633,加 PRL 到 0.0656,最后一步相对提升 +3.63%,是三步中最大的一步。
2)训练与生成深度的关系:K_train=2 的 K=0 结果最强,K_train=4 在 K=1 处达到最优,K_train=16 整体偏低;展开更多步未必更好,训练与测试深度需要匹配,跨三个数据集默认 K_eval=0。
3)CoT 初始化对照:有 CoT 初始化与无 CoT 初始化在 K=0 时收敛到相同的 0.0656,随着展开加深差异扩大(K=16 时 0.0634 对 0.0583)——CoT 初始化在深层 latent 展开时有助于稳定效果,K=0 的直接生成路径则不依赖这一初始化,训练阶段的监督方式与生成阶段的展开深度需要分别选择。
4.3.4 解码性能优化
如上图所示,以小说推荐业务的 Think 模型为案例,任务是由用户上下文生成 top-5 完整 SID。
用户输入:包括画像 / 场景(年龄段、城市等级、职业、场景等)、偏好(已有一级、二级小说类目偏好)与行为(按序组织的阅读 SID 与内容标签),冷用户保留画像,缺少历史时使用占位描述。
模型是 Qwen3-1.7B 的 Think 模型,输出 top-5 SID 候选列表,下游 HiGR 共享同一 SID 空间。
输出格式是 4 层码字 × 256,加起止标记共 1,026 个 special token;
每位用户生成 top-5 完整 SID,按累计 log-prob 排序:K=0 是 latent 展开步数,B=5 是候选路径数,6 轮是单条 SID 的 token 长度。
训练先学习内容与 SID 的对齐,再学习用户到 SID 的预测,训练与推理共用 prompt 构造逻辑;候选搜索的优化重点是批量前向与前缀 KV 复用。
解码方案通过一次 POC 确定(vLLM 0.9.0,H20,2,000 条抽样),如上图所示,对比了四种解码路径的 Hit@5 与吞吐。我们采用批量单步 Beam的解码方式,它的做法是把 beam search 拆成"搜索"与"计算"两部分:业务层保存每条候选路径的前缀、累计分数和所属用户,每一轮把全部活跃路径集中提交给推理引擎,只请求下一个 token(max_tokens=1);引擎返回下一个 token 位置的 log-prob 分布;业务层据此在每个用户内部扩展路径、累加分数、保留 top-B,再进入下一轮。分工上,业务层负责候选状态、约束与用户内剪枝,推理引擎负责模型前向、连续批处理与前缀缓存。
批量单步 beam 的一轮如上图所示,以 100 位用户、每人保留 5 条路径为例:
1)当前有 500 条活跃路径,每条带着用户上下文与路径前缀,整批一起提交给 vLLM;
2)vLLM 只计算每条路径下一个 token 位置的输出分布,共 500 个,每个分布取回分数最高的 32 个候选 token;
3)业务层把每条路径扩展成 32 条,每位用户得到 5 × 32 = 160 条、全批共 16,000 条扩展路径,累加分数后在用户内部排序,每位用户只保留 top-5;
4)保留下来的 500 条路径进入下一轮,其余 15,500 条就此淘汰。
效率收益来自两处:合批——整批活跃路径统一交给引擎,由引擎做连续批处理;复用——同一用户的 5 条路径共享同一段用户历史(例如 900 token),vLLM 的前缀缓存按相同 token 前缀命中已有的 KV 块,每条路径只需计算未缓存的部分,跨路径、跨轮次都能复用,已生成的共同前缀同样可以复用。
4.3.5 小结
LatentRec 的出发点是把大模型的推理能力用于 SID 生成,同时不把推理开销带到线上。把推理过程转化为推荐训练信号会遇到三个问题:显式 CoT 要额外生成数百个文本 token,推理成本高;隐状态直接反馈回输入时与词表 embedding 尺度不匹配;中间状态缺少直接的推荐监督。
LatentRec 针对这三个问题分别给出了对应设计:1)CTM 在隐空间做多步展开,不写文本 token,训练展开 K=2、生成时 K=0 直接解码完整 SID,推理收益保留而开销归零;2)STS 用可学习的 soft token bank 构造每一步的反馈输入,解决尺度不匹配;3)PRL 让每个中间状态经共享 LM head 直接预测首层 SID,使中间状态获得推荐监督。
效果上,三个数据集的四项指标均优于全部基线,HR@10 相对 CoT SFT 提升 4.0%–5.0%,单样本耗时从 10.80 秒降到 0.59 秒。此外,配合批量单步 beam 与前缀 KV 复用,8×A100 上 418,227 条样本的生成耗时从 174 分钟降到 80 分钟,总体 Hit@5 从 0.2760 提升到 0.2782。
此外,LatentRec 论文《Do Recommenders Need to Think in Words? Latent Reasoning for Efficient LLM-Based Recommendation》已被 CIKM 2026 录用。
4.4 TGR-Reason 系统:快慢模型 co-design
4.4.1 设计背景:时延、成本与持续学习
LLM 推理难以直接用于线上推荐系统主要有三个原因:
1)时延:推荐请求的延迟预算是数十毫秒~百毫秒,一次 LLM 推理基本都要秒级,相差 1~2 个数量级,单次推理就占满整条链路的预算。
2)成本:请求内推理的总成本随曝光量线性增长,其中大量曝光并不转化,计算被浪费;GPU 还要按峰值配置,低负载时段大量闲置。
3)持续学习:推荐样本分布漂移快,新 item 与新用户持续进入,模型需要小时级或天级的持续学习才能跟上;大模型重训成本高,通常周级发布一版,强行让它高频微调,反而会在窄分布上稀释其通用语义与世界知识。
TGR-Reason 的方案是快慢模型的 co-design:慢模型(Think 模型)负责思考,快模型(在线生成器)负责生成。大模型低频重训,承载语义与世界知识;在线生成器持续学习,承接新 item 与新用户;reason tokens 作为两者的接口,离线预计算并存储,把两种学习节奏衔接起来。
4.4.2 方法设计:快慢思考协同的三层架构
如上图所示,三层部署架构是在线只读、近线按需刷新、离线兜底,三层共享一个以用户 ID 为键的 Reason Store:
1)Part A 在线服务,毫秒级、只读:按 user_id 点查一条 Reason 记录,校验有效期与版本,然后以token或特征等形式注入 TGR-GenRec、TGR-GenRank 的模型。
2)Part B 近线推理,秒级、请求触发:每个请求异步发出触发事件,Reason Trigger Controller(RTC)判据决定算不算,准入的任务交给常驻 GPU 池攒成小批一起算,结果写入 Redis、供用户后续请求使用。
3)Part C 离线推理,日级、吞吐优先:扫描日志与存储元数据识别待重算用户,弹性大批量池整批重生成,周级重训发布后把不兼容记录标为待重算并渐进重建。
4.4.3 工业落地
如上图所示,介绍两种TGR-Reason的应用落地方式:
1)离线召回,KV存储中的 topk_sid 经 SID 倒排索引映射到 item,过滤 / 去重、合规与库存之后进入独立配额的召回队列;
2)在线生成,KV存储中的 topk_sid / cot_emb 经 GMR / DRI 模块注入 TGR-GenRec 的 Encoder–Decoder 解码,生成的 SID 映射到 item;
离线召回的实现方式相对简单,这里不再赘述,重点介绍在线生成的实现方案。
在线生成是把 reason tokens 注入 TGR-GenRec,如上图所示:
1)图中右侧是 LatentRec:用户的个人记忆经 LLM Encoder、CTM 与 SID Decoder,产出 top-K 条完整 SID,即 reason tokens。
2)图中左侧是 TGR-GenRec:encoder 侧有两路——Personal Encoder 编码个人记忆,Group Encoder 编码检索到的群体记忆;decoder 每层以 self-attention 的输出为 query,分别对两路 encoder 输出做 cross-attention,再经 MLP 门控融合。
3)reason tokens 从两个入口进入生成器:
3.1)GMR(Reasoning-Guided Group Memory Retrieval)作用在 encoder 侧——以每条 reason token 为 query,在全量历史序列中检索其后续窗口,得到"推断意图之后用户通常会看什么"的群体记忆,由 Group Encoder 单独编码后与个人记忆门控融合,个人记忆为主、群体记忆按兼容性激活;
3.2)DRI(Direct Reasoning Injection)作用在 decoder 侧——top-K 条 reason token 与 encoder 输出做 cross-attention,结果作为 soft prompt 插在每一层目标码字之前,为逐层解码提供先验;生成的 SID token 数与 beam 搜索空间都不变。
GMR 的四个要点如上图所示:
1)用完整 reason token 做检索 query,检索获取 W 个 item;
2)每个 query 独立取 top-M 再拼接,每个 reason token 按频次保留 M 个高频后继、不做全局重排,保留每个推断意图各自的后续行为,共 K·M 个 item;
3)分离编码、保留来源差异,群体记忆由独立的 Group Encoder 编码;
4)向量门控的非对称融合,解码每层两个独立的交叉注意力分别对应 Personal Encoder 输出与 Group Encoder 输出,个人记忆始终是主信号。
DRI 的四个要点如上图所示:
1)按码本层重组、保留全部 K 个候选,一个 reason token 是一个连贯的候选 item,其码字在各层角色不同,DRI 按层查共享的 SID embedding;
2)以 Personal Encoder 的输出为 query 选证据,Personal Encoder 的输出作为用户兴趣表达,学的是”哪些候选与个人记忆兼容”,而非照抄 LLM 的 top-1;
3)作为连续的层级对齐 prompt 插入解码(叠加位置与类型 embedding),prompt 是增强而非替换用户历史;
4)beam search 前算一次、所有 beam 共享,SID 决策数与 beam 搜索空间都不变,reason tokens 全缺失时 prompt 位置被 mask,退化为原路径。
Decoder 侧还有一种内部探索的注入方式:先选 top-N,再并行多路解码。如上图所示,不把 K 条意图压成一个先验,而是以 Personal Encoder 的 user emb 为 query 对 K 条 reason SID 做相关性打分,挑出最相关的 N 条(N < K),每条各走一路 TGR-GenRec Decoder 得到一组 SID 候选,各路只带一个意图、互不干扰、可并行执行,最后合并去重进入统一精排。
另外一种方式是后训练阶段注入——在 TGR-GenRec 的后训练(OneModel 强化学习,以 LLM 模拟反馈作 reward)中注入 reason 结果,离线暂未取得显著收益。
4.4.4 实验与效果
如上图所示,离线实验以3个测试日等权平均,对照为线上在用的 TGR-GenRec:
1)全部推荐流量上,Hit@1 从 0.3385 提升到 0.4339(+28.2%),Hit@5 +10.4%,Hit@10 +6.3%,Hit@20 +4.1%,Hit@50 +2.4%;
2)主推荐流量上,Hit@1 从 0.2247 提升到 0.3563(+58.6%),Hit@5 +13.1%;
3)主推荐流量中的冷启动用户,Hit@1 从 0.0451 提升到 0.2606(+477.8%),Hit@5 +39.2%,Hit@10 +24.9%,Hit@20 +20.1%,Hit@50 +11.6%。
有两点实验观察:
a)增益集中在列表头部(Hit@1 +28.2% 对 Hit@50 +2.4%),Reason 推理的贡献主要是把合理的目标推到前几位;
b)冷启动用户增益最大,reason tokens 提供了针对新用户缩小目标空间的语义先验。
此外,线上 A/B 小流量实验上,对照为未引入 Reason 的 TGR-GenRec:有效消费率(Effective Consumption Rate)+1.75%,新用户曝光–转化率(Exposure-to-Conversion)+13.09%,两项均统计显著,新用户的转化提升远大于整体。
4.4.5 小结
TGR-Reason 系统通过快慢模型的 co-design 来解决把大模型推理放进线上推荐的问题,架构上分为在线 / 近线 / 离线三层,其中慢模型的思考token注入 TGR-GenRec,是把推理当"先验"——GMR 把 reason 引导的群体记忆注入 encoder,DRI 把 reason 作为层级对齐的 soft prompt 注入 decoder,不增加 SID 决策数与 beam 空间。
效果上,离线全部推荐流量 Hit@1 +28.2%、冷启动用户 Hit@1 +477.8%;线上 A/B 有效消费率 +1.75%、新用户曝光–转化率 +13.09%。
4.5 Reason 方向总结与展望
TGR-Reason 方向探索把大模型的世界知识与推理能力引入推荐系统,补上协同信号之外的"推断"这一步,并且沿慢思考的两种落地方式分别提出了 LatentRec 与 TGR-Reason 系统,并均已在线上业务落地。
展望未来,TGR-Reason 的下一步沿四个方向继续探索:
1)选择性深思:when-to-think、收敛即停与路由策略设计:尝试对高价值 / 冷启动请求在请求时启用 K>0 解码;
2)推理离线化与蒸馏:System 2 → System 1,借鉴 reasoning-augmented LLM 的做法,把 Think 模型的能力蒸馏到更小、更快的变体,缩短刷新周期、扩大覆盖;
3)latent 推理 SID 原生:把逐步监督扩展到更深的 SID 层与整屏 slate,与 HiGR 的规划器协同,让 reason tokens 直接约束整屏生成,并探索 latent 步在 SID 位置上的自适应分配;
4)test-time scaling:建立可预测的算力–效果规律,把推理与排序打通,探索推理增强的"生成 + 排序"一体化方案。
总结与展望
从 CCFormer 到 BARGE、HiGR,再到 LatentRec 与 TGR-Reason,TGR 走的是一条逐段替换的路。排序模型的范式迁移解决了算力效率,端到端生成解决了决策单元与目标割裂,推理增强补上了协同信号之外的”推断”这一步。TGR 各个方向的技术方案介绍已经整合为 TGR 技术报告《TGR: Advancing Industrial Recommendation from Generative-Paradigm Ranking toward Unified Generation and Reasoning》(arXiv 2609.00986)公开发布。
TGR 已在腾讯新闻、浏览器、元宝等多个业务场景规模化落地,用户消费时长、广告收入等核心指标显著提升,TGR各方向已发表多篇论文并申请多项技术专利,部分成果已被AAAI、ACL、CIKM等国际顶级会议收录,下图为部分代表工作。
未来 TGR 将沿三个层面继续展开探索:1)生成式推荐模型的 scaling 效率;2)推理原生的生成与 test-time 计算;3)推荐系统的 Agentic 自进化。
特别是推荐系统的自进化方向,如何在 ROI 约束下,让 LLM 多智能体在有限的算力与线上流量预算内自主提出、验证并沉淀模型改进,把离线迭代与小流量求证连成一个可控、可审计的闭环。TGR 已在这一方向展开探索并取得初步效果,敬请期待后续更多 TGR 系列技术分享。
合作交流
以上生成式推荐解决方案已集成到**“TRS推荐引擎平台”**,如有方案接入或商务合作意向,欢迎随时与我们联系。欢迎访问官网了解更多信息:https://trs.tencent.com
附录
- TGR Team. “TGR: Advancing industrial recommendation from generative-paradigm ranking toward unified generation and reasoning,” arXiv preprint arXiv.00986, 2026.
- Y. Wang, H. Zhang, H. Hu, Y. Li, et al. "CCFormer: Efficient Cross-Field Interaction and Hierarchical Sequence Compression for Industrial Recommendation at Tencent," arXiv.28070, 2026.
- Y. Pang, Z. Liu, Y. Li, et al. "HiGR: Industrial-Scale Hierarchical Generative Slate Recommendation Framework in Tencent," CIKM / arXiv.24787, 2026.
- J. Zeng, J. Zhu, J. Chen, Y. Li, et al. "Bridging the Structural Gap: Adapting Autoregressive Generation for Recommendation," arXiv.21028, 2026.
- H. Su, B. Kong, L. Cheng, C. Zhuo, and Z. Li. "Do Recommenders Need to Think in Words? Latent Reasoning for Efficient LLM-Based Recommendation," CIKM, 2026.
- TRS官网:https://trs.tencent.com/