Cerebras 详解万亿参数模型多芯片部署方案
Cerebras 发布技术博客,详细解析如何将 Kimi K3 等万亿参数级大模型拆分并部署至多个 WSE-3T 晶圆芯片上。该方案利用片上内存优势,实现了每秒 1000-2000+ tokens 的高吞吐推理,解决了单芯片内存不足以容纳超大模型权重的瓶颈。
报道正文
本文目录8 个章节
我们被问到的最频繁的问题之一,就是如何在 Cerebras 晶圆级芯片上部署大型模型。单块 Cerebras WSE-3T 晶圆拥有 44 GB 的片上内存,而万亿参数的前沿模型仅权重就需要数 TB 的空间。
在这篇文章中,我们将解释如何将一个大型前沿模型拆分到多块 WSE-3T 晶圆上,从而以每秒 1000-2000+ tokens 的速度运行数万亿参数的模型。
我们将使用开源模型 Kimi K3(约 3 万亿参数)作为示例进行说明。
读完本文后,你将了解:
- 我们如何将完整模型装入片上内存
- 我们如何将模型映射到多块芯片上
- 我们如何处理高并发请求
以 Kimi K3 为例拆解分析
Kimi K3 是一个开源的 3T 参数模型,包含 69 层线性注意力层和 24 层密集层。

它在 Terminal-Bench 2.1 上取得了令人印象深刻的 88.3% 得分(对比 GPT-5.6 Sol 的 88.8%),在 BrowseComp 上得分为 91.2%(对比 GPT-5.6 Sol 的 90.4%)。这些结果展示了前沿水平的编码和智能体能力,甚至在某些基准测试中超越了领先的专有模型。在此阅读更多关于 Kimi K3 的信息。

在这个示例中,我们采用以下配置:
- 假设平均请求大小为 256k
- 4-bit 权重量化(类似 Hugging Face 的实现)
- 8-bit KV Cache
#1: 每层的大小
为了计算支持 Kimi K3 所需的 Cerebras WSE-3T 晶圆总数,我们首先计算每个模型层的大小。
Kimi K3 拥有 3 万亿参数。如果所有 3T 参数均以 4 bits 存储,则原始参数数据量为:

将该数据量除以 93 层,得到:

#2: 晶圆数量
既然我们已经知道每一层大约需要 16 GB,就可以计算出每片 44 GB 的晶圆上能容纳多少层。答案取决于层的类型:
- Dense 层需要为 KV Cache 预留额外空间,因为每个 dense(全注意力)层都要存储所有活跃请求中每个 token 的键和值。因此,我们在每片晶圆上放置一个 dense 层,并将剩余的 SRAM 留给其 KV Cache。
- Linear-attention 层不需要为 KV Cache 预留额外空间。与存储每个 token 的键和值不同,linear-attention 层为每个请求维护一个小型、固定大小的状态,无论上下文长度如何。这使得每片晶圆可以容纳两个 linear 层(2 × 16 GB = 32 GB)。
因此,结合 Kimi K3 的 69 个 linear 层和 24 个 dense 层,我们得到:

这使我们得到的总晶圆数为 35 + 24 = 59 片晶圆。
#3: 将晶圆连接起来
Cerebras 以流水线方式执行模型。在 Cerebras 编译器将模型层映射到晶圆的各个区域后,运行时负责规划 token 在晶圆之间流动的路径。为了实现超低延迟,只需在晶圆之间传递激活值(activations),这可以通过基于以太网的 RDMA 完成。每次跳转(hop)的延迟大约为 2 微秒。

需要强调的是,由于每片 Cerebras 晶圆拥有 44 GB 的片上 SRAM,而每一层仅占用 16 GB,我们通常能够将模型的整个层直接放置在芯片上。
这意味着在大多数情况下,模型权重无需移动,层也不需要拆分到不同的晶圆上。只有激活值会从一片晶圆传递到下一片晶圆。
#4: 我们如何处理单个请求
现在我们已经将晶圆连接起来并完成了模型布局,可以将每片晶圆视为装配线上的一个阶段:每个阶段的模型权重保持原位,而请求的中间结果则在各个层阶段之间流动。
例如,Wafer 1 运行模型的第 1–2 层,并将其激活值发送给 Wafer 2。Wafer 2 运行第 3–4 层,并将结果传递给 Wafer 3,依此类推,直到最后一片晶圆生成下一个 token。

#5:我们如何服务大量请求
这引发了一种常见的误解。如果一个 token 必须依次经过每个晶圆,那么在等待轮到它处理时,每个晶圆难道不会处于空闲状态吗?实际上,系统难道不是以 batch size 为 1 在运行吗?
不!如果我们一次只发送一个请求进入流水线,并等待其完成后再开始下一个请求,那将是对流水线的低效利用。相反,我们会让不同的请求填满整个流水线。由于模型已经被划分为多个流水线阶段(pipeline stages),每个阶段可以同时处理不同的请求。
当第 3 阶段正在处理请求 A 的一个 token 时,第 2 阶段正在处理请求 B 的一个 token,而第 1 阶段正在处理请求 C 的一个 token。在我们的示例中,每个阶段对应一层网络。在生产环境中,Cerebras 使用粒度更细的阶段,且数量更多。
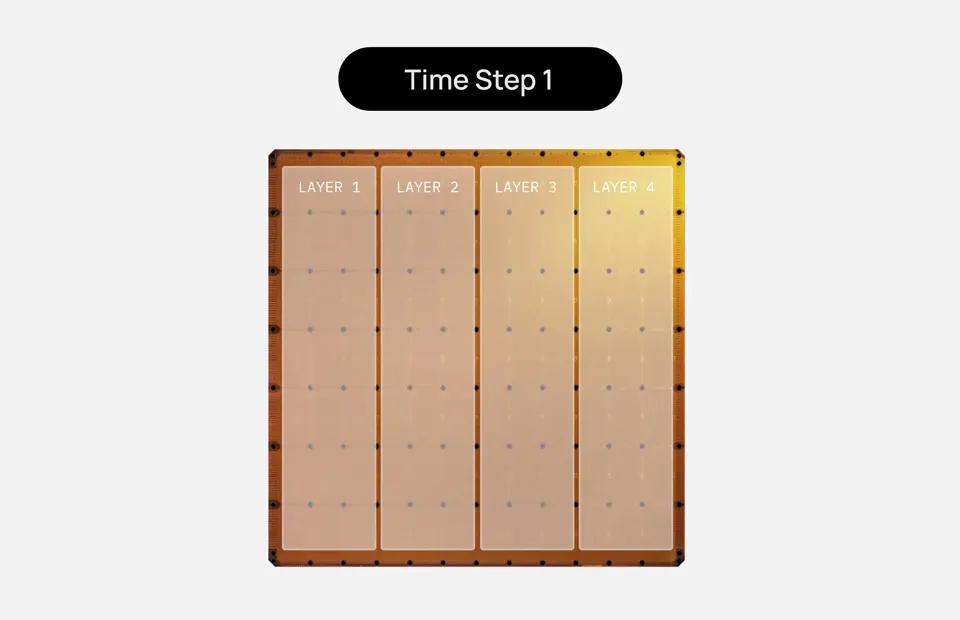
加载播放器...
每个阶段还可以处理一个 micro-batch(微批次),即一组小型请求,而不是单个请求。因此,正在处理的请求数量大致等于阶段数乘以 micro-batch 大小。
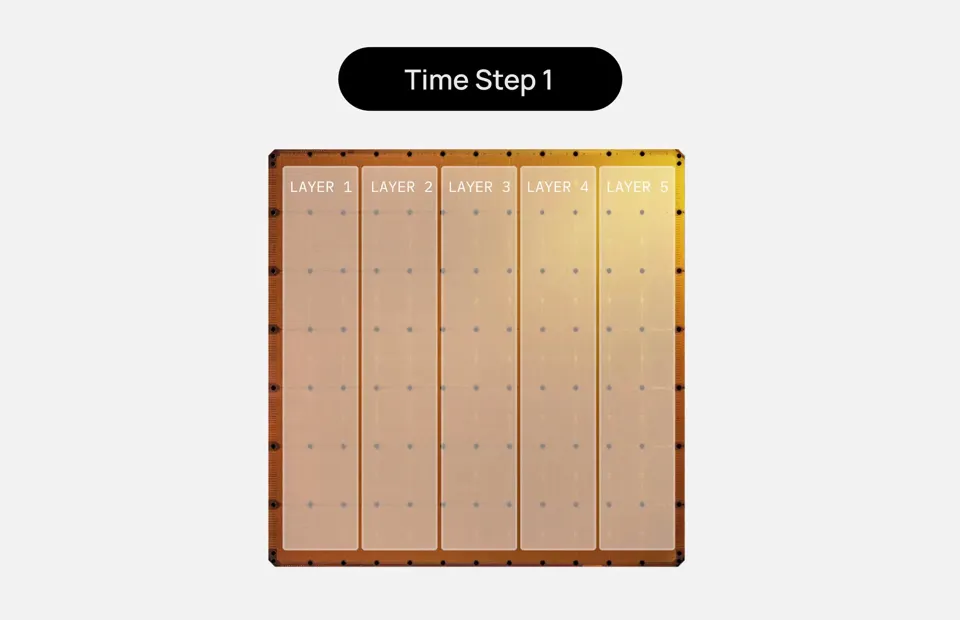
加载播放器...
要理解其中的权衡关系:较小的 micro-batch 能使每个请求的处理速度更快,而较大的 micro-batch 则能提高总吞吐量。
#6:我们可以服务多少个请求?
分配给 KV Cache 的片上内存量决定了最大并发请求数。每个正在处理的请求都需要在每个稠密层晶圆上拥有自己的 KV Cache,因此片上内存的大小设定了并发请求数的上限。如前所述,我们只需要计算稠密层的 KV Cache 需求。
对于每个已经包含一个稠密层的 44 GB 晶圆,我们可以通过以下公式计算用于 KV Cache 的剩余空间:
晶圆总存储容量 - 单个稠密层的大小。在本例中:

计算并发请求数
为了找出特定模型映射所支持的并发请求数量,我们首先计算单个 256k 上下文长度请求所占用的缓存大小:

接下来,为了计算该配置所支持的总并发请求数,我们进行如下除法运算:

总并发请求数表示在任意时间点同时流经处理流水线的请求数量。与 GPU 批次不同,这些请求无需等待彼此完成,而是持续地流式通过流水线。
当然,无论是并发度还是批次大小,都无法确切反映推理系统的执行效率。在评估推理系统的吞吐量时,更具意义的指标是在相同的输出生成速度下,单位功耗的总 Token 吞吐量(例如:每兆瓦每秒生成的 Token 数)。
如何扩展至超过 3T 参数规模
同样的方法可以扩展到更大的模型:计算权重和请求状态所需的内存,将模型分布到多个晶圆上,并将它们连接成流水线。每个额外的晶圆都提供算力和片上内存,从而使我们能够容纳超出任何单芯片容量的模型。
感谢与我们一同学习!有兴趣在 Cerebras 上部署模型或使用我们的推理云进行开发吗?
- 通过我们的免费 API 开始使用:cloud.cerebras.ai
- 联系我们的销售团队:[email protected]
设计由 Halley Chang 完成。感谢 Atharva Talpade、Zhenwei Gao、Angela Yeung、Jessica Liu、Joyce Er、Emma Call 和 Rohan Gupta 的审阅与反馈。