Cloudflare 披露 GLM-5.3 KV Cache 跨请求泄露漏洞
Cloudflare 修复了 Workers AI 平台上 GLM-5.3 模型的租户隔离漏洞,该漏洞导致 155 次长上下文请求意外返回其他用户数据。问题根源在于底层推理引擎 SGLang 的 KV Cache 管理缺陷,目前双方已协同发布补丁并恢复服务。
报道正文
本文目录13 个章节

2026年9月8日,来自Knostic的安全研究员Gadi Evron提醒我们,自2026年8月27日起,GLM-5.3 Workers AI模型(@cf/zai-org/glm-5.3)出现租户隔离问题。我们已修复该问题,并于9月9日恢复了模型。我们已确认,Workers AI上托管的其他模型均未受到影响。
在8月27日至9月9日期间,少数使用GLM 5.3 Workers AI模型的客户收到了包含其他客户在他们之前对同一模型提出请求的数据的回复。共有155个响应受到影响,所有提示都超过681,280个令牌。
排除我们自己和研究人员的测试后,我们发现的请求在时间和数量上与普通的长上下文使用一致,而非有人反复利用漏洞。我们没有发现蓄意剥削的证据。
今天我们将这份报告与我们使用的开源推理引擎SGLang的一篇帖子一同发布,作为协调披露。本文介绍了导致该问题的bug、我们的响应时间表,以及随后对生产版SGLang部署进行的加固。我们还详细说明了与SGLang上游维护者持续合作,修复这些及类似漏洞的努力。
发生了什么
GLM 是来自 Z.ai的文本生成模型,专为代理编码工作流设计;它是通过Workers AI提供的众多模型之一。Gadi Evron于9月8日通过我们的HackerOne项目提交报告称,向Workers AI发送至@cf/zai-org/glm-5.3的超长提示有时返回的文本属于其他用户会话。Cloudflare第二天早上重现了该问题,并在宣布事件后40分钟内将该模型下线。随后我们部署了修正后的配置和补丁推理引擎,并当天恢复了服务。
这次关于跨请求KV缓存暴露的具体报告是两个重叠问题的结果。第一个是 Cloudflare 使用的开源推理引擎 SGLang 配置错误。我们部署了GLM 5.3,拥有1,048,576令牌的上下文窗口,但预填充GPU上的KV缓存池仅能容纳681,280个令牌。我们在发布前就知道这种不匹配。我们预期引擎会对无法处理的提示返回错误,长上下文测试成功响应,因此我们认为这不是问题。
第二个是 SGLang 在分解预填充/解码模式下处理超长请求时的错误。不符合池的提示被内部标记为拒绝,并被一个令牌占位符替换,但预填充没有中止请求并返回客户端错误,而是生成了占位符提示的KV缓存并将其转移到解码节点。译码节点收到“传输完成”消息,并假设预填充覆盖了之前请求中带有完整提示的KV缓存,实际上保留了大部分之前的状态。解码节点随后在处理仍保留早期请求数据的陈旧缓存页面时生成了响应。因此,对超过681,280个令牌的提示响应可能包含其他用户GLM 5.3会话的数据。
立即修复
在禁用该模型后,我们采取了以下措施纠正该漏洞,随后恢复了对公众的访问权限:
为了修复配置,我们让池保留完整的上下文。 我们调整了GLM 5.3配置以匹配GLM 5.2配置,释放了足够的GPU内存,预填充KV池现在大约能容纳204万个令牌,大约是1,048,576个令牌上下文长度的两倍。符合上下文窗口的提示词现在总是符合池,因此有效请求永远不会被拒绝路径。仅此一举措就阻止了细菌的锻炼。
为了修复引擎,我们还让拒绝路径变得安全。 仅依赖池大小是脆弱的:任何对量化、张量并行度、CUDA图大小或未来模型版本的改变都会以一种容易被忽视的方式改变池大小。此外,预填充调度器也可能在其他情况下拒绝请求并触发同样的错误。为防止这种情况,我们还修补了引擎,使得携带待拒绝请求的请求在任何引导、分配或KV传输发生前,会在拆分准入队列中以原始错误状态退休。我们在上游提出了这个方案,称为#38704,同时让译码节点验证传输的代币数量是否与其保留的数量一致。修复修复已经在 SGLang %%MDPH_ICODE_2%(#36988](https://github.com/sgl-project/sglang/pull/36988)中,9 月 6 日合并用于相关故障路径,但尚未发布。维护者还合并了#38935,这在之前拒绝了这些请求,采用了我们的做法。
我们在恢复模型前,对研究人员的复现脚本和我们自己的金丝雀标记测试进行了验证。
背景:我们如何服务GLM 5.3
Workers AI 以分解配置运行 GLM 5.3 和 SGLang:一组预填充 GPU 处理提示并生成模型的 KV 缓存,然后通过 Mooncake通过远程直接内存访问(RDMA)将缓存交给生成响应的解码 GPU 池。我们之前在关于高性能大型语言模型和更小、更快、更安全模型的文章中写过这种架构。
GPU内存中的KV缓存是一个固定大小页面的共享池。每个请求在被允许时分配页面,完成后释放。当前请求之间页面不会被归零;下一个获得页面的请求只是覆盖了它。这种方法在推理引擎中很常见,是实现最佳性能的必要条件,但这意味着推理引擎负责跟踪这些内存页的所有权。KV缓存页面所有权和生命周期跟踪不仅要处理节点内共享所有权(KV缓存卸载和令牌生成对内存的访问寿命不同),还要处理技术上与远程预填充节点共享的所有权(该节点同时对页面有可变引用)。
此外,该池的大小不是配置值。SGLang 在启动时根据加载模型权重后剩余的 GPU 内存来确定大小。模型宣传的上下文长度是一个独立的配置值。没有什么强迫两者必须同意,我们的职责就是监督他们是否同意。
第一期:配置错误
在我们配置的GLM 5.3预填充节点上,池共计681,280个token,而模型的上下文长度为1,048,576个token。选定的KV池大小会由SGLang在启动时以日志形式打印,并作为指标公开。我们知道这种尺寸不匹配;但在发布前测试中,我们观察到HTTP状态码成功运行,且在基准测试中流体中没有错误帧。我们假设引擎能够通过流式传输或其他机制优雅地处理KV缓存池与请求的上下文窗口之间的差异。
这是我们测试中的一个关键空白:我们只验证了 HTTP 响应代码和引擎性能,且未验证模型输出和一致性。我们现在会在任何拆分的部署变更发布前,直接从运行引擎中核对KV池大小与上下文长度,而不是从响应代码推断出来。
第二期:SGLang bug(星光虫)
在 v0.5.21 中,SGLang 团队已经解决了处理超过 KV 池大小提示时的这个漏洞。事情是这样的。
当出现一个提示超出 KV 池容量时,SGLang 的调度器拒绝了它。拒绝路径(Req.set_finish_with_abort)记录返回给客户端的错误,并将提示符替换为一个令牌占位符,使请求能通过正常批处理机制进行清理,而无需分配真实内存。在单节点部署中,这种方法可行:占位符运行,批处理完成,客户端收到错误。

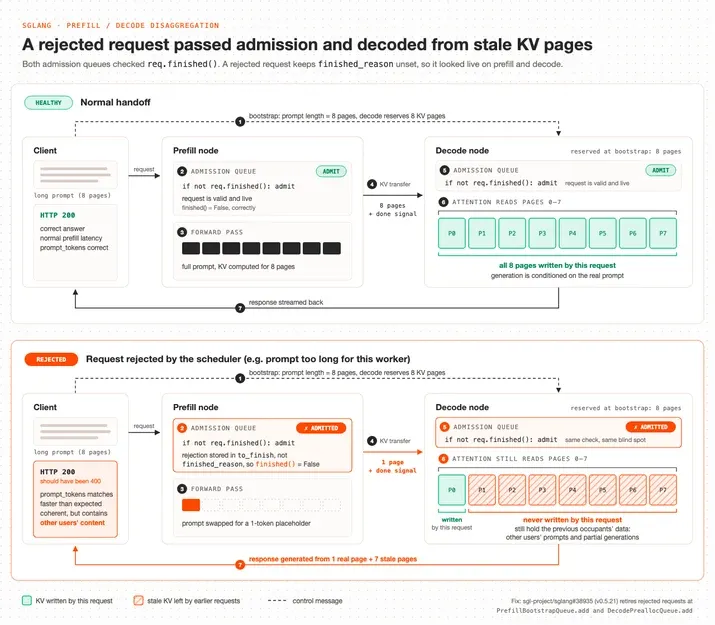
在我们操作的拆分模式下,预填充和解码的准入队列检查请求是否已完成,而非是否拒绝。一个被拒绝的请求显示为在线。所以:
- Bootstrap。 路由器告诉解码节点提示符长度(图中8页)。Decode为该请求预留了8 KV页。
- 预填充录取。 预填录入队列接受任何
req.finished()为虚假的请求。被拒绝的请求会以to_finish存储拒绝,而非finished_reason,因此finished()仍然返回 False。被拒绝的请求被接受。 - 预填前向传递。 拒绝已经用一个令牌占位符替代了提示。Prefill 对那个代币做了一个简单的前传。
- KV 传输。 预填充发送一页 KV 进行解码,并表示传输完成。
- Decode admission。 Decode 的 admission 队列也有同样的
finished()检查,因此接受了切换。 - 解码注意力。解码开始生成并读取全部8页保留页面。这个请求只有P0页写成。P1到P7页仍保留了之前请求留下的内容:其他用户的提示和部分生成。
- 响应。 客户端获得了 HTTP 200 而非 HTTP 400。
prompt_tokens符合长提示,回复也很连贯。它比一个8页的预填充更快到达,并且包含了其他用户的KV页面内容。
每次超过阈值的请求都是这样表现的。该漏洞于2026年7月6日由另一用户向SGLang报告,称为问题#30233,Cloudflare在调查此事件时注意到了。自从 v0.5.10 起,我们就一直在标记 SGLang 这类问题,这次安全事件加速了 Cloudflare 与 SGLang 团队合作已开始的工作。该问题的补丁在 SGLang v0.5.20 发布,后续版本在 v0.5.21 和 v0.5.22 中发布,且所有依赖 SGLang 的其他运营商均可使用。我们强烈建议所有运营商将 SGLang 依赖系统更新到 v0.5.22 或更高版本。有关具体PR的更多细节,请继续阅读。
GLM 5.3是唯一受此漏洞影响的型号。Workers AI上其他所有拆分部署的KV池在预填充和解码时都大于上下文长度,因此没有请求能到达拒绝路径。我们已将引擎修复和以下加固应用到SGLang服务的每个模型上,部署检查也要求每次新部署都采用这些检查。
时间线
所有时间均为协调世界时。
| 当 | 什么 |
|---|---|
| 2026年8月27日 | GLM 5.3 在 Workers AI 上发布时,预填充的 KV 池比上下文窗口还小。这种曝光从发射起就存在。 |
| 2026年9月8日 - 23:11 | 报告通过HackerOne收到。 |
| 2026年9月9日 - 08:00 | Cloudflare开始核实HackerOne的报告。 |
| 2026年9月9日 - 13:22 | 宣布安全事件。产品安全部门在25分钟内通过两个独立账户重现了泄露事件。 |
| 2026年9月9日 - 14:00 | 确认问题范围后,GLM 5.3 被设置为私密。请求返回HTTP 400。状态页面已更新。 |
| 2026年9月9日 - 14:35 | 根本原因被发现是预填充池长度小于上下文长度。金丝雀预填充节点,池更大,已确认不易受影响。 |
| 2026年9月9日 - 14:52 | 所有预填充节点都滚到了修正后的配置。 |
| 2026年9月9日 - 19:04 | 完整部署重建后,基于修正后的配置,并加入了Cloudflare编写的引擎补丁,能正确返回被预填充调度器拒绝的请求错误。已与研究者的复制脚本相符。 |
| 2026年9月9日 - 19:40 | 模型已恢复公开。 |
| 2026年9月10日 - 23:30 | 与SGLang维护者(RadixArk的CTO和核心工程师)会面,商讨上游修复方案。 |
| 2026年9月11日至19日 | 所有生产型SGLang部署都进行了额外加固(详情见下文)。 |
|2026年9月16日-10月12日 |上游SGLang合并准入修复、每次传输校验和、中止确认保留,并默认开启延迟的KV释放。| |2026年10月2日 |SGLang v0.5.21 发布。| |2026年10月19日 |SGLang v0.5.22 发布。| |2026年10月26日 |与研究人员及RadixArk协调发表。|
正在进行的硬化工作
该漏洞属于一类KV缓存内存安全漏洞,Cloudflare已努力修复数月。在每种情况下,页面被释放、重复使用或阅读,而其他内容仍然对该页面有权利。我们看到两个共同原因。
第一个是单节点内的页面生命周期。解码节点上的多个任务可以同时持有同一页面:令牌生成、卸载到主机内存、KV传输接收器,以及中止和错误路径。如果其中一个在另一个仍在使用时释放了该页面,可以在页面仍在阅读或写入时重新请求该页面。我们之前针对解码卸载的修复(#24226、#30899)和语法错误的双重释放(#30937)就是这种类型的修复。
第二种是跨节点竞赛。当请求在预填充还在写入其KV缓存以通过RDMA解码时被中止,已发送的写入无法被召回。如果解码立即释放了这些页面,这些页面可以分配给另一个请求,而迟到的写入则会落入该请求的 KV 缓存中。Cloudflare通过提出的修复方案(#31357、#38961)和重现脚本(#32564)为修复该竞赛做出了贡献。无论哪种情况,结果都是输出损坏,或是某用户的数据出现在另一用户的回复中,且未引发错误。这次事件的bug不同:每次拒绝请求都会通过切换,而不是时机意外。但结果是一样的:解码读取该请求从未写入的页面。这些都没有涉及这次预填拒绝请求且解码未获知的失败。
自事件发生以来,我们有:
- 延长延迟释放,同时保留预填充的源页,涵盖所有失败类型,而不仅仅是中止。我们上游提出为#38961,后来被#40645、#41402和#41404取代。
- 部署有界的月饼传输批次(#32758社区,因此没有单次传输调用能超过发布超时。
- 更改了负载均衡器,使得客户端断开连接不再在传输中途终止请求。它会保留预填充连接直到预填充结束,解码连接直到第一个令牌结束,然后关闭两个标记。
- 为每个拆分的部署变更添加检查:根据上下文长度测量 KV 池大小、两个角色的延迟发布、发布超时内的传输批次边界,以及所有必要的补丁已应用。
所有这些变化都已发布到我们的细分生产部署中。
与SGLang团队合作
事件发生的第二天,我们在9月10日,也就是事件发生的第二天,在RadixArk与SGLang维护人员会面。我们同意RadixArk将调查我们报告的竞赛条件,向上游处理完整性检查的想法,并为这类漏洞构建重现测试。
以下内容已提交至 SGLang %MDPH_ICODE_10%%,以解决此次事件及相关的 KV 缓存竞赛条件,除其中一项外,其他均已纳入 v0.5.22。运行拆分 SGLang 的操作员应更新到 v0.5.22,或根据需要回移植这些补丁。
| 类别 | 拉取请求 | 发布 | 它的作用 |
|---|---|---|---|
| 事件 | #36988 | v0.5.20 | 在结果到达解码前,已退役了预填充请求。这样就能阻止这次事件的暴露。 |
| 事件 | #38935 | v0.5.21 | 在允许时拒绝这些请求,在任何自举、分配或KV转移之前。遵循Cloudflare草稿补丁#38704的做法。 |
| 种族 | #39461, #41612 | v0.5.21, v0.5.22 | sgl-router在客户端断开连接或预填充失败时取消请求的两半。 |
| 种族 | #37454, #41023 | v0.5.20, v0.5.21 | 只在支持延迟的后端启用延迟 KV 发布,然后默认开启。 |
| 种族 | #40645, #41402 | v0.5.21 | 修复了漏电确认丢失的情况,这样释放可以在确认时进行,而不是等待超时。 |
| 种族 | #41404 | v0.5.21 | 每次传输失败都会保留页面,而不仅仅是解码发起的中止。 |
| 种族 | #41618 | v0.5.21 | 修复了中止通知路径的倒退问题。 |
| 种族 | #43719 | v0.5.22 | 失败的月饼发送不再报告写入耗尽。 |
| 种族 | #37077 | v0.5.22 | 标签会在每个请求中止消息,这样重复使用的ID就不会消耗过时的确认。增加了MORI支持。 |
|种族 |#36612 |v0.5.20 |在 Mooncake、NIXL 和 MORI 上共享预填充到解码的失败通知。|
|种族 |#32758 |v0.5.20 |对 Mooncake 传输批次大小设有可选上限,因此一次超时调用不能留下无限数量的写入。|
|终身 |#30899 |v0.5.21 |解码会等待正在卸载的内存托管后,才撤回请求并释放其页面。作者:Cloudflare。|
|终身 |#43562 |v0.5.22 |当主机内存缓存恢复失败时,保持张量并行秩一致。|
|可观测性 |#39500 |v0.5.21 |添加 --disaggregation-enable-kv-checksum%:解码在生成前验证传输的 KV 校验和。#39729的清理,已合并并等待发布。|
|可观测性 |#38596, #40642 |v0.5.20, v0.5.21 |修复SGLang的KV canary,该工具检测并记录潜在的损坏。|
|可观测性 |#41128 |v0.5.22 |延迟释放的指标包括计数、持续时间,以及每次保留是否在确认排水或超时结束。|
这些后续工作仍在进行中:
- [#39729](https://github.com/sgl-project/sglang/pull/39729 额外清理
--disaggregation-enable-kv-checksum。合并,等待释放。 - 发布时零KV页面,草案提案:#46435
- 将KV校验和验证从预填充到解码切换扩展到每一步译码(见下文“结构完整性”)
- 更广泛的KV Canary和KV校验和模型及功能支持
我们给其他运营商的建议
如果你以拆分预填充/解码模式运行 SGLang,我们建议以下方法:
- 测量你的KV池,并将其与上下文长度进行比较,在引擎启动日志中,每次权重、量化、并行或内存分数变化后,对应每个预填充和解码节点。如果池子较小,可以缩短上下文长度以适应。不要依赖代理来强制执行该限制,也不要假设引擎会拒绝不匹配的内容。这是我们没有执行的检查。
- **升级到包含#36988和#38935(v0.5.22或更高版本)的构建,因此无论池大小,超长请求都会在切换前被拒绝。这是发动机侧的修复,也是当你第一步检查错误时的备用防滑器。
- 在两个角色上都使用延迟的 KV 发布(默认设置在 #41023之后),并且绑定你的 Mooncake 传输批次,确保一次超时调用不会留下无界的写入尾部。
- 在模型支持腐败检测的地方开启。 %%MDPH_ICODE_14%和
--kv-canary尚未覆盖所有模型架构。查看日志,确认请求是否被核实。我们正与SGLang团队合作,将这两种检查扩展到更多架构,包括GLM 5.3、GLM 5.3 Flash和DeepSeek V4。 - 确保你的代理没有产生不必要的中止。配置你的负载均衡器,允许请求继续到第一个令牌,这样你就不会触发需要跨节点协调的中止。
长期
结构上的完整性
配置检查和生命周期修复可以减少页面被滥用的次数。它们并不意味着滥用是不可能的,这次事件提醒我们,下一个虫子将会有我们未曾见过的形状。持久的解决方案是,引擎在读取时检测到请求即将处理它不拥有的页面,并拒绝该请求,而不是返回他人的数据。
我们在夏天制作了一个原型,并在八月进行了描述(https://blog.cloudflare.com/smaller-faster-safer-models/)。每个物理 KV 页面都带有一个标签,当页面重新分配时该标签会变化,每个请求记录它期望的标签,并且在解码读取缓存前检查映射。在我们的测试中,吞吐量和尾部延迟的成本低于1%。我们在八月中旬在GLM 5.2上测试过,但不久后因可靠性问题禁用了它。
原型还绑定了特定的注意力后端和模型架构,因此无法成为通用修复。我们正在与SGLang团队合作,将一个适用于所有模型的生产版本集成到引擎中,而不是维护Cloudflare专属的补丁。#39500中的每次传输校验码是第一步:它验证从预填充到解码的切换。页面级标签更胜一筹,因为它们会检查每一次阅读,包括传输很久之后仍能读取的阅读。
数学不可能实现的完整性
RDMA直接将数据从一个节点的内存复制到另一个节点的。两台机器必须就数据的去向、大小以及何时完成达成一致;任何不匹配都可能导致接收端读取错误的数据。该漏洞是分布式系统中一致性失败的一个例子,两台机器对该系统状态的视图不一致。
在Cloudflare的其他地方,我们也努力通过正式验证方法证明分布式系统的安全性。黄玉使我们的权威DNS服务器能够实现无冲突的IP选择。Meerkat的QuePaxa实现模型显示存在一致性错误,随后被修复。
我们现在将在形式方法方面的经验应用于KV缓存传输引擎。这将从建模和验证基于RDMA的KV缓存传输协议的安全性开始。目标是用 Mooncake 建模我们的生产 SGLang 分布式 KV 缓存系统,然后跟踪并修正任何与我们想要保证的安全属性的偏差。目的是尽可能证明类似的漏洞不会再次发生。现实中,我们预期证明者能告诉我们的信息会有空白,但证明系统其他部分让我们能够更仔细地审查和监控这些空白。
协调披露
我们发布本报告作为协调披露的一部分。我们要感谢研究员Gadi Evron,他通过我们的HackerOne程序提供了清晰且可复现的脚本,并给了我们时间修复问题,并在发布前与SGLang维护者协调。我们还要感谢RadixArk的SGLang团队,他们把这个问题当作自己的问题和我们的问题,并紧急地完成了上游修复。